

Purged cross-validation และ embargo: ป้องกัน label leakage ในโมเดลเทรด
เรียนรู้วิธีตรวจสอบ time series การเงินเมื่อช่วงเวลาของ forward label ซ้อนทับกัน และความต่างระหว่าง purging, embargo, walk-forward, TimeSeriesSplit และ CPCV
ในคู่มือนี้เหตุใดการแบ่ง fold แบบสุ่มจึงอาจทำให้ผลคลาดเคลื่อน?
สรุปสั้น
เมื่อช่วงผลลัพธ์ของ forward label ซ้อนทับกัน การแบ่งข้อมูลแบบสุ่มอาจทำให้ข้อมูลรั่วระหว่างชุด train กับ test ได้ Purging จะนำ sample ในชุด train ที่ช่วงผลลัพธ์ซ้อนกับชุด test ออก ส่วน embargo คือช่วงเว้นแยกต่างหากหลังบล็อก test ในบางวิธีแบ่งข้อมูล ทั้งสองอย่างไม่ได้ทำให้ลำดับเวลาเป็น chronological หรือแก้การสร้าง feature ที่ใช้ข้อมูลผิดเวลาโดยอัตโนมัติ
เหตุใดการแบ่ง fold แบบสุ่มจึงอาจทำให้ผลคลาดเคลื่อน?
Random K-fold สุ่มแบ่งแถวข้อมูลลงใน fold สำหรับ train และ test ในข้อมูลการเงินอาจทำให้ผลคลาดเคลื่อนเมื่อ observation พึ่งพากันหรือช่วงผลลัพธ์ในอนาคตซ้อนทับกัน label ของ sample ในชุด train อาจรวมผลตอบแทนจากวันที่อยู่ใน label ของ sample ในชุด test ด้วย ทำให้การตรวจสอบง่ายกว่าการคาดการณ์ช่วงอนาคตที่ยังไม่เคยเห็น
อย่างไรก็ตาม การใช้ K-fold ไม่ได้ผิดทุกกรณี ความเหมาะสมขึ้นอยู่กับคำถามที่ต้องการประเมิน วิธีสร้าง sample การพึ่งพาตามเวลา และนิยาม label การสุ่มแถวผลตอบแทนรายวันอย่างเดียวไม่ได้ตรวจสอบช่วงเวลาที่แถวเหล่านั้นแทนอยู่
กำหนดเวลาตัดสินใจ feature และช่วงของ label
สำหรับแต่ละ sample ให้บันทึกเวลาตัดสินใจ t ข้อมูลที่มีอยู่จริง ณ เวลานั้น ช่วงหน้าต่าง feature ช่วง target/label และเวลาสิ้นสุดที่ label สรุปผลได้ t1 หาก label เป็นผลตอบแทนล่วงหน้าห้า session ช่วงเวลาคือ (t,t+5] เริ่มหลังเวลาตัดสินใจและสิ้นสุดเมื่อ session ที่ห้าปิด
feature ทุกตัวต้องใช้ข้อมูลที่มีอยู่จริง ณ เวลาทำนาย t การที่หน้าต่าง feature สองชุดใช้ประวัติในอดีตร่วมกันไม่ได้เป็น leakage โดยตัวมันเอง โมเดลอาจใช้ประวัติตลาดที่รู้อยู่แล้วซ้ำได้ แต่การใช้ค่าจากอนาคตหรือข้อมูลฉบับแก้ไขที่เพิ่งเผยแพร่หลังเวลาตัดสินใจถือเป็น leakage เก็บ timestamp เริ่มและจบของแต่ละเหตุการณ์ตามจริง โดยเฉพาะเมื่อ label ของแต่ละเหตุการณ์มีระยะเวลาไม่เท่ากัน
นำ sample ในชุด train ที่ผลลัพธ์ซ้อนกับ test ออก
Purging จะนำ sample ในชุด train ออกเมื่อช่วง outcome/label จริงซ้อนกับช่วง outcome ของ sample ในชุด test ต้องเปรียบเทียบช่วงเวลาจริง ไม่ใช่ลบจำนวนแถวคงที่ที่เลือกตามสะดวกบริเวณขอบ fold หาก event label มีระยะเวลาไม่เท่ากัน ให้ใช้ timestamp เริ่มและจบจริงของแต่ละเหตุการณ์ ไม่ใช้จำนวนแถวคงที่แทน
บทที่ 7 ของ Advances in Financial Machine Learning โดย Francisco López de Prado อธิบาย cross-validation และ purging เพื่อจัดการข้อมูลที่ซ้อนทับกัน การนำ label ที่ซ้อนกันออกไม่ได้ทำให้ split เป็น chronological โดยอัตโนมัติ เพราะ train อาจยังมี observation หลังบล็อก test อยู่ ระบุให้ชัดว่า split ตอบคำถามใด อย่าเรียกทุก fold ว่าเป็นการจำลองการนำไปใช้ในอนาคต
ตัวอย่างราย session สำหรับตรวจช่วงที่ซ้อนกัน
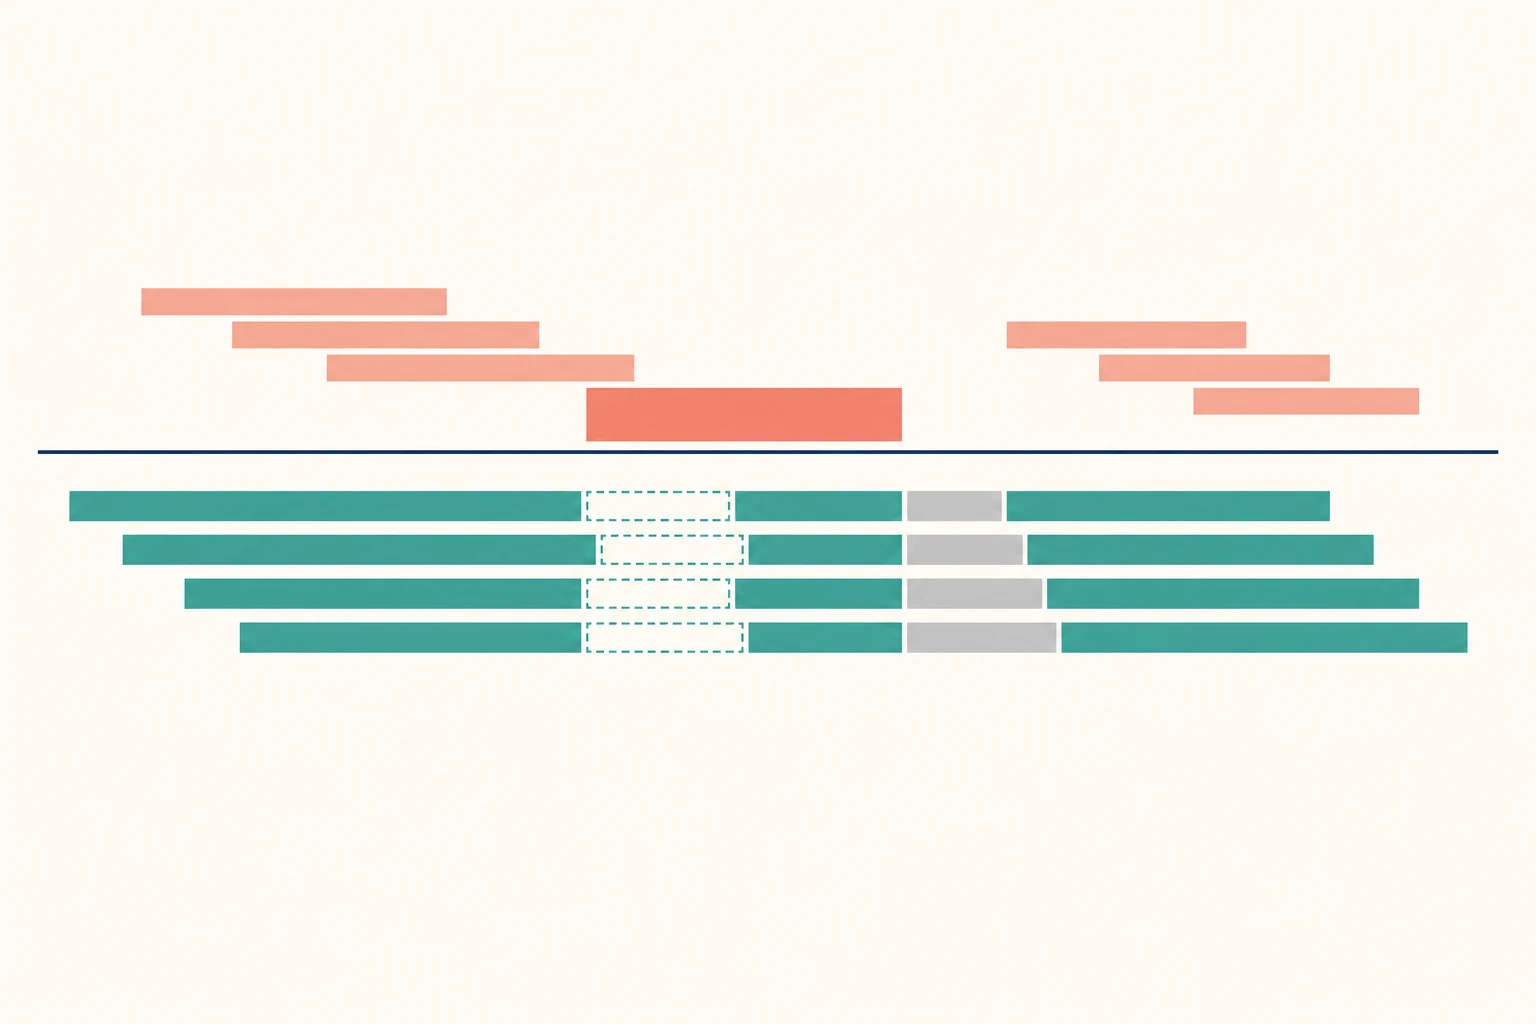
สมมติว่าตัดสินใจทุกวันและ outcome ล่วงหน้าครอบคลุมห้า session หรือ (t,t+5] วันที่ตัดสินใจของบล็อก test คือ 11–15 ดังนั้น label ของ test จึงยาวไปถึงวันที่ 20 ในตัวอย่างนี้ ตัวเลขวันหมายถึง session ซื้อขายที่ต่อเนื่องกัน และรวมปลายขวาของช่วงตามวงเล็บ
label ของ train (7,12] ซ้อนกับ outcome ของ test เช่น label ที่เริ่มวันที่ 11 จึงต้อง purge ออก ช่วง (16,21] ก็ซ้อนกับ label ของ test ที่เริ่มวันที่ 15 และสิ้นสุดวันที่ 20 จึงต้อง purge เช่นกัน การตัดสินใจนี้อาศัยการทับซ้อนของช่วงจริง ไม่ใช่ระยะห่างคงที่ของเลขแถว
label ของ sample ที่อยู่ถัดไปอาจไม่ซ้อนกับ outcome ของ test แต่ยังถูกตัดออกได้หากอยู่ใน embargo แยกต่างหากหลังบล็อก test นี่เป็นตัวอย่างตามสมมติฐานที่ระบุ ไม่ได้กำหนดความยาว gap ที่ใช้ได้กับทุกข้อมูลหรือทุกกลยุทธ์
ใช้ embargo เป็นช่วงเว้นแยกพร้อมเหตุผลรองรับ
Embargo คือช่วง buffer ที่กำหนดหลังบล็อก test ก่อนอนุญาตให้ observation ที่มาทีหลังเข้าไปอยู่ในชุด train สำหรับ split ที่ใช้ข้อมูลทั้งก่อนและหลังช่วง test ได้ ช่วงนี้อาจลดการพึ่งพาที่ยังเหลือจากการสร้าง event หรือ feature แม้ label ของ sample ที่ตามมาจะไม่ซ้อนกับ label ของ test โดยตรง
ไม่มีเปอร์เซ็นต์หรือระยะเวลาสากล และ embargo ไม่ได้แทนการตรวจช่วง label จริง เลือกความยาวจากความถี่ sampling, horizon ของ label, วิธีสร้าง feature และลักษณะการพึ่งพาที่ต้องการลด พร้อมบันทึกเหตุผล ช่วงที่ยาวเกินไปอาจตัดข้อมูล train ที่มีประโยชน์ ส่วนช่วงที่สั้นเกินไปอาจยังเหลือการพึ่งพาที่สำคัญ
เปรียบเทียบวิธี validation ตามคำถามที่ต้องการตอบ
Random K-fold สุ่มกระจาย observation ไปตาม fold เมื่อข้อมูลพึ่งพากันหรือ label ซ้อนทับกัน วิธีนี้อาจไม่เหมือนการทำนายช่วงเวลาที่ตามมา Walk-forward หรือ rolling-origin train ด้วยข้อมูลอดีตและ test ในบล็อกเวลาถัดไป แล้วเลื่อนขอบเขตไปข้างหน้า จึงใกล้เคียงการจำลองการนำไปใช้ตามลำดับเวลาในอดีตมากกว่า แต่ไม่ได้ป้องกัน feature leakage หรือการเลือกโมเดลจากข้อมูล test โดยอัตโนมัติ
TimeSeriesSplit ของ scikit-learn สร้าง split ตามลำดับเวลา และตัวเลือก gap จะเว้นจำนวนแถวที่กำหนดระหว่าง train กับ test เอกสารทางการ ระบุว่าการเปรียบเทียบระยะเวลา test สมมติว่า observation เว้นช่วงเท่ากัน; gap นับจำนวนแถว ไม่ได้ตรวจช่วงเวลาของ event ที่ยาวต่างกัน Purged K-fold นำ label ที่ซ้อนจริงออก แต่อาจ train ด้วยแถวหลังบล็อก test ได้ ส่วน combinatorial purged CV (CPCV) ผสมกลุ่ม test เพื่อสร้างเส้นทางทดสอบหลายเส้น แต่ไม่ได้กลายเป็นการจำลองประวัติแบบ chronological และไม่ได้ลบ leakage ประเภทอื่น
บทที่ 12 ของ Advances in Financial Machine Learning กล่าวถึงวิธี walk-forward และ CPCV พร้อมบริบทการใช้งาน
ตรวจแหล่ง leakage นอกช่วง label ด้วย
ผล validation ยังคลาดเคลื่อนได้หาก timestamp ของ feature ไม่ถูกต้องหรือ feature ใช้ข้อมูลอนาคต ฐานข้อมูลปัจจุบันอาจมีข้อมูลฉบับแก้ไขภายหลังหรือเหลือเฉพาะหลักทรัพย์ที่ยังอยู่รอด การทำ preprocessing หรือเลือก feature จากข้อมูลทั้งหมดก่อนแบ่ง fold ก็ทำให้ข้อมูล test รั่วเข้า train ได้
การลองโมเดลหรือกลยุทธ์หลายแบบแล้วรายงานเฉพาะผลที่ดีที่สุดเพิ่ม selection bias แม้ช่วง label จะไม่ซ้อนกัน Backtest ที่ไม่คิดต้นทุนซื้อขายหรือสมมติว่าคำสั่งได้ราคาและปริมาณที่ไม่สมจริงอาจทำให้ผลสูงเกินจริง Bailey และผู้ร่วมวิจัยวิเคราะห์ความเสี่ยงของการเลือกผลที่ดีที่สุดจากการทดลองหลายครั้งใน The Probability of Backtest Overfitting การออกแบบ split เพียงอย่างเดียวแก้ปัญหาเหล่านี้ไม่ได้
Fit preprocessing และการคัดเลือกภายใน fold สำหรับ train
ในแต่ละ fold ให้ fit transformation การเลือก feature และการเลือก parameter ด้วยข้อมูล train เท่านั้น ใช้ nested time-aware validation เพื่อประเมินตัวเลือก เพื่อไม่ให้ outer test fold ถูกใช้ทั้งเลือกโมเดลและวัดผลโมเดลในเวลาเดียวกัน
เมื่อกำหนดวิธีเสร็จแล้ว ให้กันช่วง chronological สุดท้ายที่ไม่เคยใช้เป็น final holdout หากปรับโมเดลซ้ำตามผลของ holdout ก็ไม่ควรเรียกช่วงนั้นว่าการทดสอบอิสระ Cross-validation วัดผลภายใต้ split และข้อมูลที่กำหนด ไม่ได้รับประกันผลในอนาคต
บันทึกวิธี validation ให้ทำซ้ำได้
บันทึกหน่วยของ sample เวลาตัดสินใจ แหล่ง feature และเวลาที่ข้อมูลนั้นพร้อมใช้ ช่วงของ feature แต่ละตัว และช่วง label จริง (t,t1] อธิบายวิธีแบ่ง fold กฎ purging ตามช่วงเวลา ระยะและเหตุผลของ embargo และจำนวนแถว gap หากใช้ TimeSeriesSplit
ระบุว่า train รวม observation หลังบล็อก test หรือไม่ คิดต้นทุนและ fill อย่างไร และใช้ fold ใดเลือก parameter อ่านเพิ่มเติม: การแลกเปลี่ยนอคติ-ความแปรปรวนและการปรับโมเดลการเงินให้เข้ากับข้อมูลเกินไป, การทดสอบหลายสมมติฐานและอัตราการค้นพบเท็จในตลาดการเงิน, และ การปรับ Sharpe เป็นรายปีเมื่อมีสหสัมพันธ์อนุกรม
คำถามที่พบบ่อย
Q1Random K-fold ใช้กับข้อมูลการเงินไม่ได้เลยหรือไม่?
ไม่เสมอไป หากตรงกับคำถามประเมินและโครงสร้าง sample ก็อาจใช้ได้ แต่การพึ่งพาตามเวลาหรือช่วง outcome ที่ซ้อนกันอาจทำให้ผลคลาดเคลื่อน จึงควรตรวจหน่วย sample และ label ก่อนเลือกวิธี
Q2Embargo ใช้แทน purging ได้หรือไม่?
ไม่ได้ Purging นำ sample ในชุด train ที่ช่วง outcome ซ้อนกับ test ออก ส่วนบาง split ใช้ embargo เว้นช่วงแยกหลังบล็อก test ทั้งสองอย่างมีหน้าที่ต่างกัน และไม่ได้อนุญาตให้ใช้ feature ที่ยังไม่รู้ในเวลาทำนาย
Q3CPCV รับประกันผลการทำงานในอนาคตหรือไม่?
ไม่ CPCV สร้างเส้นทาง test หลายแบบภายใต้แผนแบ่งข้อมูลที่กำหนด แต่ไม่ได้ลบ data leakage การทดลองซ้ำ ความเปลี่ยนแปลงของตลาด หรือความไม่แน่นอนของการส่งคำสั่งในอนาคต
แหล่งข้อมูลและการอ่านเพิ่มเติม
รายงานปัญหา
เราจะเตรียมอีเมลพร้อมลิงก์บทความนี้ Mark จะได้รับรายงานเมื่อคุณส่งอีเมลแล้วเท่านั้น
ตรวจสอบอย่างรวดเร็ว
อ่านคู่มือจบแล้ว ลองตอบคำถาม 3 ข้อ
คำถาม 01
ควรนำ sample ในชุด train ออกด้วย purging เมื่อใด?
เลือกคำตอบเพื่อดูคำอธิบาย
อภิธานศัพท์ออปชัน
The relationship between systematic prediction error from model mismatch and instability caused by sensitivity to the training sample.
อ่านคู่มือฉบับละเอียดFamily-wise error rateThe probability of falsely rejecting at least one true null hypothesis within a predefined family of tests.
อ่านคู่มือฉบับละเอียดAssignmentThe process that requires an option writer to fulfill the contract after an exercise notice is allocated; it can create or remove an underlying position.
อ่านคู่มือฉบับละเอียด