

Regresja MIDAS: dane o mieszanych częstotliwościach i prognozowanie zmienności
Dowiedz się, jak regresja MIDAS łączy dzienne i tygodniowe dane finansowe za pomocą oszczędnej funkcji wag opóźnień, jak zbudować prognozę zmienności i gdzie modele mieszanych częstotliwości mogą wprowadzać w błąd.
W tym przewodnikuMIDAS rozwiązuje problem różnych częstotliwości obserwacji
Krótkie podsumowanie
MIDAS (mixed data sampling, próbkowanie danych o mieszanych częstotliwościach) łączy obserwacje rejestrowane z różnymi częstotliwościami bez wcześniejszego narzucania wszystkim szeregom jednego kalendarza. Kilka estymowanych parametrów określa wagi dla historii obserwacji o wyższej częstotliwości, co może pomóc prognozować finansową zmienną docelową o niższej częstotliwości. Wagi opisują wzorzec predykcyjny w ramach przyjętego modelu; nie dowodzą przyczynowości ani przewagi w tradingu.
MIDAS rozwiązuje problem różnych częstotliwości obserwacji
Dane finansowe i ekonomiczne nie pojawiają się według tego samego zegara. Zmienność docelowa może być mierzona co tydzień, a jej potencjalnymi predyktorami są dzienne stopy zwrotu albo śróddzienne miary zrealizowane. Szereg makroekonomiczny może być kwartalny, podczas gdy cenę aktywa obserwuje się w każdej sesji giełdowej. Zwykła regresja oczekuje jednego wiersza na obserwację dla zmiennej docelowej i predyktorów, więc przed estymacją trzeba zdecydować, jak potraktować różne kalendarze.
Jedną możliwością jest agregowanie dziennych danych wejściowych do średniej lub sumy tygodniowej. To proste, ale narzuca konkretną wagę każdemu dniu i może zatrzeć informację o tym, kiedy w tygodniu wystąpił ruch. Inna możliwość to powielanie wartości kwartalnej w wierszach dziennych albo interpolacja. Powielanie może sprawić, że wolno zmieniająca się liczba będzie wyglądać jak wiele nowych obserwacji; interpolacja może wprowadzić gładką ścieżkę, której nigdy nie zaobserwowano. Żadna z tych operacji nie tworzy nowej informacji.
MIDAS daje bezpośredni sposób łączenia częstotliwości. Zmienna docelowa pozostaje przy swojej naturalnej, niższej częstotliwości, a model uwzględnia uporządkowane opóźnienia szeregu o wyższej częstotliwości. Nazwa odnosi się do mieszanych częstotliwości próbkowania, a nie do jednego modelu zmienności. Regresje MIDAS stosuje się do prognozowania zmienności oraz w innych sytuacjach, gdy predyktory są próbkowane gęściej niż wynik. Główne pytanie brzmi: jak długą niedawną historię wysokiej częstotliwości uwzględnić i jak ograniczyć jej wagi.
Ważone opóźnienie zamienia wiele obserwacji w zwięzły predyktor
Niech \(y_{t+1}\) będzie zmienną docelową o niższej częstotliwości, na przykład wariancją zrealizowaną w następnym tygodniu, obserwowaną po jego zakończeniu. Niech \(x_{t-j}\) będzie predyktorem dziennym obserwowanym \(j\) sesji giełdowych przed początkiem prognozy, na koniec tygodnia \(t\). Prosta regresja MIDAS ma postać \(y_{t+1}=a+b\sum_{j=1}^{K}w_j(\theta)x_{t-j}+u_{t+1}\), gdzie \(K\) to liczba dziennych opóźnień, \(w_j(\theta)\) jest wagą sterowaną niewielką liczbą parametrów, a \(u_{t+1}\) oznacza błąd prognozy.
Wagi często normalizuje się tak, by \(\sum_{j=1}^{K}w_j(\theta)=1\). Dzięki temu sumę można odczytywać jako ważoną historię, a \(b\) określa siłę jej związku ze zmienną docelową. Normalizacja nie oznacza, że obserwacje dzienne są niezależne ani równie informacyjne. To wygodna parametryzacja profilu opóźnień.
Jako \(x\) analityk może wybrać dzienne stopy zwrotu podniesione do kwadratu, stopy bezwzględne, miarę wariancji zrealizowanej obliczoną z intradayowych stóp zwrotu albo inną wartość dostępną na początku prognozy. \(y\) może oznaczać przyszłą wariancję tygodniową, miesięczną publikację makroekonomiczną lub inną zmienną docelową o niższej częstotliwości. Definicja celu przesądza o interpretacji współczynników. Model przybliżenia wariancji zrealizowanej nie jest automatycznie modelem latentnej wariancji chwilowej, wariancji implikowanej z opcji ani stopy zwrotu z ceny.
MIDAS to ogólne ramy regresji, a nie uniwersalny estymator. Odpowiedź można modelować w poziomach, logarytmach albo przez funkcję łączącą; estymacja zależy od wybranej rodziny wag i założeń dotyczących błędów. Liniowa regresja nieujemnego przybliżenia wariancji może dać ujemne wartości dopasowane, jeśli prognoza nie jest ograniczona albo cel nie został przekształcony. Wygoda modelu nie zwalnia z kontroli zakresu i jednostek zmiennej docelowej.
Funkcja wag wymienia elastyczność na stabilność
Nieograniczona regresja z rozłożonymi opóźnieniami szacuje osobny współczynnik dla każdego z \(K\) dziennych wejść. Gdy \(K\) jest duże w stosunku do liczby tygodniowych obserwacji celu, estymaty mogą być zaszumione i silnie skorelowane. MIDAS definiuje zamiast tego współczynniki opóźnień za pomocą funkcji o niewielkiej liczbie wymiarów. Ilustracyjny profil wykładniczy Almona to \(w_j(\theta)=\frac{\exp(\theta_1j+\theta_2j^2)}{\sum_{\ell=1}^{K}\exp(\theta_1\ell+\theta_2\ell^2)}\). Często stosuje się też znormalizowany profil wielomianowy Beta.
Profile mogą nadawać większą wagę nowszym sesjom, stopniowo ją zmniejszać albo względnie mocniej ważyć środkową część okna. Parametry opisują wybraną gładką krzywą, a nie bezwarunkowe znaczenie każdego dnia. Jeśli dane wskazują krótkotrwałą reakcję, lecz przyjęta funkcja wymusza długi, gładki ogon, estymowane współczynniki dziedziczą to ograniczenie. Z kolei szacowanie wielu swobodnych współczynników dziennych może dopasowywać szum zamiast stabilnej dynamiki.
Ograniczenia wag są założeniami modelu. Nieujemne, znormalizowane wagi mogą ułatwiać interpretację prognozy wariancji jako średniej ważonej, ale wykluczają przeciwstawne dodatnie i ujemne efekty opóźnień, które się znoszą. Elastyczny profil może dopuszczać maksimum lub zmienny kształt, lecz zbyt wiele parametrów kształtu może być słabo identyfikowanych. Porównaj kilka uzasadnionych profili, wskaż dostępne opóźnienia i sprawdź, czy prognoza istotnie zmienia się po zmianie rodziny wag.
Nie ma uniwersalnego \(K\). Dłuższe okno może wychwycić trwałą informację, ale dodaje parametry lub wymusza dłuższy profil; krótkie może pominąć wolniejszą dynamikę. Liczbę opóźnień wybieraj na podstawie informacji dostępnych w okresie estymacji i waliduj bez używania przyszłej wartości celu oceny. Sam dobry wynik dopasowania w próbie nie rozstrzyga, czy okno ujmuje powtarzalny sygnał.
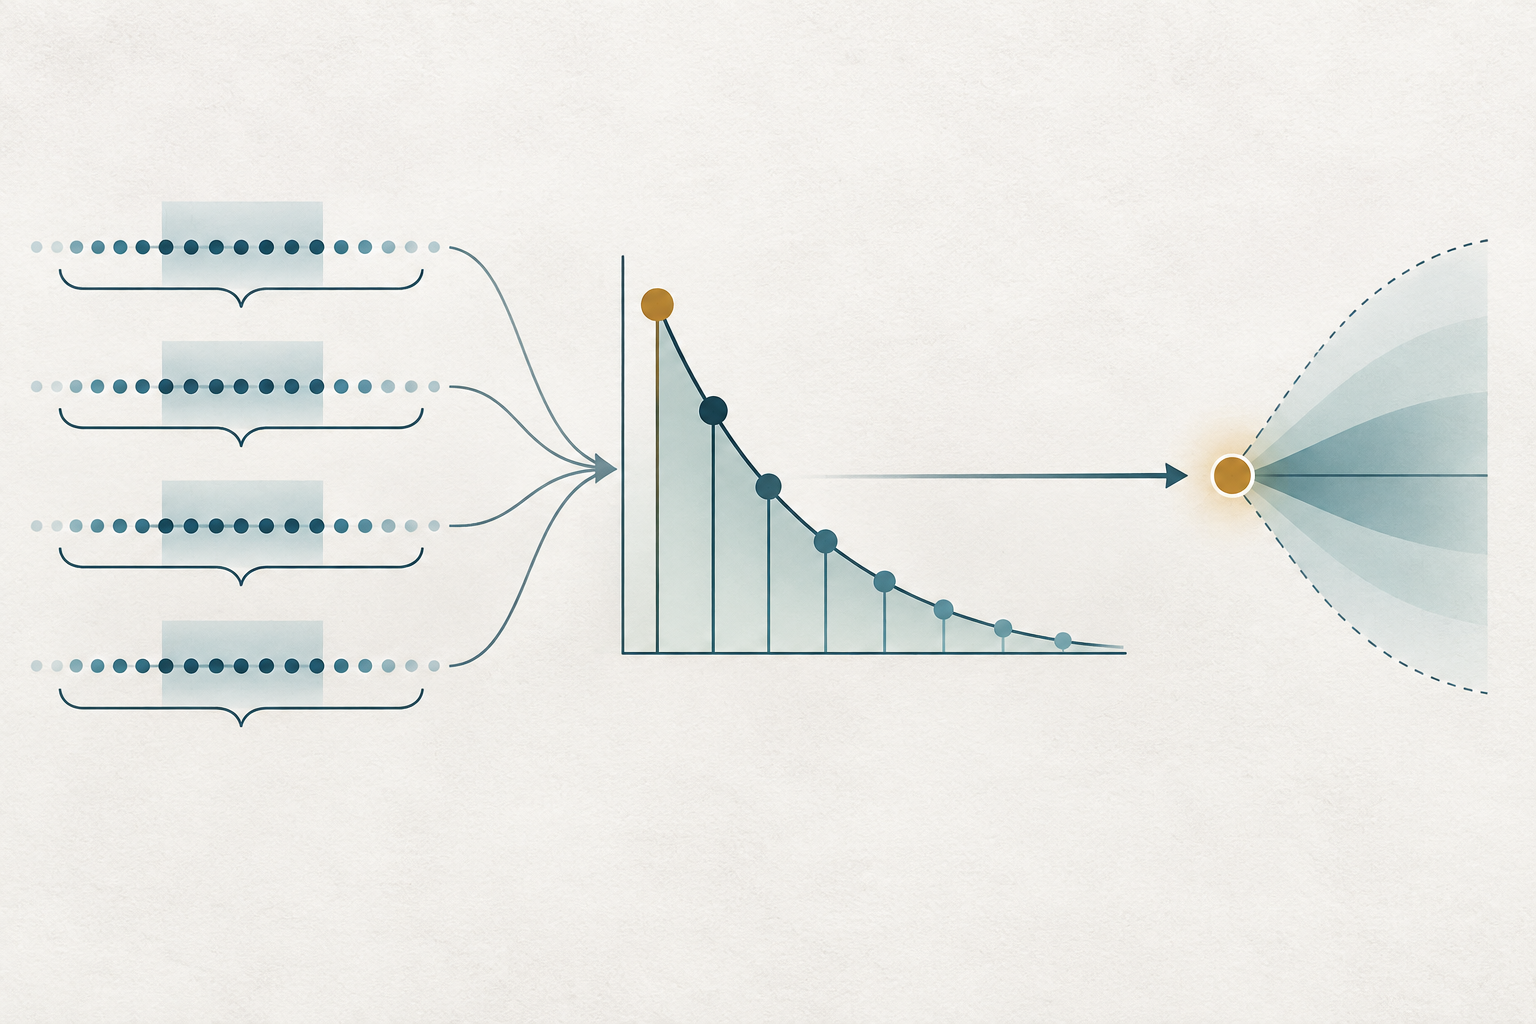
Dopasuj początek prognozy do chwili, w której każda wartość była znana
Same etykiety częstotliwości nie wystarczą do ustalenia poprawnego projektu prognozy. Załóżmy, że celem jest wariancja nadchodzącego tygodnia obejmującego pięć sesji, a prognoza powstaje po piątkowym zamknięciu. Predyktorami mogą być dzienne obserwacje zakończone do piątku, ale nie statystyka wariancji zrealizowanej obliczona z przyszłotygodniowych stóp zwrotu. Tygodniowa lub miesięczna statystyka może zostać opublikowana dopiero po okresie, którego dotyczy. Backtest powinien używać wartości rzeczywiście dostępnej w tamtym momencie, a nie później zrewidowanej lub opublikowanej.
Przed estymacją przygotuj tabelę początku prognozy: kiedy prognoza jest tworzona, jaki jest najpóźniejszy dozwolony znacznik czasu dla każdego predyktora, jaki okres obejmuje cel i kiedy cel staje się obserwowalny. Dla stóp zwrotu określ, czy zwrot od zamknięcia do zamknięcia obejmuje okres nocny, która sesja definiuje dzień i jak święta lub brakujące bary zmieniają liczbę dziennych opóźnień. Pięć sesji giełdowych i siedem dni kalendarzowych to różne przedziały.
Kalendarze publikacji mają poszarpane krawędzie. W danym dniu jeden predyktor może mieć świeżą wartość dzienną, podczas gdy miesięczna seria nie została jeszcze opublikowana. Przeniesienie ostatniej dostępnej wartości miesięcznej może być poprawne, jeśli model traktuje ją jako nieaktualną, ale znaną informację z początku prognozy. Nie wolno uzupełniać jeszcze nieopublikowanej obserwacji późniejszą publikacją. Rewizje historyczne tworzą subtelniejszy problem look-ahead: obecna baza danych może zawierać zrewidowaną serię makroekonomiczną, której nie znałby ówczesny prognosta.
Rynki asynchroniczne wprowadzają kolejny problem dopasowania. Dzienny kurs zamknięcia akcji i kryptowaluty może obejmować różne przedziały UTC; intradayowa miara zmienności może używać barów kończących się po chwili prognozy. Konwersja stref czasowych, zmiana czasu, zamknięcia rynków i konstrukcja barów składają się na zbiór informacji. Opisz, jak sobie z nimi radzisz, zamiast zakładać, że wiersze z tą samą datą mają tę samą godzinę graniczną.
Hipotetyczny przykład zamienia dzienne dane wejściowe w prognozę tygodniową
Załóżmy, że celem jest wariancja zrealizowana w następnym tygodniu, a prognoza powstaje przy piątkowym zamknięciu. Model wykorzystuje pięć dziennych miar wariancji zrealizowanej z właśnie zakończonego tygodnia. Szacowane wagi od najnowszej do najstarszej sesji to \(0{,}40,0{,}25,0{,}16,0{,}11,0{,}08\), a ich suma wynosi jeden. Odpowiadające im dane dzienne w jednostkach stóp zwrotu do kwadratu to \(0{,}0004,0{,}0001,0{,}0009,0{,}0004,0{,}0001\).
Ważona historia wynosi \(0{,}40(0{,}0004)+0{,}25(0{,}0001)+0{,}16(0{,}0009)+0{,}11(0{,}0004)+0{,}08(0{,}0001)=0{,}000381\). W tym hipotetycznym dopasowanym modelu przyjmijmy wyraz wolny \(a=0{,}00012\) i nachylenie \(b=0{,}80\). Prognoza wariancji na kolejny tydzień wynosi \(0{,}00012+0{,}80(0{,}000381)=0{,}0004248\). Jeśli przydatne jest podsumowanie odchyleniem standardowym, jego pierwiastek wynosi około \(0{,}02061\), czyli \(2{,}06\,\%\) w tygodniu celu według przyjętej definicji.
Rachunek ilustruje odwzorowanie dziennych predyktorów na przyszły cel tygodniowy; wartości i oszacowane współczynniki są wymyślone. Nie oznacza to, że którykolwiek z podanych dni spowodował wariancję kolejnego tygodnia ani że cena aktywa wzrośnie lub spadnie. Waga ostatniej sesji pokazuje, jak określony model predykcyjny łączy obserwowane dane wejściowe warunkowo względem próby i ograniczeń. Nie jest estymatą reakcji przyczynowej.
Przykład pokazuje także problem jednostek. Dzienna i tygodniowa wariancja zrealizowana są wariancjami stóp zwrotu, lecz odnoszą się do różnych okresów kumulacji. Nachylenie \(b\), wyraz wolny i konstrukcję celu oszacowano dla dokładnie takiej konwencji; dziennych danych nie można po prostu przemianować na wariancję tygodniową. Jeżeli celem jest logarytm wariancji tygodniowej, prognoza jest w jednostkach logarytmicznych, a jej eksponentowanie zasadniczo nie daje warunkowej średniej wariancji. Powrót do poziomów wymaga jawnego określenia celu prognozy i, w razie potrzeby, korekty retransformacyjnej.
Estymacja zależy od celu i ograniczeń opóźnień
Przy ustalonym wektorze wag regresja jest liniowa względem wyrazu wolnego i nachylenia. Gdy wagi zależą od nieznanych parametrów nieliniowych \(\theta\), często stosuje się nieliniową metodę najmniejszych kwadratów lub pokrewną metodę opartą na wiarygodności. Estymacja może wspólnie szukać parametrów kształtu wag i współczynników regresji albo profilować współczynniki liniowe dla każdej kandydackiej formy. Wartości początkowe, granice parametrów, kryteria zbieżności i lokalne ekstrema mogą mieć znaczenie; nie ukrywaj nieudanej zbieżności ani rozwiązań brzegowych.
Jeżeli \(y\) jest nieujemną miarą zmienności, zwykła specyfikacja liniowa może dawać ujemne wartości dopasowane, zwłaszcza poza próbą. Można zastosować ograniczenia zapewniające nieujemne prognozy poziomów, dodatnią funkcję łączącą albo modelować logarytm celu. Wybór zmienia estymand i interpretację prognozy. W modelu z celem logarytmicznym prognoza warunkowej średniej logarytmu wariancji nie daje automatycznie warunkowej średniej wariancji; znaczenie mają rozkład błędu i retransformacja.
Niepewność próbkowania zależy również od konstrukcji celu. Tygodniowa wariancja zrealizowana z intradayowych stóp zwrotu zawiera błąd pomiaru i może być wrażliwa na szum mikrostruktury, interwał próbkowania, skoki oraz brakujące obserwacje. Jeśli tygodniowe okna celu na siebie zachodzą, błędy prognoz z sąsiednich początków dzielą te same stopy zwrotu. Błędy standardowe i porównania zakładające niezależność błędów prognozy mogą być wtedy nieodpowiednie. Stosuj wnioskowanie dopasowane do horyzontu i struktury zależności oraz raportuj sposób pomiaru celu.
Stabilność parametrów to kolejna kwestia. Oszacowany profil wag uśrednia cały okres estymacji; jeśli struktura rynku się zmienia, krzywa może nie opisywać dobrze żadnego bieżącego reżimu. Okna rozszerzające się i kroczące odpowiadają na różne pytania: pierwsze wykorzystuje więcej historii, lecz zachowuje dawną dynamikę; drugie szybciej się dostosowuje, ale ma mniej obserwacji i większy szum estymacji. Ustal regułę aktualizacji z góry i porównaj ją ze stałą bazą w chronologicznej ocenie.
MIDAS jest powiązany z GARCH-MIDAS, ale nie jest z nim tożsamy
MIDAS oznacza sposób łączenia obserwacji próbkowanych z różnymi częstotliwościami przy użyciu ważonych opóźnień. Regresja MIDAS może bezpośrednio prognozować przyszły cel zmienności zrealizowanej na podstawie wcześniejszych miar dziennych lub intraday. Nie musi określać jednookresowej rekurencji wariancji warunkowej związanej z modelem GARCH.
GARCH-MIDAS to odrębna rodzina modeli łącząca wolno zmieniający się długookresowy składnik zmienności, często napędzany zmiennymi niższej częstotliwości, z rekurencyjnym krótkookresowym składnikiem wariancji warunkowej. Oba składniki mają własną parametryzację i założenia. W artykule lub pakiecie opisanym jako GARCH-MIDAS należy sprawdzić dokładne równania: wagi MIDAS mogą sterować składnikiem długoterminowym, a rekurencja GARCH obsługiwać krótkookresowe szoki. Sama etykieta nie określa celu, nie mówi, czy prognozowana jest zmienność latentna czy zrealizowana, ani jak wymusza się dodatniość.
Pierwotne finansowe prace o zmienności MIDAS porównują różne predyktory, częstotliwości i długości opóźnień w oszczędnym schemacie prognozowania. Późniejsze prace metodologiczne rozwijają własności estymacji i testowania regresji o mieszanych częstotliwościach, w tym porównania z tradycyjną agregacją czasową. Badania te uzasadniają mechanikę, ale nie twierdzą, że MIDAS zawsze przewyższa GARCH ani że predyktory wysokiej częstotliwości zawsze poprawiają prognozy. Wyniki zależą od aktywa, próby, celu, predyktora, horyzontu i projektu oceny.
Wybieraj model zgodnie z pytaniem. Jeśli celem jest prognoza przyszłej miary zmienności zrealizowanej na podstawie historii dziennej, bezpośrednia regresja MIDAS może być naturalnym kandydatem. Jeśli chcesz rekurencyjnie modelować wariancję warunkową, porównaj odpowiednią specyfikację GARCH. Łączenie kwartalnych publikacji makroekonomicznych z dziennym celem finansowym może wymagać kontroli dat publikacji i wersji danych. Modele o podobnych nazwach mogą odpowiadać na różne pytania, więc przed porównaniem wyników zestaw początek prognozy, definicję celu i zbiór informacji.
Błąd pomiaru i selekcja mogą przeważyć nad profilem wag
Dane wysokiej częstotliwości zwiększają szczegółowość czasową, ale mogą też zwiększyć szum pomiarowy. Bardzo krótkie bary zawierają odbicia bid–ask, dyskretność cen, nieaktualne kwotowania, handel asynchroniczny i błędy strumienia danych. Sumowanie kwadratów stóp zwrotu w coraz krótszych odstępach nie gwarantuje lepszej miary wariancji zrealizowanej. Wybierz siatkę próbkowania i reguły czyszczenia przed analizą skuteczności prognozy oraz sprawdź wiarygodne alternatywy.
Ilość informacji ogranicza liczba wyników o niższej częstotliwości, a nie pozorna liczba dziennych wierszy predyktorów. Dziesięć lat dziennych danych połączonych z tygodniowymi celami daje zaledwie około 500 tygodniowych okresów wynikowych przed uwzględnieniem braków i wydzielonej próby oceny. Gładka funkcja wag używa mniej współczynników niż swobodne opóźnienia dzienne, ale jej kształt również może być słabo identyfikowany przy krótkiej próbie, bardzo trwałych predyktorach lub nadmiarowych opóźnieniach.
Wiele decyzji analitycznych tworzy obciążenie selekcyjne: testowanie różnych miar wysokiej częstotliwości, długości opóźnień, profili wag, transformacji, rynków, horyzontów i funkcji straty, a następnie raportowanie wyłącznie najlepszego wyniku. Dopasowanie w próbie jest szczególnie podatne, bo te same wartości docelowe kierują zarówno estymacją parametrów, jak i wyborem modelu. Zapisz testowaną rodzinę modeli, wybierz główną miarę i wykorzystaj późniejszy chronologiczny holdout albo porównanie uwzględniające selekcję. Przy wielu prognozach dla tych samych dat uwzględnij zależność i wielokrotne porównania, zamiast traktować każdy wynik jak niezależne potwierdzenie.
Oszacowana krzywa wag nie stanowi wyjaśnienia przyczynowego. Dane wysokiej częstotliwości mogą być wskaźnikiem wiadomości, płynności lub aktywności rynkowej; nieobserwowane czynniki mogą wpływać i na predyktory, i na przyszłą zmienność. Przydatność prognostyczna wymaga stabilnej synchronizacji czasowej i wyników poza próbą. Interpretacja przyczynowa wymaga odrębnego projektu identyfikacji oraz założeń wykraczających poza równanie opóźnień MIDAS.
Prognoza nie definiuje zyskownej decyzji handlowej
Prognoza zmienności może pomóc w budżecie ryzyka, wielkości zabezpieczenia lub zakresie scenariuszy, ale nie określa znaku stopy zwrotu ani kierunku pozycji. Prognozowane tygodniowe odchylenie standardowe \(2{,}06\,\%\) nie jest obiecaną zmianą ceny, maksymalną stratą ani kwotowaniem zmienności implikowanej z opcji. Opisuje wybraną miarę rozproszenia przy danym modelu i próbie; zrealizowane stopy zwrotu mogą być dużo większe lub mniejsze.
W analizie strategii przed testem określ czas sygnału i zlecenia, instrument, regułę ekspozycji i wyjście. Parametry MIDAS odtwarzaj historycznie wyłącznie z informacji, które byłyby dostępne w każdym ówczesnym momencie prognozy. Oceniaj prognozy względem wcześniej ustalonej bazy i funkcji straty zgodnej z celem, a następnie osobno symuluj stopy zwrotu po uwzględnieniu spreadu, prowizji, finansowania, pożyczania, wpływu na rynek i obrotu. Statystycznie lepsza prognoza zmienności nie musi poprawiać zwrotów po kosztach.
Raport powinien podawać cel i procedurę pomiaru; definicje i jednostki predyktorów; częstotliwości niższą i wyższą; początek prognozy; liczbę opóźnień; funkcję wag i ograniczenia; okno estymacji i harmonogram aktualizacji; obsługę braków i wersji historycznych; funkcję straty; bazę i chronologiczne daty testowe. Pokaż niepewność lub wrażliwość, gdy wybór profilu opóźnień znacząco zmienia wynik. Zobacz także przewodniki o wariancji zrealizowanej, klastrowaniu zmienności i GARCH oraz porównywaniu dokładności prognoz.
Do głównych źródeł pierwotnych należą badanie MIDAS nad prognozowaniem zmienności Ghyselsa, Santa-Clary i Valkanova, przegląd metodologiczny i rozszerzenia Ghyselsa, Sinka i Valkanova oraz analiza modeli regresji o mieszanych częstotliwościach Andreou, Ghyselsa i Kourtellosa. Wyniki empiryczne dotyczą badanych prób i projektów; nie gwarantują wyników na obecnych rynkach ani w innych klasach aktywów.
Częste pytania
Q1Czy MIDAS oznacza uśrednianie wszystkich danych do jednej częstotliwości?
Nie. Regresja MIDAS pozostawia cel w wybranej częstotliwości i wykorzystuje uporządkowane ważone opóźnienia predyktora o wyższej częstotliwości. Nie trzeba interpolować wszystkich szeregów do wspólnego kalendarza wierszy.
Q2Czy regresja MIDAS i GARCH-MIDAS są tym samym?
Nie. MIDAS to schemat ważonych opóźnień dla mieszanych częstotliwości. GARCH-MIDAS łączy składnik długookresowy typu MIDAS z krótkookresową rekurencją wariancji GARCH. Dokładny cel i składniki trzeba sprawdzić w równaniach danego modelu.
Q3Czy dokładniejsza prognoza zmienności MIDAS automatycznie daje sygnał handlowy?
Nie. Prognoza dotyczy wybranej miary rozproszenia. Strategia wymaga osobnej reguły kierunku lub ryzyka, realistycznych kosztów realizacji i chronologicznej oceny zwrotów po kosztach.
Źródła i dalsza lektura
Zgłoś problem
Przygotujemy e-mail z linkiem do tego artykułu. Mark otrzyma zgłoszenie dopiero po jego wysłaniu
Szybki test
Przeczytano? Sprawdź się w 3 pytaniach
Pytanie 01
Jakie jest główne zadanie funkcji wag MIDAS?
Wybierz odpowiedź, aby zobaczyć wyjaśnienie
Słownik opcji
A time-series model that updates conditional variance from past squared shocks and prior variance; it models volatility persistence, not return direction.
Czytaj szczegółowy przewodnikRealized volatilityVolatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
Czytaj szczegółowy przewodnikCausationA relationship describing how an outcome would differ under a specified intervention or counterfactual change; observed association alone does not identify it.
Czytaj szczegółowy przewodnik