

MIDAS-regressie uitgelegd: gegevens met gemengde frequenties en volatiliteitsprognoses
Lees hoe MIDAS-regressie dagelijkse en wekelijkse financiële gegevens combineert met spaarzame laggewichten, hoe je een volatiliteitsprognose opbouwt en wanneer modellen met gemengde frequenties misleidend kunnen zijn.
In deze gidsMIDAS pakt een verschil in waarnemingsfrequentie aan
Korte samenvatting
MIDAS (mixed data sampling) verbindt waarnemingen met verschillende meetfrequenties zonder alle reeksen eerst op één kalender te dwingen. Een klein aantal geschatte parameters weegt de geschiedenis van hoogfrequente waarnemingen en kan zo een laagfrequente financiële doelvariabele helpen voorspellen. De gewichten beschrijven een voorspellend patroon onder het gekozen model; ze bewijzen geen causaliteit of handelsvoordeel.
MIDAS pakt een verschil in waarnemingsfrequentie aan
Financiële en economische gegevens volgen niet dezelfde klok. Een volatiliteitsdoel kan wekelijks worden gemeten, terwijl mogelijke voorspellers dagelijkse rendementen of intraday-gerealiseerde maten zijn. Een macro-economische reeks kan per kwartaal beschikbaar komen terwijl een activaprijs elke handelsdag wordt waargenomen. Een gewone regressie verwacht één rij per waarneming voor doelvariabele en voorspellers. Daarom moet de analist vóór de schatting beslissen hoe met de verschillende kalenders om te gaan.
Een mogelijkheid is dagelijkse invoer samen te vatten tot een weekgemiddelde of -som. Dat is eenvoudig, maar legt voor elke dag een bepaald gewicht vast en kan verbergen op welk moment in de week een beweging plaatsvond. Een andere mogelijkheid is een kwartaalwaarde op dagelijkse rijen te herhalen of te interpoleren. Herhaling kan een langzaam veranderend cijfer laten lijken op veel nieuwe waarnemingen; interpolatie kan een glad verloop invoeren dat nooit is gemeten. Geen van beide handelingen creëert nieuwe informatie.
MIDAS biedt een directe manier om frequenties te verbinden. De doelvariabele blijft op haar natuurlijke, lagere frequentie en de regressie neemt een gestructureerde reeks vertragingen van de hoogfrequentere variabele op. De naam verwijst naar mixed data sampling, niet naar één specifiek volatiliteitsmodel. MIDAS-regressies worden gebruikt voor volatiliteitsprognoses en andere situaties waarin voorspellers fijner worden gemeten dan de uitkomst. De centrale vraag is hoeveel recente hoogfrequente geschiedenis je gebruikt en hoe je de gewichten beperkt.
Een gewogen vertraging vat veel waarnemingen samen in één compacte voorspeller
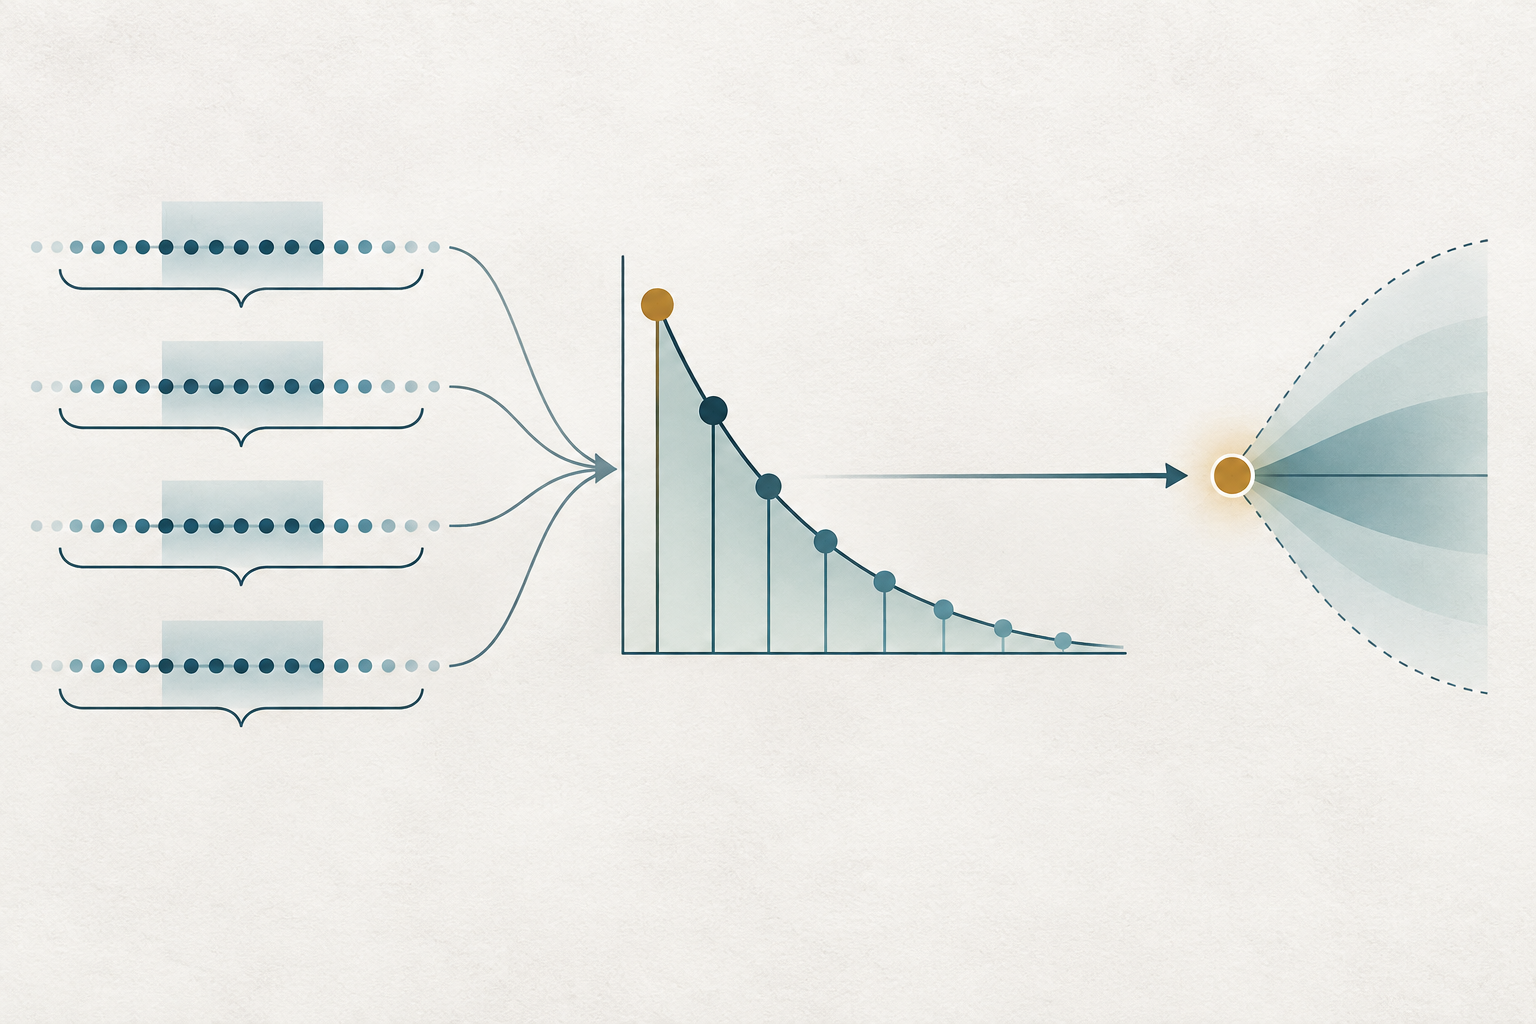
Laat \(y_{t+1}\) een laagfrequente doelvariabele zijn, bijvoorbeeld de gerealiseerde variantie van de volgende week, die pas na die week wordt waargenomen. Laat \(x_{t-j}\) een dagelijkse voorspeller zijn die \(j\) handelssessies vóór het prognosemoment aan het einde van week \(t\) is waargenomen. Een eenvoudige MIDAS-regressie is \(y_{t+1}=a+b\sum_{j=1}^{K}w_j(\theta)x_{t-j}+u_{t+1}\), waarbij \(K\) het aantal dagelijkse vertragingen is, \(w_j(\theta)\) een door enkele parameters bepaald gewicht en \(u_{t+1}\) de prognosefout.
De gewichten worden vaak zo genormaliseerd dat \(\sum_{j=1}^{K}w_j(\theta)=1\). Daardoor is de som eenvoudig te lezen als een gewogen geschiedenis, terwijl \(b\) bepaalt hoe sterk die samenvatting met de doelvariabele samenhangt. De normalisatie betekent niet dat dagelijkse waarnemingen onafhankelijk of even informatief zijn. Het is een praktische parametrisering van het vertragingsprofiel.
De analist kan \(x\) kiezen als dagelijkse rendementen in het kwadraat, absolute rendementen, een maat van gerealiseerde variantie op basis van intraday-rendementen of een andere variabele die op het prognosemoment beschikbaar is. \(y\) kan toekomstige weekvariantie zijn, een maandelijkse macro-economische publicatie of een andere laagfrequente doelvariabele. De definitie van het doel bepaalt wat de coëfficiënten betekenen. Een model voor een benadering van gerealiseerde variantie is niet automatisch een model voor latente instantane variantie, optiegeïmpliceerde variantie of een prijsrendement.
MIDAS is een regressiekader, geen universele schatter. De respons kan in niveaus, logaritmen of met een linkfunctie worden gemodelleerd; de schatting hangt af van de gekozen gewichtenfamilie en foutaannames. Een lineaire regressie van een niet-negatieve variantiebenadering kan negatieve fitted values opleveren, tenzij de prognose wordt begrensd of het doel wordt getransformeerd. Het gemak van het model neemt de noodzaak niet weg om bereik en eenheden van de doelvariabele te controleren.
De gewichtenfunctie ruilt flexibiliteit in voor stabiliteit
Een onbeperkte regressie met verdeelde vertragingen schat een aparte coëfficiënt voor elk van de \(K\) dagelijkse invoerwaarden. Als \(K\) groot is ten opzichte van het aantal wekelijkse doelwaarnemingen, kunnen schattingen ruisgevoelig en sterk gecorreleerd zijn. MIDAS legt de lagcoëfficiënten in plaats daarvan vast met een functie met weinig dimensies. Een illustratief exponentieel Almon-profiel is \(w_j(\theta)=\frac{\exp(\theta_1j+\theta_2j^2)}{\sum_{\ell=1}^{K}\exp(\theta_1\ell+\theta_2\ell^2)}\). Een genormaliseerd Beta-polynoomprofiel is ook gebruikelijk.
Deze profielen kunnen recente sessies zwaarder wegen, geleidelijk aflopen of relatief meer gewicht leggen op een middendeel van het venster. De parameters beschrijven de gekozen gladde curve; ze geven niet zonder meer het belang van elke afzonderlijke dag weer. Als de gegevens een kortdurende respons ondersteunen maar de functie een lange gladde staart afdwingt, erven de geschatte coëfficiënten die beperking. Omgekeerd kan het schatten van veel vrije dagelijkse coëfficiënten ruis volgen in plaats van stabiele dynamiek.
Gewichtsrestricties zijn modelaannames. Niet-negatieve gewichten die optellen tot één kunnen een variantieprognose begrijpelijk maken als gewogen gemiddelde, maar sluiten tegengestelde positieve en negatieve lag-effecten uit. Een flexibeler profiel kan een bult of veranderende helling toelaten, maar te veel vormparameters kunnen zwak geïdentificeerd zijn. Vergelijk een kleine set verdedigbare profielen, vermeld welke vertragingen beschikbaar waren en controleer of de prognose wezenlijk verandert met een andere gewichtenfamilie.
Er bestaat geen universele \(K\). Een langer venster kan aanhoudende informatie oppikken, maar voegt parameters toe of dwingt een langer profiel af; een kort venster kan tragere dynamiek missen. Kies het aantal vertragingen met informatie uit de schattingsperiode en valideer zonder de toekomstige evaluatiedoelwaarde te gebruiken. Een goede fit binnen de steekproef bewijst op zichzelf niet dat het venster een herhaalbaar signaal vastlegt.
Stem het prognosemoment af op wanneer elke waarde bekend was
Frequentielabels volstaan niet om een geldig prognoseontwerp vast te leggen. Stel dat het doel de variantie van de komende vijfdaagse handelsweek is en dat de prognose na het slot op vrijdag wordt gemaakt. Voorspellers mogen dagelijkse waarnemingen bevatten die vrijdag zijn geëindigd, maar geen gerealiseerde variantie berekend uit rendementen van de komende week. Een gepubliceerde week- of maandstatistiek kan later verschijnen dan de periode die zij beschrijft. Een backtest moet de waarde gebruiken die toen werkelijk beschikbaar was, niet een later herziene of gepubliceerde waarde.
Maak vóór het fitten een tabel van het prognosemoment: wanneer de prognose wordt gemaakt, het laatste toegestane tijdstip van elke voorspeller, de doelperiode en het moment waarop de doelwaarde waarneembaar wordt. Vermeld voor financiële rendementen of het rendement van slot tot slot een nachtperiode omvat, welke marktsessie een dag definieert en hoe feestdagen of ontbrekende bars het aantal dagelijkse vertragingen veranderen. Vijf handelssessies en zeven kalenderdagen zijn verschillende intervallen.
Publicatiekalenders veroorzaken rafelige randen. Op een datum kan één voorspeller een verse dagwaarde hebben terwijl een maandreeks nog niet is gepubliceerd. De laatste beschikbare maandwaarde meenemen kan geldig zijn als het model die op het prognosemoment als verouderde maar bekende informatie behandelt. Een nog niet gepubliceerde waarneming invullen met een latere publicatie is ongeldig. Historische revisies kunnen een subtieler vooruitkijkprobleem veroorzaken: een huidige database kan een herziene macroreeks bevatten die een realtime voorspeller toen niet kon zien.
Asynchrone markten geven nog een uitlijningsprobleem. Een dagelijkse aandelenkoers bij sluiting en een dagelijkse cryptosluiting kunnen verschillende UTC-intervallen beslaan; een intraday-volatiliteitsschatting kan bars bevatten die na het prognosetijdstip eindigen. Tijdzoneconversie, zomer- en wintertijd, marktsluitingen en barconstructie maken deel uit van de informatieset. Beschrijf de verwerking in plaats van aan te nemen dat rijen met dezelfde datum hetzelfde informatie-afkappunt hebben.
Een hypothetisch voorbeeld zet dagelijkse invoer om in een weekprognose
Neem als doel de gerealiseerde variantie van volgende week en maak de prognose bij het slot op vrijdag. Het model gebruikt vijf dagelijkse maten van gerealiseerde variantie uit de week die net is afgelopen. Stel dat de geschatte gewichten van meest recent naar oudste \(0{,}40,0{,}25,0{,}16,0{,}11,0{,}08\) zijn, samen één. De bijbehorende dagelijkse invoer in eenheden van rendement in het kwadraat is \(0{,}0004,0{,}0001,0{,}0009,0{,}0004,0{,}0001\).
De gewogen geschiedenis is \(0{,}40(0{,}0004)+0{,}25(0{,}0001)+0{,}16(0{,}0009)+0{,}11(0{,}0004)+0{,}08(0{,}0001)=0{,}000381\). Neem voor dit hypothetisch gefitte model intercept \(a=0{,}00012\) en helling \(b=0{,}80\). De variantieprognose voor volgende week is \(0{,}00012+0{,}80(0{,}000381)=0{,}0004248\). Als een standaarddeviatie nuttig is, is de wortel ongeveer \(0{,}02061\), of \(2{,}06\,\%\) over de doelweek volgens de gekozen definitie.
De berekening laat zien hoe dagelijkse voorspellers worden vertaald naar een toekomstige weekdoelwaarde; de waarden en geschatte coëfficiënten zijn verzonnen. Dit betekent niet dat een genoemde dag de variantie van volgende week veroorzaakte of dat de activaprijs zal stijgen of dalen. Het gewicht van de recente sessie toont hoe het opgegeven voorspelmodel de waargenomen invoer combineert, gegeven de steekproef en restricties. Het is geen schatting van een causaal effect.
Het voorbeeld maakt ook de eenhedenvraag duidelijk. Dagelijkse en wekelijkse gerealiseerde variantie zijn beide rendementvarianties, maar ze betreffen verschillende accumulatieperioden. Helling \(b\), intercept en doelconstructie zijn voor precies die conventie geschat; de dagelijkse invoer mag niet simpelweg als weekvariantie worden hernoemd. Als het doel de log van de weekvariantie is, is de prognose in logeenheden en is exponentiëren van het conditionele gemiddelde van de logwaarde doorgaans niet gelijk aan het conditionele gemiddelde van de variantie. Terugtransformeren naar niveaus vereist een expliciet prognosedoel en waar nodig een correctie.
De schatting hangt af van doelvariabele en lagrestrictie
Bij een vast gewichtsvector is de regressie lineair in intercept en helling. Als de gewichten afhangen van onbekende niet-lineaire parameters \(\theta\), gebruikt men vaak niet-lineaire kleinste kwadraten of een verwante likelihoodmethode. De schatting kan de gewichtsparameters en regressiecoëfficiënten gezamenlijk zoeken, of de lineaire coëfficiënten voor elke kandidaatvorm profileren. Startwaarden, parametergrenzen, convergentiecriteria en lokale optima kunnen ertoe doen; verberg mislukte convergentie of randoplossingen niet.
Als \(y\) een niet-negatieve volatiliteitsmaat is, kan een gewone lineaire specificatie negatieve fitted values opleveren, vooral buiten de steekproef. Mogelijkheden zijn restricties die voorspelde niveaus niet-negatief houden, een positieve linkfunctie of het modelleren van de log van het doel. Die keuzes veranderen het te schatten object en de interpretatie van de prognose. In een logdoelmodel is de voorspelling van het conditionele gemiddelde van de logvariantie niet automatisch het conditionele gemiddelde van de variantie; de foutverdeling en terugtransformatie zijn van belang.
Steekproefonzekerheid hangt ook af van de constructie van het doel. Wekelijkse gerealiseerde variantie op basis van intraday-rendementen bevat meetfout en kan gevoelig zijn voor microstructuurruis, samplinginterval, sprongen en ontbrekende waarnemingen. Als doelvensters elkaar overlappen, delen prognosefouten van naburige oorsprongen dezelfde onderliggende rendementen. Standaardfouten en vergelijkingen die onafhankelijke prognosefouten veronderstellen zijn dan mogelijk ongeschikt. Gebruik inferentie die past bij horizon en afhankelijkheidsstructuur, en rapporteer hoe het doel is gemeten.
Ook parameterstabiliteit is een aandachtspunt. Een geschat gewichtsprofiel middelt over de schattingsperiode; als de marktstructuur verandert, beschrijft de curve mogelijk geen huidig regime goed. Een uitbreidend en een rollend venster beantwoorden verschillende vragen: het eerste gebruikt meer geschiedenis maar behoudt oudere dynamiek; het tweede past zich sneller aan maar heeft minder waarnemingen en meer schattingsruis. Leg de update-regel vooraf vast en vergelijk die in chronologische evaluatie met een vaste benchmark.
MIDAS hangt samen met, maar is niet hetzelfde als GARCH-MIDAS
MIDAS duidt een manier aan om waarnemingen met verschillende meetfrequenties via gewogen vertragingen te combineren. Een MIDAS-regressie kan een toekomstige gerealiseerde-volatiliteitsdoelwaarde rechtstreeks voorspellen uit eerdere dagelijkse of intraday-maten. Ze hoeft niet de eenstapsrecursie voor conditionele variantie te specificeren die bij een GARCH-model hoort.
GARCH-MIDAS is een aparte modelgroep die een langzaam bewegend langetermijncomponent voor volatiliteit, vaak aangedreven door laagfrequente variabelen, combineert met een recursief evoluerende kortetermijncomponent voor conditionele variantie. Beide componenten hebben hun eigen parametrisering en aannames. Lees bij een artikel of software met het label GARCH-MIDAS de precieze vergelijkingen: MIDAS-gewichten kunnen de langetermijncomponent bepalen terwijl een GARCH-recursie kortetermijnschokken verwerkt. Alleen het label zegt niet wat het doel is, of latente dan wel gerealiseerde volatiliteit wordt voorspeld, of hoe positiviteit wordt afgedwongen.
Het oorspronkelijke financiële MIDAS-werk over volatiliteit vergelijkt verschillende voorspellers, frequenties en laglengten binnen een spaarzaam voorspelkader. Later methodologisch werk ontwikkelt schattings- en testeigenschappen voor regressies met gemengde frequenties, waaronder vergelijkingen met traditionele temporele aggregatie. Deze bijdragen onderbouwen de werkwijze; ze bewijzen niet dat MIDAS altijd beter presteert dan GARCH of dat hoogfrequente voorspellers prognoses altijd verbeteren. Resultaten hangen af van activum, steekproef, doel, voorspeller, horizon en evaluatieontwerp.
Kies het model op basis van de vraag. Voor het voorspellen van een toekomstige maat van gerealiseerde volatiliteit uit dagelijkse geschiedenis kan een directe MIDAS-regressie een logische kandidaat zijn. Voor een recursief model van conditionele variantie vergelijk je een passende GARCH-specificatie. Bij het combineren van kwartaalpublicaties met een dagelijks financieel doel kunnen publicatiedata en gegevensvintages relevant zijn. Modellen met vergelijkbare namen kunnen verschillende vragen beantwoorden; vergelijk eerst prognosemoment, doeldefinitie en informatieset.
Meetfout en selectie kunnen de gewichtenfunctie overvleugelen
Hoogfrequente gegevens geven meer tijdsdetail maar kunnen de meetruis vergroten. Zeer korte bars bevatten bid-ask-bounce, discrete prijzen, verouderde koersen, asynchrone handel en feedfouten. Gekwadreerde rendementen over steeds kortere intervallen optellen garandeert geen betere maat van gerealiseerde variantie. Kies samplingraster en opschoningsregels voordat je prognoseprestaties bekijkt en analyseer plausibele alternatieven.
Hoeveel er te leren valt, wordt beperkt door het aantal laagfrequente uitkomsten, niet door het schijnbare aantal dagelijkse voorspellerregels. Tien jaar dagelijkse invoer gekoppeld aan wekelijkse doelen levert vóór ontbrekende waarden en evaluatie-holdout nog maar ongeveer vijfhonderd wekelijkse uitkomstperioden op. Een gladde MIDAS-gewichtenfunctie gebruikt minder coëfficiënten dan vrije dagelijkse vertragingen, maar de vorm kan toch zwak geïdentificeerd zijn bij een korte steekproef, zeer persistente voorspellers of redundante kandidaatvertragingen.
Veel analytische keuzes veroorzaken selectiebias: meerdere hoogfrequente maten, laglengten, gewichtsprofielen, transformaties, markten, prognosehorizonnen en verliesfuncties proberen en alleen de beste uitkomst rapporteren. In-sample fit is extra kwetsbaar doordat dezelfde doelen zowel de parameters als modelkeuzes sturen. Leg de geteste modelfamilie vast, kies een primaire maatstaf en gebruik een latere chronologische holdout of een vergelijking die selectie meeneemt. Als veel prognoses op dezelfde datums worden vergeleken, houd dan rekening met afhankelijkheid en multipliciteit in plaats van elke uitkomst als onafhankelijke bevestiging te behandelen.
Een gefit gewichtsprofiel is geen causale verklaring. Hoogfrequente invoer kan nieuws, liquiditeit of marktactiviteit weerspiegelen; niet-waargenomen factoren kunnen zowel voorspellers als toekomstige volatiliteit beïnvloeden. Voorspellende bruikbaarheid vereist stabiele tijdsuitlijning en bewijs buiten de steekproef. Een causale interpretatie vraagt een apart identificatieontwerp en aannames die niet uit de MIDAS-vertragingsvergelijking volgen.
Een prognose bepaalt geen winstgevende handelsbeslissing
Een volatiliteitsprognose kan helpen bij een risicobudget, hedgeomvang of scenariospreiding, maar bepaalt niet het teken van een rendement of de richting van een positie. Een voorspelde wekelijkse standaarddeviatie van \(2{,}06\,\%\) is geen beloofde koersbeweging, maximaal verlies of optie-implied volatiliteitsnotering. Ze beschrijft een gekozen spreidingsmaat onder een model en steekproef; gerealiseerde rendementen kunnen veel groter of kleiner zijn.
Definieer voor een strategiestudie vóór de test het signaalmoment, ordermoment, instrument, blootstellingsregel en uitstapmoment. Schat historische MIDAS-parameters op elk prognosemoment uitsluitend opnieuw met informatie die toen beschikbaar was. Evalueer prognoses tegen een vooraf vastgelegde benchmark en een doelpassend verlies; simuleer daarna afzonderlijk rendementen met spread, kosten, funding, leenlasten, marktimpact en omzet. Een statistisch betere volatiliteitsprognose hoeft de rendementen na kosten niet te verbeteren.
Rapporteer doelvariabele en meetprocedure; definities en eenheden van voorspellers; lage en hoge frequentie; prognosemoment; aantal vertragingen; gewichtenfunctie en restricties; schattingsvenster en updateschema; verwerking van ontbrekende gegevens en historische vintages; verliesfunctie; benchmark en chronologische testdatums. Toon prognoseonzekerheid of gevoeligheid als de keuze van het lagprofiel het resultaat wezenlijk wijzigt. Zie ook de gidsen over gerealiseerde volatiliteit, volatiliteitsclustering en GARCH en vergelijking van prognosenauwkeurigheid.
Belangrijke primaire bronnen zijn Ghysels, Santa-Clara en Valkanovs MIDAS-onderzoek naar volatiliteitsprognoses, Ghysels, Sinko en Valkanovs methodologische overzicht en uitbreidingen, en Andreou, Ghysels en Kourtellos' analyse van regressiemodellen met gemengde frequenties. Hun empirische bevindingen gelden voor de onderzochte steekproeven en ontwerpen; ze garanderen geen prestaties in de huidige markt of een andere activaklasse.
Veelgestelde vragen
Q1Betekent MIDAS dat alle gegevens naar één frequentie worden gemiddeld?
Nee. Een MIDAS-regressie houdt het doel op de gekozen frequentie en gebruikt gestructureerde gewogen vertragingen van een voorspeller met hogere frequentie. Alle reeksen hoeven niet naar één gemeenschappelijke rijenkalender te worden geïnterpoleerd.
Q2Zijn MIDAS-regressie en GARCH-MIDAS hetzelfde?
Nee. MIDAS is een kader voor gewogen vertragingen met gemengde frequenties. GARCH-MIDAS combineert een langetermijncomponent volgens MIDAS met een GARCH-recursie voor kortetermijnvariantie. Controleer de concrete vergelijkingen voor doel en componenten.
Q3Is een nauwkeuriger MIDAS-volatiliteitsprognose automatisch een handelssignaal?
Nee. De prognose betreft een gekozen spreidingsmaat. Een strategie heeft een eigen richting- of risicoregel, realistische uitvoeringskosten en een chronologische evaluatie van rendementen na kosten nodig.
Bronnen en verder lezen
Probleem melden
We bereiden een e-mail met de link naar dit artikel voor. Mark ontvangt je melding pas nadat je die verstuurt
Snelle check
De gids gelezen? Test jezelf met 3 vragen
Vraag 01
Wat is de belangrijkste taak van een MIDAS-gewichtenfunctie?
Kies een antwoord om de uitleg te zien
Optiewoordenlijst
A time-series model that updates conditional variance from past squared shocks and prior variance; it models volatility persistence, not return direction.
Lees de uitgebreide gidsRealized volatilityVolatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
Lees de uitgebreide gidsCausationA relationship describing how an outcome would differ under a specified intervention or counterfactual change; observed association alone does not identify it.
Lees de uitgebreide gids