

Diebold–Mariano-toets: voorspelnauwkeurigheid vergelijken
Lees hoe de Diebold–Mariano-toets gepaarde voorspelverliezen vergelijkt, overlappende horizons verwerkt en waarom een lage p-waarde geen bewijs is van handelsvaardigheid.
In deze gidsEen lagere backtestfout is nog geen bewijs voor een betere voorspelling
Korte samenvatting
De Diebold–Mariano-toets vergelijkt twee voorspellingen door het verschil te bekijken tussen hun verliezen op dezelfde gerealiseerde uitkomsten. De uitkomst hangt af van de verliesfunctie, de evaluatiesteekproef, de voorspelhorizon en de onzekerheidsschatting. Een lagere fout in de steekproef bewijst niet vanzelf een hogere verwachte nauwkeurigheid; een nauwkeurigere voorspelling is ook niet hetzelfde als een winstgevende handelsstrategie.
Een lagere backtestfout is nog geen bewijs voor een betere voorspelling
Stel dat twee modellen voor dezelfde datums hetzelfde rendement, dezelfde volatiliteit of dezelfde economische grootheid voorspellen. In de evaluatiesteekproef heeft model A een kleinere gemiddelde fout dan model B. Dat beschrijft de steekproef, maar zegt niet of A betrouwbaar nauwkeuriger is of dat het waargenomen verschil kan voortkomen uit de gewone variatie van de datums die toevallig zijn getest.
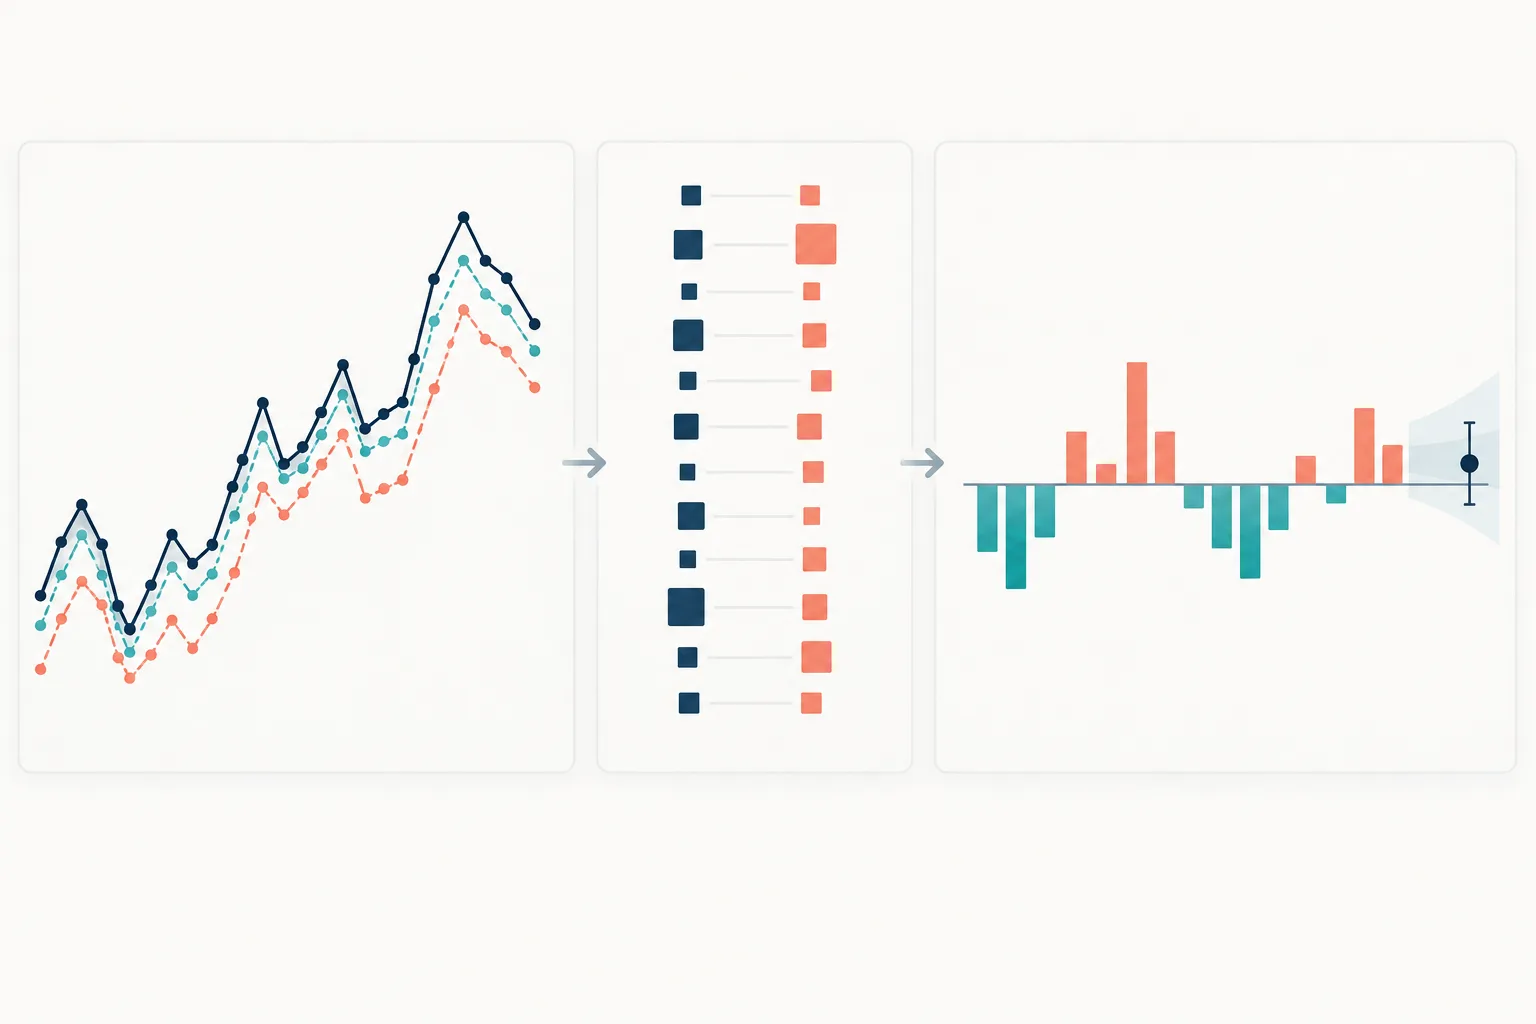
De Diebold–Mariano-toets (DM-toets) maakt van deze vergelijking een gepaarde tijdreeks. Op ieder voorspelmoment vergelijkt de toets beide voorspellingen met dezelfde gerealiseerde uitkomst, kent ze een score toe met een vooraf gekozen verliesfunctie en onderzoekt daarna de reeks verschillen in verlies. Die koppeling is van belang: een volatiele marktdag kan de verliezen van beide modellen verhogen, terwijl de vergelijking nagaat welk model juist op diezelfde dagen doorgaans minder verlies heeft.
De oorspronkelijke methode beperkt zich niet tot kwadratische fouten of normaal verdeelde voorspellingsfouten. Ze kan verschillende verliesfuncties vergelijken, ook asymmetrische, zolang die scores passen bij de voorspelvraag. Wel is een verdedigbare evaluatieopzet nodig en moet de onzekerheid rond het gemiddelde verschil in verlies worden geschat. Diebold en Mariano (1995) beschreven de toets op gelijke voorspelkracht; Harvey, Leybourne en Newbold (1997)00719-4) onderzochten een aanpassing voor kleine steekproeven.
Vergelijk gelijksoortige voorspellingen voordat je een statistiek berekent
Elke rij hoort één vergelijkbaar voorspelmoment te vertegenwoordigen. Beide modellen moeten hetzelfde doel en dezelfde horizon voorspellen op basis van informatie die op dat moment beschikbaar was. Stem de gerealiseerde uitkomsten, tijdstempels, valuta of eenheden, gegevensversies en regels voor ontbrekende waarnemingen op elkaar af voordat je de verliezen vergelijkt. Als het ene model de slotkoers van morgen voorspelt en het andere een gemiddelde over vijf dagen, beantwoorden de fouten verschillende vragen.
Gebruik voorspellingen die zonder toekomstinformatie zijn gemaakt. Een chronologische holdout of een voortschrijdende pseudo-out-of-sample-opzet kan daarbij helpen, maar een splitsing alleen volstaat niet als dezelfde holdout herhaaldelijk is gebruikt om kenmerken, drempels of modelvarianten af te stemmen. Bewaar de voorspelling die op elk historisch voorspelmoment daadwerkelijk is gemaakt, inclusief de gegevens- en modelversie die ervoor zijn gebruikt. Herziene macro-economische gegevens, filters voor survivorship bias of aanpassingen op basis van toekomstige bedrijfsacties kunnen de evaluatie achteraf veranderen.
Evalueer beide modellen op dezelfde verzameling voorspelmomenten. Moeilijke datums alleen voor één model weglaten, verbreekt de gepaarde vergelijking. Ontbreken er voorspellingen, leg dan een gemeenschappelijke steekproef vast of onderbouw hoe je ontbrekende voorspellingen behandelt; laat de modellen niet ongemerkt verschillende marktregimes meemaken. Kies de begin- en einddatum voordat je bekijkt welke steekproef de gewenste conclusie oplevert.
De verliesfunctie bepaalt wat ‘nauwkeuriger’ betekent
Noem de gerealiseerde waarde op voorspelmoment t yₜ en de voorspellingen van model A en B ŷA,ₜ en ŷB,ₜ. De fouten zijn eA,ₜ = yₜ − ŷA,ₜ en eB,ₜ = yₜ − ŷB,ₜ. Een verliesfunctie L zet elke fout om in een score, waarbij een lagere waarde beter is. Kwadratisch verlies, L(e) = e², bestraft grote missers zwaarder. Absoluut verlies, L(e) = |e|, stijgt lineair met de grootte van de misser. Een kwantielvoorspelling kan een asymmetrisch pinball-verlies gebruiken, omdat te laag en te hoog voorspellen verschillende kosten hebben.
De gekozen score kan bepalen welk model beter lijkt. Neem twee hypothetische foutenparen in dezelfde eenheden: model A heeft fouten 0 en 2; model B heeft 1 en 1. Bij kwadratisch verlies zijn de gemiddelde verliezen respectievelijk 2 en 1, zodat B beter scoort. Bij absoluut verlies is het gemiddelde van beide 1. Geen van beide berekeningen is altijd juist; ze beantwoorden verschillende vragen over welke fouten ertoe doen.
Voor rendementsvoorspellingen kan kwadratisch verlies nuttig zijn voor een voorspelling van het conditionele gemiddelde. Een volatiliteitsvoorspelling vraagt om een score die bij dat doel past; een Value-at-Risk-voorspelling vraagt om een kwantielscore of een specifieke risicobacktest. De verliesfunctie kiezen nadat je hebt gezien welk model wint, maakt van de toets een nieuwe zoektocht. Leg de score en de richting van ‘beter’ vast voordat je de vergelijking bekijkt.
Een VaR-voorspelling richt zich op een staartkwantiel en niet op een gewone puntschatting. De gids over VaR-backtesting legt uit hoe het aantal en de timing van uitzonderingen bij die afzonderlijke risicovoorspelling worden getoetst.
Bereken gepaarde verliesverschillen en formuleer de nulhypothese
Definieer voor een verliesfunctie waarbij lager beter is het verschil in periode t als
dₜ = L(eA,ₜ) − L(eB,ₜ)
Met deze tekenconventie betekent een positieve dₜ dat model A meer verlies had en model B op dat voorspelmoment dus minder verlies; een negatieve waarde is gunstig voor A. Het steekproefgemiddelde is d̄ = (1/n) Σ dₜ. De nulhypothese van onvoorwaardelijke gelijke voorspelkracht is E[dₜ] = 0. De tweezijdige alternatieve hypothese vraagt of de verwachte verliezen in een van beide richtingen verschillen. Een vooraf vastgelegde eenzijdige hypothese kan toetsen of één benoemd model een lager verwacht verlies heeft.
De basisstatistiek is
DM = d̄ / √(Ŝd / n)
Hier schat Ŝd de langetermijnvariantie van de reeks verliesverschillen, niet alleen de variantie van de voorspellingsfouten van een van beide modellen. Onder de nulhypothese en passende reguliere voorwaarden is de statistiek asymptotisch standaardnormaal verdeeld. Grote positieve waarden zijn gunstig voor B volgens de tekenconventie hierboven; grote negatieve waarden zijn gunstig voor A. De p-waarde meet hoe verenigbaar de gegevens zijn met de opgegeven nulhypothese en steekproefaannames, niet de kans dat een van de modellen waar is.
Door de voorspellingen te koppelen, verdwijnen irrelevante verschillen in de totale foutschalen van beide modellen alleen voor zover de verschillen per voorspelmoment ze opvangen. De verliesreeks wordt daardoor niet onafhankelijk, onzekerheid door parameterschatting verdwijnt niet automatisch en een zoektocht langs veel doelen en specificaties wordt niet gecorrigeerd. Die keuzes horen thuis in de onderzoeksopzet en de onzekerheidsschatting.
Een voorbeeld met één stap scheidt een steekproefverschil van bewijs
Stel dat er 100 gepaarde hypothetische voorspellingen voor één stap zijn. Het gemiddelde kwadratische verlies van model A is 0.26 en dat van model B 0.23, in kwadratische procentpunt-eenheden. Het gemiddelde verschil is dus d̄ = 0.26 − 0.23 = 0.03, wat in de steekproef gunstig is voor B. Neem voor dit eenvoudige voorbeeld aan dat de geschatte langetermijnvariantie van dₜ 0.04 is en dat er geen seriële covariantie tussen de voorspelmomenten is.
De geschatte standaardfout van het gemiddelde verschil is √(0.04 / 100) = 0.02. De ongecorrigeerde statistiek is 0.03 / 0.02 = 1.50. Voor horizon h = 1 en T = 100 is de Harvey–Leybourne–Newbold-factor voor kleine steekproeven √[(T + 1 − 2h + h(h − 1)/T) / T] = √0.99 ≈ 0.995. Na vermenigvuldiging is de aangepaste statistiek ongeveer 1.49; met de benaderende t₉₉-verdeling als referentie is de tweezijdige p-waarde ongeveer 0.14.
B heeft een lager waargenomen gemiddeld kwadratisch verlies, maar dit voorbeeld levert geen sterk bewijs tegen gelijke verwachte nauwkeurigheid bij gangbare significantiedrempels. Niet-verwerpen bewijst niet dat de modellen even nauwkeurig zijn; verwerpen blijft afhankelijk van de gekozen score, voorspelmomenten en aannames. De variantie en alle verliezen zijn hier hypothetische invoer ter uitleg, geen empirische resultaten.
De vierkantswortels van de gemiddelde kwadratische verliezen zijn RMSE-waarden van ongeveer 0.510 en 0.480 procentpunt, een beschrijvend verschil van 0.030. De DM-statistiek toetst echter de gepaarde verschillen in kwadratisch verlies; het is geen t-toets van het verschil tussen die twee wortels.
Overlappende horizons maken verliesverschillen afhankelijk
Als voorspellingen voor vijf dagen vooruit dagelijks worden afgegeven, delen opeenvolgende voorspellingen vier van hun vijf doeldagen. Hun fouten, verliezen en verliesverschillen kunnen daardoor samen bewegen. Honderd dagelijkse voorspelmomenten behandelen als honderd onafhankelijke vergelijkingen kan de onzekerheid onderschatten en de statistiek te groot doen lijken.
De langetermijnvariantie houdt rekening met seriële covariantie in dₜ. Een gangbare schatter die consistent is voor heteroskedasticiteit en autocorrelatie (HAC) heeft de vorm
Ŝd = γ̂₀ + 2 Σₖ₌₁ᵐ wₖ γ̂ₖ
waarbij γ̂ₖ de steekproefautocovariantie van d op lag k is, wₖ een kernelgewicht en m de gekozen bandbreedte. Newey en West (1987) geven een positief semidefiniete HAC-covariantiematrixschatter. Voor ideale h-staps voorspellingsfouten onder de relevante aannames veroorzaakt overlap vaak afhankelijkheid tot ten minste h − 1 lags; de oorspronkelijke DM-opzet bespreekt daarvoor een afgeknotte schatter. Werkelijke gegevens kunnen langer afhankelijk zijn door persistente doelen, voortschrijdende schattingen of de constructie van een strategie. h − 1 is daarom geen universele bandbreedteregel.
Vermeld de horizon, kernel, bandbreedte en eventuele correctie voor kleine steekproeven. Laat zien of conclusies veranderen onder redelijke afhankelijkheidsinstellingen in plaats van een bandbreedte te kiezen omdat die de gewenste p-waarde geeft. Als je voorspelmomenten ver genoeg uit elkaar zet om overlap te vermijden, vermeld dat dan en leg uit welke informatie of steekproefomvang je opgeeft. Afhankelijkheidsbewuste onzekerheid hoort bij de toets en is geen optionele weergave-instelling.
Geneste modellen en veranderende voorspelkracht vragen om andere toetsen
De gewone DM-vergelijking is het eenvoudigst te interpreteren voor voorspellingen die onder de nulhypothese van gelijke nauwkeurigheid niet genest zijn. Als een groter model een kleiner benchmarkmodel bevat, kunnen de extra geschatte coëfficiënten voorspelruis toevoegen, ook als hun echte waarden nul zijn. Onder die nul kan het verschil in gemiddelde kwadratische voorspellingsfout een niet-standaardverdeling hebben. Voor out-of-sample-MSPE-vergelijkingen van geneste modellen houdt een methode zoals de Clark–West-correctie rekening met dit effect van schattingsruis; zij is geen algemene vervanging voor DM bij elke modelopzet. Zie Clark en West (2007).
De gewone DM-nulhypothese betreft het onvoorwaardelijke gemiddelde verlies over de volledige evaluatiesteekproef. Daardoor kunnen veranderingen in de tijd verborgen blijven: A kan beter zijn in rustige perioden en B tijdens hoge volatiliteit, terwijl de gemiddelden vergelijkbaar zijn. Als de vraag is of relatieve nauwkeurigheid afhangt van informatie die beschikbaar was toen de voorspelling werd gedaan, combineren toetsen voor conditionele voorspelkracht verliesverschillen met vooraf gekozen instrumenten. Giacomini en White (2006) ontwikkelden dit kader. De aannames en evaluatieperiode blijven van belang; willekeurige indicatoren toevoegen nadat je resultaten hebt bekeken is geen geldige snelkoppeling.
De toetskeuze hoort bij de vergelijkingsstructuur: onafhankelijke voorspellingen, geneste modellen, veranderende conditionele vaardigheid of een kandidaat uit veel varianten zijn niet onderling uitwisselbaar. Voor die laatste situatie legt de gids over White Reality Check en Hansen SPA correctie op familieniveau uit na het doorzoeken van veel handelsregels.
Een lager voorspelverlies bewijst geen winstgevende strategie
Een voorspelling kan statistisch nauwkeuriger zijn zonder de netto handelsresultaten te verbeteren. Een strategie moet de voorspelling omzetten in een positie, het handelsmoment bepalen en rekening houden met spreads, commissies, slippage, marktimpact, financiering, leenlasten en risicolimieten. Een kleine verbetering in het gemiddelde kwadratische rendementsverlies kan voor beslissingen onbruikbaar zijn. Een model met iets meer gemiddeld verlies kan juist een staartgebeurtenis beter herkennen die voor een specifieke regel telt.
Houd voorspellingsevaluatie en portefeuilleevaluatie als afzonderlijke stappen. Toets eerst de voorspelling met een doel en verliesfunctie die bij de voorspeltaak passen. Evalueer daarna een volledig vastgelegde handelsregel met gegevens die niet zijn gebruikt om de voorspelling te selecteren en met realistische aannames over uitvoering en financiering. Een p-waarde uit een voorspellingstoets is geen backtestrendement, Sharpe-ratio of kans op toekomstige winst.
Herhaald proberen van modellen, doelen, horizons, verliesfuncties en steekproefperioden veroorzaakt selectievertekening, ook als elke afzonderlijke DM-berekening correct is. Leg de volledige zoektocht vast en gebruik een methode voor de hele familie als de onderzoeksvraag is of er uit die zoektocht een kandidaat overblijft. De gids over block bootstrap behandelt afhankelijkheidsbewuste onzekerheid voor een vooraf bepaalde statistiek; op zichzelf corrigeert die geen ongedocumenteerde modelzoektocht.
Rapporteer genoeg details zodat een andere onderzoeker de analyse kan herhalen
Noem beide voorspelmodellen, hun relatie tot het benchmarkmodel, het doel, de horizon, het schema van voorspelmomenten, evaluatiedatums, de informatieset, gegevensversie en regel voor de gemeenschappelijke steekproef. Definieer de verliesfunctie wiskundig en vermeld of een positieve dₜ gunstig is voor A of B. Rapporteer n, het gemiddelde verlies van elk model, d̄, de schatter voor langetermijnvariantie, de HAC-kernel en bandbreedte, de correctie voor kleine steekproeven, de referentieverdeling, de richting van de toets en de p-waarde.
Vermeld ook of de modellen genest zijn, hoe parameters zijn geschat, of de vergelijking voor of na inzage in de resultaten is gekozen en welke andere varianten zijn geprobeerd. Als de steekproef voor modelselectie is gebruikt, beschrijf de toets dan als onderdeel daarvan en niet als onaangetast out-of-sample-bewijs. Een helder verslag laat lezers precies zien wat er wordt vergeleken en welke onzekerheids- of selectieproblemen buiten de toets blijven.
Veelgestelde vragen
Q1Vereist de Diebold–Mariano-toets normaal verdeelde voorspellingsfouten?
Nee. De methode kan ook met niet-normale voorspellingsfouten werken. De toets vereist wel een passende schatting van de variantie van het verliesverschil en reguliere voorwaarden voor de referentieverdeling.
Q2Kan ik twee modellen vergelijken die verschillende horizons voorspellen?
Niet als een gelijkwaardige vergelijking van voorspellingsnauwkeurigheid. Stem eerst doel en horizon op elkaar af; anders beantwoorden de modellen verschillende voorspelvragen.
Q3Is een significante DM-uitkomst voldoende om een handelsmodel te kiezen?
Nee. Ze geeft bewijs over het verwachte voorspelverlies binnen een bepaalde vergelijking. Je moet ook modelzoektocht, beslisregels, uitvoeringskosten, financiering en out-of-sample-strategieprestaties meewegen. Belangrijk onderzoek - Diebold en Mariano, “Comparing Predictive Accuracy” (1995) - Harvey, Leybourne en Newbold, “Testing the Equality of Prediction Mean Squared Errors” (1997)00719-4) - Giacomini en White, “Tests of Conditional Predictive Ability” (2006) - Clark en West, “Approximately Normal Tests for Equal Predictive Accuracy in Nested Models” (2007) - Newey en West, “A Simple, Positive Semi-Definite, Heteroskedasticity and Autocorrelation Consistent Covariance Matrix” (1987)
Bronnen en verder lezen
Probleem melden
We bereiden een e-mail met de link naar dit artikel voor. Mark ontvangt je melding pas nadat je die verstuurt
Snelle check
De gids gelezen? Test jezelf met 3 vragen
Vraag 01
Welk model wordt bevoordeeld door een positief steekproefgemiddelde bij dₜ = L(eA,ₜ) − L(eB,ₜ)?
Kies een antwoord om de uitleg te zien