

Bai–Perron-toetsen voor meerdere structurele breuken in regressies
Lees hoe Bai–Perron-methoden zoeken naar een onbekend aantal en onbekende datums van regressiebreuken, hoe trimming en kritieke waarden werken en wat de schattingen niet aantonen.
In deze gidsWelke vraag een regressietoets voor meerdere breuken stelt
Korte samenvatting
Bai–Perron-methoden schatten regressiebreukdatums gezamenlijk voor een gekozen aantal breuken. Toetsen of modelselectiecriteria beoordelen daarna hoeveel breuken de gegevens ondersteunen. De datums en het aantal hangen af van de regressie, de minimale segmentlengte, aannames over de fouten en de zoekprocedure; ze wijzen geen oorzaak of handelsvoordeel aan.
Welke vraag een regressietoets voor meerdere breuken stelt
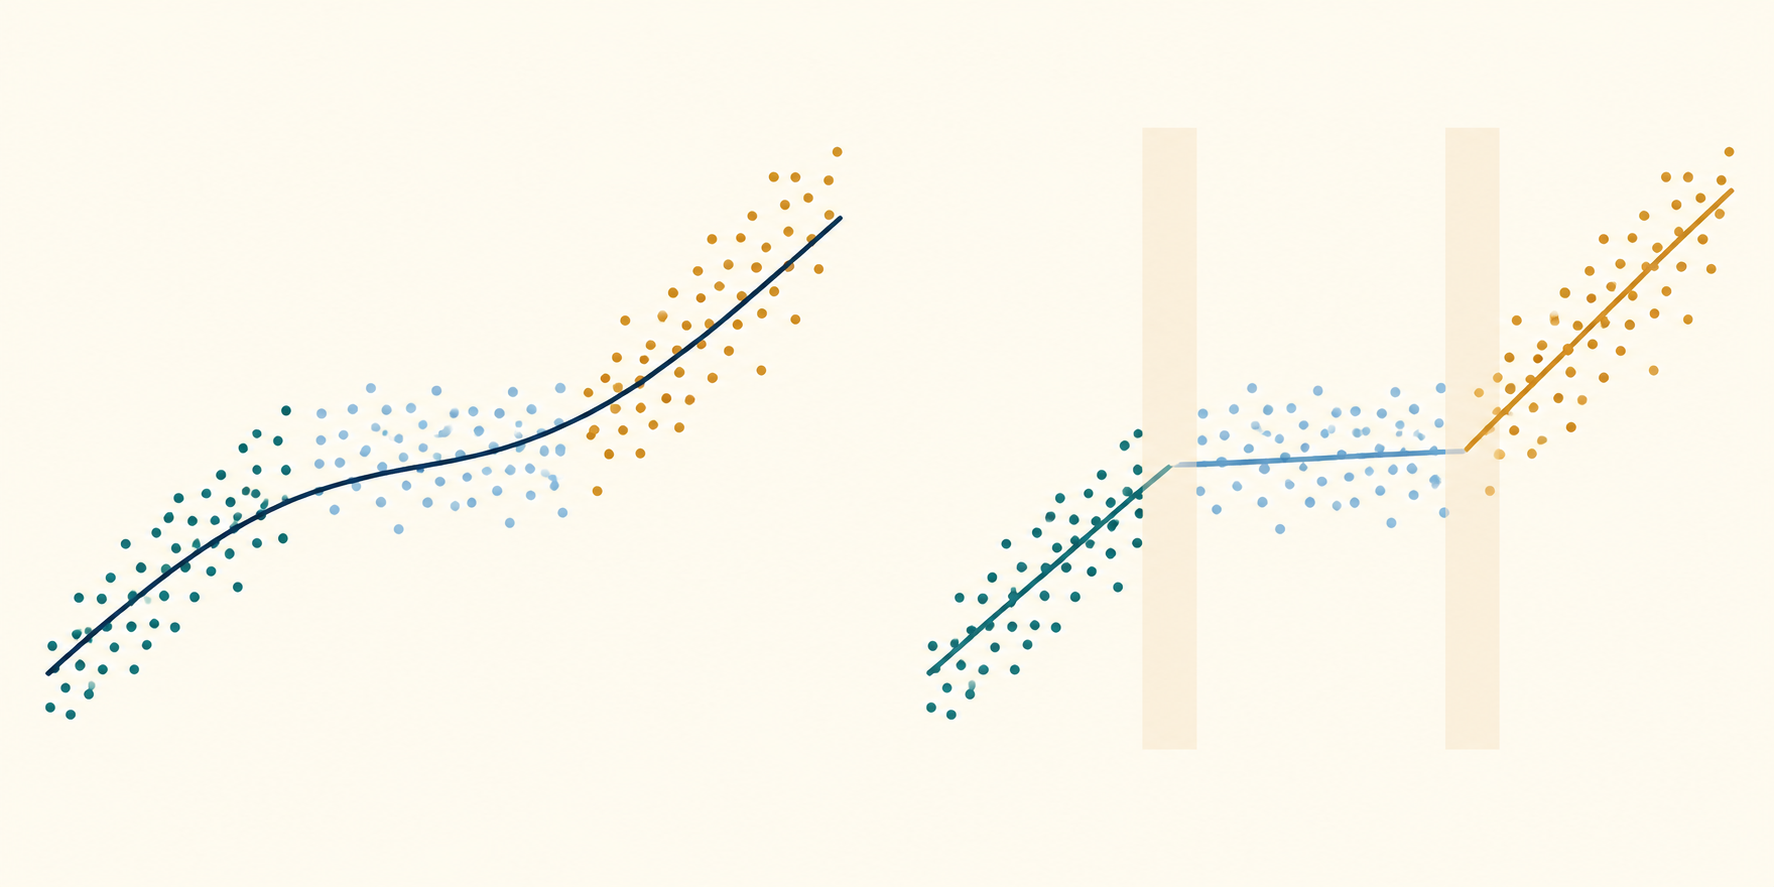
Een structurele breuk in een regressie betekent dat een of meer coëfficiënten op een onbekend punt in de steekproef kunnen zijn veranderd. Eén schatting over de hele steekproef kan dat verhullen: als het verband tussen rendement en risico eerst positief is en later zwakker wordt of omkeert, beschrijft de gemiddelde coëfficiënt mogelijk geen van beide perioden goed. Bai–Perron-methoden maken van die vraag een expliciete zoektocht naar mogelijke verdelingen van de waarnemingen.
Het belangrijkste verschil met de Chow-toets is of de datum vooraf vaststond. Een Chow-toets vergelijkt deelsteekproeven rond een opgegeven datum. Veel datums proberen en alleen de grootste gewone Chow-statistiek rapporteren behoudt de gebruikelijke referentieverdeling van één toets niet. Bai–Perron-toetsen houden rekening met de zoektocht naar mogelijke datums en kunnen meer dan één breuk beoordelen. Voor een vooraf vastgelegde datum, zie de uitleg over de Chow-toets.
Ook de regressie-CUSUM moet hiervan worden onderscheiden. CUSUM onderzoekt een geordend pad van recursieve residuen op aanwijzingen tegen stabiliteit, maar levert op zichzelf geen geselecteerde reeks van meerdere breukdatums op. Bai–Perron schat daarentegen een segmentering onder een expliciet stukgewijs regressiemodel. Geen van beide methoden verklaart waarom een verband veranderde. Zie de uitleg over regressie-CUSUM voor de residupaddiagnose.
Schrijf de regressie op met onbekende datums en een onbekend aantal breuken
Stel dat er \(T\) waarnemingen en \(m\) breuken zijn op gehele datums \(T_1<\cdots<T_m\). Neem \(T_0=0\) en \(T_{m+1}=T\), en definieer segment \(j\) als de waarnemingen \(T_{j-1}+1,\ldots,T_j\). In een model met zuivere structurele verandering geldt
\[ y_t=x_t'\beta_j+u_t,\qquad T_{j-1}<t\le T_j,\quad j=1,\ldots,m+1. \]
Hier is \(y_t\) de uitkomst, \(x_t\) de vector met opgenomen regressoren, \(\beta_j\) de coëfficiëntvector in segment \(j\) en \(u_t\) de foutterm. Niet alleen de coëfficiënten zijn onbekend: tenzij het ontwerp ze vastlegt, moeten ook de breukdatums en het aantal \(m\) worden geschat of geselecteerd. Het model veronderstelt bovendien een betekenisvolle volgorde van de waarnemingen en een stabiele coëfficiëntvector binnen elk segment volgens de gekozen specificatie.
In een financieel voorbeeld kan \(y_t\) het rendement van een portefeuille zijn en kan \(x_t\) marktrendement, renteverandering of een volatiliteitsmaat bevatten. Een gevonden breuk betekent dat het geselecteerde stukgewijze lineaire conditionele gemiddelde volgens de procedure binnen de steekproef beter past. Dit houdt niet in dat een genoemde gebeurtenis de coëfficiënt veranderde, dat een verklarende variabele exogeen is of dat het verband buiten de steekproef stabiel blijft.
Maak onderscheid tussen een waarnemingsdatum en een kalenderdatum. Als de waarnemingen dagelijkse handelsessies zijn, hoeft een breuk tussen sessie 120 en 121 niet overeen te komen met één kalenderdag; feestdagen, ontbrekende koersen en onregelmatige intervallen beïnvloeden die koppeling. Leg vast hoe de steekproef is geordend en hoe de breukdatum wordt gerapporteerd voordat je die als tijdstip van een gebeurtenis behandelt.
Kies bewust voor zuivere of gedeeltelijke structurele verandering
In een model met zuivere structurele verandering kan elke coëfficiënt in \(\beta_j\) per segment variëren. Daardoor kunnen het intercept en alle hellingen veranderen, maar zijn er meer segmentspecifieke parameters nodig. Bij korte segmenten of veel regressoren kunnen breuken daarom moeilijk nauwkeurig te schatten zijn. Zuivere verandering past alleen wanneer de onderzoeksvraag toestaat dat elke gemodelleerde relatie opnieuw wordt ingesteld.
In een model met gedeeltelijke structurele verandering blijven sommige coëfficiënten gelijk tussen segmenten en mogen andere veranderen. Schrijf bijvoorbeeld \(\beta_j=(\delta',\gamma_j')'\), waarbij \(\delta\) voor alle segmenten gelijk is en \(\gamma_j\) segmentspecifiek is. Dat kan een inhoudelijke beperking uitdrukken: het intercept en de helling voor beleidsblootstelling mogen veranderen, terwijl het effect van een controlevariabele gelijk blijft. De beperking verandert zowel de fitdoelfunctie als de referentieverdeling van de toets. Beschrijf haar expliciet in plaats van haar als onschuldige vereenvoudiging te behandelen.
Ook de berekening verschilt. Bij zuivere verandering is de residuele kwadratensom (RSS) van een segmentering de som van onafhankelijke segment-RSS-waarden. Dynamische programmering kan daarom bij een vast aantal breuken de segmentering optimaliseren. Bij het gedeeltelijke model verbinden de gemeenschappelijke coëfficiënten alle segmenten. Bai en Perron beschrijven een iteratieve aanpak: schat eerst de breukdatums en veranderende coëfficiënten terwijl de gemeenschappelijke coëfficiënten vaststaan, en werk daarna die gemeenschappelijke coëfficiënten bij voor een gegeven segmentering. De eenvoudige additieve segment-RSS-recurrentie lost het volledige beperkte probleem niet zelfstandig op. Kies de specificatie op basis van de wetenschappelijke of voorspellende vraag, niet omdat een variant meer breuken oplevert.
Stel de minimale segmentlengte vast voordat je kandidaatdatums bekijkt
De zoektocht vereist een minimumaantal waarnemingen per segment. Deze trimregel voorkomt dat extreem korte intervallen worden gefit met instabiele coëfficiënten, maar sluit ook echte veranderingen uit die te dicht bij een steekproefgrens of een andere breuk liggen. De regel maakt deel uit van het ontwerp en is geen universele wet.
Neem een uitdrukkelijk hypothetisch voorbeeld met \(T=240\) waarnemingen en een gekozen trimfractie van 15%. Dan is \(h=0{,}15\times240=36\) waarnemingen de minimale segmentlengte. Als de breukdatum de laatste waarneming van het eerdere segment aanduidt, zijn bij één breuk datums \(36\le T_1\le204\) toegestaan. Beide segmenten bevatten dan ten minste 36 waarnemingen.
Bij twee breuken moeten toegestane datumparen voldoen aan:
\[ 36\le T_1,\qquad T_1+36\le T_2\le204. \]
Dus \(T_1\le168\), terwijl \(T_2\) minstens 36 waarnemingen na de eerste breuk moet liggen en na de tweede nog 36 waarnemingen moet overlaten. Het paar \((72,156)\) is toegestaan: de drie segmenten bevatten 72, 84 en 84 waarnemingen. \((80,100)\) is niet toegestaan, omdat het middelste segment maar 20 waarnemingen bevat. Bij deze \(h\) passen maximaal vijf breuken in 240 waarnemingen: zes segmenten vereisen minstens \(6\times36=216\) waarnemingen en zeven segmenten 252.
De 15% is hier een expliciet hypothetische ontwerpkeuze, geen standaardadvies. Een groter aandeel kan kortdurende regimes en datums dicht bij de steekproefgrenzen uitsluiten; een kleiner aandeel laat korte segmenten toe, maar kan te weinig informatie overlaten om hellingen en langetermijncovariantiematen betrouwbaar te schatten. Kies de regel op basis van de steekproeffrequentie, het aantal regressoren, de plausibele regimeduur en de inferentiemethode. Rapporteer de keuze en laat, wanneer inhoudelijk zinvol, zien of conclusies veranderen bij nabije waarden. Implementaties kunnen de effectieve steekproefomvang en eindpunten anders bepalen bij vertragingen of ontbrekende waarnemingen; documenteer de gebruikte conventie.
Gebruik dynamische programmering voor een globale segmentering bij een vast aantal
Voor een model met zuivere verandering en vast \(m\) kan de datumzoektocht worden geschreven als minimalisatie van de totale segment-RSS:
\[ \min_{T_1,\ldots,T_m}\;\sum_{j=1}^{m+1}\operatorname{SSR}(T_{j-1}+1,T_j), \]
onder de voorwaarden voor datumvolgorde en minimale segmentlengte. \(\operatorname{SSR}(a,b)\) is de kleinste residuele kwadratensom uit een kleinste-kwadratenfit op één segment met waarnemingen \(a,\ldots,b\). Een naïeve zoektocht controleert elke combinatie van datums; het aantal groeit snel met \(T\) en \(m\).
Dynamische programmering hergebruikt oplossingen van deelproblemen. Als \(D(r,j)\) de kleinste RSS is voor het verdelen van waarnemingen 1 tot en met \(j\) in \(r\) geldige segmenten, is een vorm van de recurrentie:
\[ D(r,j)=\min_i\{D(r-1,i)+\operatorname{SSR}(i+1,j)\}, \]
waarbij de splitsing \(i\) zo wordt beperkt dat elk van de eerste \(r-1\) segmenten en het laatste segment aan de minimumlengte voldoet. Door bij elke stap de splitsing met de kleinste waarde op te slaan, kunnen de datums worden teruggevonden. Voor elk toegestaan aantal segmenten vindt het algoritme onder het opgegeven model en de beperkingen een globaal RSS-minimale segmentering, in plaats van breuken één voor één hebzuchtig toe te voegen. Bai en Perron (2003) werken deze berekening uit en bespreken zowel zuivere als gedeeltelijke verandering.
‘Globaal’ is hier voorwaardelijk op het gekozen aantal, de regressoren, deterministische termen, trimming en doelfunctie. Het betekent niet dat het statistische model waar is, dat dit aantal klopt of dat de segmentering optimaal is voor elke denkbare specificatie. De procedure kan verschillende aantallen efficiënt vergelijken, maar de selectie van \(m\) is een afzonderlijke inferentie- of modelselectiestap.
Selecteer het aantal breuken met zoekgecorrigeerde inferentie of criteria
Nadat voor kandidaataantallen de beste segmenteringen zijn berekend, zijn er verschillende manieren om \(m\) te kiezen. Een sequentiële toets \(\sup F(\ell+1\mid\ell)\) vergelijkt een model met \(\ell\) breuken met een model met één extra breuk, met een supremumstatistiek over toegestane datums. Dubbelmaximumtoetsen zoals UDmax of WDmax toetsen geen breuken tegenover een alternatief met een onbekend aantal breuken tot een opgegeven maximum. Informatiecriteria, waaronder BIC-achtige criteria, wegen fitverbetering af tegen een straf voor complexiteit. Deze methoden beantwoorden verwante maar niet identieke vragen.
De gewone F-kritieke waarde is doorgaans niet geschikt nadat over onbekende breukdatums is gemaximaliseerd. Onder de nulhypothese van geen breuken zijn de kandidaatdatums niet op dezelfde manier geïdentificeerd als onder het alternatief; daardoor ontstaan niet-standaard asymptotische verdelingen. Kritieke waarden hangen onder meer af van trimming, zuivere of gedeeltelijke verandering, regressoren en aannames over de foutcovariantie. Bai en Perron (1998) leiden toetsen voor meerdere veranderingen af; hun latere studie van kritieke waarden geeft waarden voor verschillende trimming- en modelspecificaties. Andrews (1993) biedt belangrijke resultaten voor instabiliteitstoetsen met één onbekend veranderpunt, maar die kritieke waarden vervangen geen procedure voor meerdere breuken.
Sequentiële toetsen zijn goed te interpreteren, maar de uitkomst kan afhangen van de toetskracht in elke stap en het vooraf vastgelegde maximumaantal breuken. Informatiecriteria kunnen verschillende aantallen selecteren omdat hun straffen verschillen en omdat alle kandidaatmodellen benaderingen kunnen zijn. Meer breuken betekenen niet automatisch een realistischer beschrijving: een kleine fitverbetering kan instabiele segmentcoëfficiënten opleveren. Rapporteer de methode, het maximum, trimming, toetsvolgorde of criterium en de bijbehorende aannames voor kritieke waarden. Als de keuze belangrijk is, toon dan gevoeligheid in plaats van één aantal als zeker te presenteren.
Behandel geschatte datums als onzekere conditionele schattingen
De datums die het criterium minimaliseren zijn puntschattingen onder een opgegeven model. Rapporteer ze niet alsof de gegevens het exacte moment tonen waarop een economische relatie veranderde. Steekproefvariatie, kleine coëfficiëntverschuivingen, dicht bij elkaar liggende breuken, ruis in de uitkomst, weinig variatie in regressoren en een lange minimumsegmentlengte kunnen het criterium rond het minimum vlak maken. Meerdere nabije segmenteringen kunnen dan bijna even goed passen.
Bai en Perron ontwikkelen onder bepaalde voorwaarden betrouwbaarheidsintervallen voor breukdatums. Die intervallen beschrijven steekproefonzekerheid van de gemodelleerde breukdatums; ze omvatten niet alle onzekerheid over de juistheid van de regressiespecificatie, welke variabelen moeten worden opgenomen, het aantal breuken of de trimregel. Als ook het aantal breuken onzeker is, kan een smal datuminterval dat voorwaardelijk op één gekozen aantal is berekend de totale onzekerheid onderschatten.
Maak in rapportages onderscheid tussen de datumconventie, de geschatte waarnemingsindex, de bijbehorende kalenderdatum en het interval voor elke breuk. Zijn intervallen breed of overlappen ze, beschrijf de lokalisatie dan als onnauwkeurig. Kies niet na het bekijken van de uitkomst een datum uit een grafiek en presenteer die vervolgens als onafhankelijk voorspeld gebeurtenismoment. Houd bij vergelijking met een bekende gebeurtenis rekening met de mogelijkheid dat de gebeurtenis en periode zijn gekozen nadat de gegevens zijn bekeken.
Stem inferentie af op seriële afhankelijkheid en veranderende variantie
De RSS-segmentering is een fitcriterium; de geldigheid van toetsen en betrouwbaarheidsintervallen hangt af van aannames over regressoren en fouten. Financiële regressies kunnen seriële correlatie, conditionele heteroskedasticiteit, uitschieters, veranderende volatiliteit, overlappende rendementen of asynchrone waarnemingen bevatten. Als de covariantiematrixschatter en kritieke waarden onafhankelijke fouten met gelijke variantie veronderstellen terwijl residuen afhankelijk of heteroskedastisch zijn, kan de gerapporteerde significantie misleidend zijn, ook als de geschatte breukdatums aannemelijk lijken.
Bai–Perron-werk ontwikkelt methoden onder ruimere voorwaarden, waaronder vormen van heteroskedasticiteit en seriële afhankelijkheid. Gebruik desondanks de covariantiecorrectie en referentiewaarden die bij de concrete situatie passen. Een robuuste of HAC-covariantiematrixschatting herstelt geen ontbrekende dynamiek, endogene regressoren, een verkeerd gespecificeerd conditioneel gemiddelde of een waarnemingskalender die onverenigbare intervallen samenvoegt. Alleen een robuuste standaardfout verandert de RSS-doelfunctie ook niet in een beter datamodel.
Controleer de afhankelijkheid en variantiepatronen van residuen binnen en tussen kandidaatsegmenten. Vermeld of de fouten aannames segmentafhankelijke varianties, seriële correlatie of veranderende regressorverdelingen toestaan en of de theorie van de gekozen toets die gevallen dekt. In zeer korte segmenten is robuuste covariantie schatten extra kwetsbaar; daarom moeten trimming en modeldimensie samen worden gepland. Achtergrond over regressieschattingen en covariantieaannames staat in de uitleg over OLS-regressie.
Rapporteer de breukanalyse zonder er een causale of handelsclaim van te maken
Een reproduceerbaar rapport vermeldt de uitkomst, alle regressoren, transformaties, steekproefperiode en frequentie, intercept en coëfficiëntbeperkingen, de specificatie voor zuivere of gedeeltelijke verandering, het maximale kandidaat-\(m\), trimfractie en minimumlengte, datumconventie, optimalisatiemethode en de toets of het criterium waarmee \(m\) is gekozen. Geef ook het geselecteerde aantal breuken, coëfficiënten per segment, datums en onzekerheidsintervallen, toetsstatistieken, covariantiebehandeling en bron van kritieke waarden. Licht toe welke eindpunten of waarnemingen van de zoektocht zijn uitgesloten.
Een statistisch gevonden breuk is bewijs voor parameterinstabiliteit in de gespecificeerde regressie onder de aannames. De toets bepaalt niet welke gebeurtenis de verandering veroorzaakte, bewijst niet dat een specifieke nieuwsbekendmaking of beleidswijziging verantwoordelijk was en toont niet aan dat coëfficiënten voor of na de breuk blijven gelden. Een breuk kan wijzen op een ontbrekende variabele, gewijzigde gegevensdefinitie, volatiliteitsepisode, meetprobleem of echte economische verandering; de regressietoets maakt geen onderscheid tussen die verklaringen.
Bij kwantitatieve handel gebruikt een zoektocht over de volledige steekproef waarnemingen aan beide kanten van elke geschatte breuk. Handelen alsof de gekozen datum in realtime bekend was, veroorzaakt look-ahead bias. Evalueer een voorgestelde regime-regel chronologisch, schat opnieuw met uitsluitend de informatie die op elke datum beschikbaar was en neem bied-laatspread, kosten, marktimpact, financiering, leenlasten, omzet en latentie mee. Vergelijk met eenvoudige benchmarks met vaste parameters en zonder handel, en reserveer werkelijk latere gegevens voor validatie. Een breuk kan aanleiding geven tot modelcontrole of risicoanalyse; ze bewijst geen voorspellend vermogen of verhandelbaar voordeel.
Bai en Perron (1998) presenteren toetsen en schattingen voor meerdere structurele veranderingen in lineaire modellen in hun oorspronkelijke artikel. Hun berekeningsartikel uit 2003 legt dynamische programmering en gedeeltelijke veranderingen uit; hun artikel over kritieke waarden beschrijft hoe die van het ontwerp afhangen. Andrews' artikel over onbekende veranderpunten biedt een verwante basis voor één breuk. Vergelijk als aanverwante diagnostiek de Chow-toets met vooraf vastgelegde datum met de regressie-CUSUM-toets.
Veelgestelde vragen
Q1Geeft Bai–Perron het werkelijke aantal breuken?
Nee. De methode schat segmenteringen en biedt toetsen of criteria om uit kandidaataantallen te kiezen. De uitkomst hangt af van de regressiespecificatie, trimming, aannames over fouten, het maximumaantal en de selectieregel; ze bewijst niet dat het datagenererende proces precies zoveel breuken bevatte.
Q2Is een breukdatum de datum waarop een economische gebeurtenis de verandering veroorzaakte?
Nee. Het is een onzekere schatting van de locatie van parameterinstabiliteit onder een gefit model. Een oorzaak toeschrijven vereist aanvullend bewijs en een onderzoeksopzet die concurrerende verklaringen uitsluit.
Q3Kan ik rechtstreeks handelen op basis van de geschatte breukdatums?
Niet uitsluitend op basis van een retrospectieve schatting over de volledige steekproef. De zoektocht gebruikt ook waarnemingen na een kandidaatbreuk. Een regel voor realtimegebruik vereist chronologische evaluatie, informatie die op dat moment beschikbaar was, kosten en latere validatie; een gevonden breuk bewijst geen winstgevend signaal.
Bronnen en verder lezen
Probleem melden
We bereiden een e-mail met de link naar dit artikel voor. Mark ontvangt je melding pas nadat je die verstuurt
Snelle check
De gids gelezen? Test jezelf met 3 vragen
Vraag 01
Wat betekent een minimale segmentregel van 15% in een voorbeeld met 240 waarnemingen?
Kies een antwoord om de uitleg te zien
Optiewoordenlijst
A relationship describing how an outcome would differ under a specified intervention or counterfactual change; observed association alone does not identify it.
Lees de uitgebreide gidsMulticollinearityStrong linear dependence among included regressors that makes their separate coefficients imprecise and sensitive to the sample.
Lees de uitgebreide gids