

Test Bai–Perron per rotture strutturali multiple nella regressione
Scopri come i metodi Bai–Perron cercano un numero e date sconosciuti di rotture di regressione, come incidono il trimming e i valori critici e cosa non dimostrano le stime.
In questa guidaQuale domanda pone un test di regressione con rotture multiple
Breve sintesi
I metodi Bai–Perron stimano congiuntamente le date di rottura della regressione per un numero di rotture fissato. Test e criteri di selezione valutano poi quante rotture siano sostenute dai dati. Date e numero dipendono dalla regressione, dalla lunghezza minima dei segmenti, dalle ipotesi sugli errori e dalla procedura di ricerca: non identificano una causa né un vantaggio di trading.
Quale domanda pone un test di regressione con rotture multiple
Una rottura strutturale in una regressione significa che uno o più coefficienti potrebbero essere cambiati in un punto sconosciuto del campione. Una sola stima sull'intero campione può nasconderlo: se la relazione tra rendimento e rischio è positiva in un intervallo e in seguito si indebolisce o si inverte, il coefficiente medio potrebbe non descrivere bene nessuno dei due intervalli. I metodi Bai–Perron trasformano questo problema in una ricerca esplicita tra le possibili partizioni delle osservazioni.
La differenza centrale rispetto al test di Chow è se la data fosse stata fissata in anticipo. Il test di Chow confronta sottocampioni ai lati di una data specificata; provare molte date e riportare il massimo statistico Chow ordinario non conserva la consueta distribuzione di riferimento del test singolo. I test Bai–Perron tengono conto della ricerca sulle date candidate e possono valutare più di una rottura. Per il caso con data prestabilita, consulta la guida al test di Chow.
È importante distinguerli anche dal CUSUM di regressione. Il CUSUM esamina una sequenza temporale di residui ricorsivi per rilevare evidenza contro la stabilità, ma da solo non restituisce un insieme selezionato di più date di rottura. Bai–Perron stima invece una partizione sotto un modello esplicito di regressione a tratti. Nessuno dei due metodi spiega perché una relazione sia cambiata. Per la diagnostica basata sul percorso dei residui, consulta la guida al CUSUM di regressione.
Formula la regressione con date e numero di rotture sconosciuti
Supponiamo di avere \(T\) osservazioni e \(m\) rotture in date intere \(T_1<\cdots<T_m\). Poniamo \(T_0=0\) e \(T_{m+1}=T\), e definiamo il segmento \(j\) come le osservazioni \(T_{j-1}+1,\ldots,T_j\). In un modello di cambiamento strutturale puro,
\[ y_t=x_t'\beta_j+u_t,\qquad T_{j-1}<t\le T_j,\quad j=1,\ldots,m+1. \]
Qui \(y_t\) è la variabile dipendente, \(x_t\) il vettore dei regressori inclusi, \(\beta_j\) il vettore dei coefficienti nel segmento \(j\) e \(u_t\) l'errore. Le incognite non sono solo i coefficienti: salvo che siano fissati dal disegno, bisogna anche stimare o selezionare le date e il numero \(m\). Il modello presuppone inoltre un ordinamento significativo delle osservazioni e un vettore di coefficienti stabile in ciascun segmento secondo la specificazione scelta.
In un esempio finanziario, \(y_t\) potrebbe essere il rendimento di un portafoglio e \(x_t\) potrebbe includere il rendimento di mercato, una variazione dei tassi o una misura di volatilità. Una rottura rilevata significa che, nel campione e secondo la procedura, la media condizionale lineare a tratti si adatta meglio. Non implica che un evento specifico abbia cambiato il coefficiente, che una variabile esplicativa sia esogena o che la relazione resti stabile fuori campione.
È utile distinguere la data dell'osservazione da quella di calendario. Se le osservazioni sono sessioni di negoziazione giornaliere, una rottura tra la sessione 120 e la 121 non equivale necessariamente a un singolo giorno di calendario; festività, quotazioni mancanti e campionamento irregolare incidono sulla corrispondenza. Specifica l'ordinamento del campione e la convenzione con cui riporti la data prima di trattarla come l'ora di un evento.
Scegli consapevolmente tra cambiamento puro e parziale
In un modello di cambiamento strutturale puro, ogni coefficiente di \(\beta_j\) può variare da un segmento all'altro. Questo consente di cambiare l'intercetta e tutte le pendenze, ma richiede più parametri specifici per segmento. Le rotture possono quindi essere difficili da stimare con precisione se i segmenti sono brevi o il vettore dei regressori è ampio. Il cambiamento puro è appropriato solo quando la domanda consente a tutte le relazioni modellate di ridefinirsi.
In un modello di cambiamento strutturale parziale, alcuni coefficienti restano comuni e altri possono cambiare. Per esempio, scriviamo \(\beta_j=(\delta',\gamma_j')'\), dove \(\delta\) è comune a tutti i segmenti e \(\gamma_j\) varia tra segmenti. Questo può rappresentare un vincolo sostantivo: consentire all'intercetta e al coefficiente di esposizione a una politica di cambiare, mantenendo comune l'effetto di una variabile di controllo. Il vincolo cambia sia la funzione obiettivo di adattamento sia la distribuzione di riferimento del test; va dichiarato e non trattato come una semplificazione innocua.
Anche il calcolo è diverso. Con cambiamento puro, la somma dei quadrati dei residui (RSS) di una partizione è la somma delle RSS dei singoli segmenti, quindi la programmazione dinamica può ottimizzare la partizione per un numero fissato di rotture. Nel modello parziale, i coefficienti comuni collegano tutti i segmenti. Bai e Perron descrivono una procedura iterativa: si stimano le date e i coefficienti variabili mantenendo fissi quelli comuni, poi si aggiornano i coefficienti comuni per una partizione data. La semplice ricorrenza additiva delle RSS per segmento non risolve da sola l'intero problema vincolato. Scegli la specificazione in base alla domanda scientifica o previsiva, non in base a quale versione segnala più rotture.
Fissa la lunghezza minima dei segmenti prima di esaminare le date candidate
La ricerca richiede un numero minimo di osservazioni per ciascun segmento. Questa regola di trimming evita di adattare intervalli estremamente brevi che produrrebbero coefficienti instabili, ma esclude anche cambiamenti reali troppo vicini a un'estremità del campione o a un'altra rottura. È una scelta progettuale, non una legge universale.
Consideriamo un esempio chiaramente ipotetico con \(T=240\) osservazioni e una frazione di trimming scelta pari al 15%. Ne segue una lunghezza minima \(h=0{,}15\times240=36\) osservazioni per segmento. Se la data di rottura indica l'ultima osservazione del segmento precedente, con una rottura le date ammissibili sono \(36\le T_1\le204\). Entrambi i lati contengono così almeno 36 osservazioni.
Con due rotture, le coppie di date ammissibili devono soddisfare:
\[ 36\le T_1,\qquad T_1+36\le T_2\le204. \]
In altre parole, \(T_1\le168\); \(T_2\) deve distare almeno 36 osservazioni dalla prima rottura e lasciare 36 osservazioni dopo la seconda. La coppia \((72,156)\) è ammissibile: i tre segmenti hanno 72, 84 e 84 osservazioni. \((80,100)\) non è ammissibile perché il segmento centrale contiene solo 20 osservazioni. Con questo \(h\), in 240 osservazioni possono entrare al massimo cinque rotture: sei segmenti richiedono almeno \(6\times36=216\) osservazioni, mentre sette ne richiedono 252.
Il 15% è qui una scelta progettuale esplicitamente ipotetica, non una raccomandazione predefinita. Una frazione più alta può escludere regimi di breve durata e date vicine ai margini del campione; una più bassa ammette segmenti brevi ma può lasciare informazioni insufficienti per stimare in modo affidabile le pendenze e le quantità di covarianza di lungo periodo. Scegli la regola in base alla frequenza di campionamento, al numero di regressori, alla durata plausibile dei regimi e al metodo inferenziale. Riportala e, se pertinente, mostra se le conclusioni cambiano con valori vicini. Con ritardi o osservazioni mancanti, le implementazioni possono definire in modo diverso la numerosità effettiva e gli estremi; documenta la convenzione adottata.
Usa la programmazione dinamica per trovare una segmentazione globale a numero fisso
In un modello di cambiamento puro con \(m\) fissato, la ricerca delle date si può esprimere come minimizzazione dell'RSS totale dei segmenti:
\[ \min_{T_1,\ldots,T_m}\;\sum_{j=1}^{m+1}\operatorname{SSR}(T_{j-1}+1,T_j), \]
con i vincoli sull'ordine delle date e sulla lunghezza minima dei segmenti. \(\operatorname{SSR}(a,b)\) è la somma minima dei quadrati residui OLS per un segmento adattato alle osservazioni \(a,\ldots,b\). Una ricerca ingenua prova ogni combinazione di date, il cui numero cresce rapidamente con \(T\) e \(m\).
La programmazione dinamica riutilizza sottoproblemi già risolti. Se \(D(r,j)\) è l'RSS minimo per suddividere le osservazioni da 1 a \(j\) in \(r\) segmenti ammissibili, una forma della ricorrenza è
\[ D(r,j)=\min_i\{D(r-1,i)+\operatorname{SSR}(i+1,j)\}, \]
dove il punto di separazione \(i\) è vincolato in modo che i primi \(r-1\) segmenti e l'ultimo rispettino la lunghezza minima. Conservando a ogni passaggio il punto che minimizza il valore, si possono ricostruire le date. Per ogni numero consentito di segmenti, l'algoritmo ottiene la partizione con RSS globalmente minima date la specificazione e i vincoli, invece di aggiungere le rotture una alla volta in modo greedy. Bai e Perron (2003) sviluppano il calcolo e discutono sia il cambiamento puro sia quello parziale.
Qui «globale» è condizionato al numero scelto, ai regressori, ai termini deterministici, al trimming e alla funzione obiettivo. Non significa che il modello statistico sia vero, che quel numero sia corretto o che la partizione sia ottima per ogni specificazione possibile. La procedura può confrontare efficientemente più numeri, ma scegliere \(m\) resta un passaggio separato di inferenza o selezione del modello.
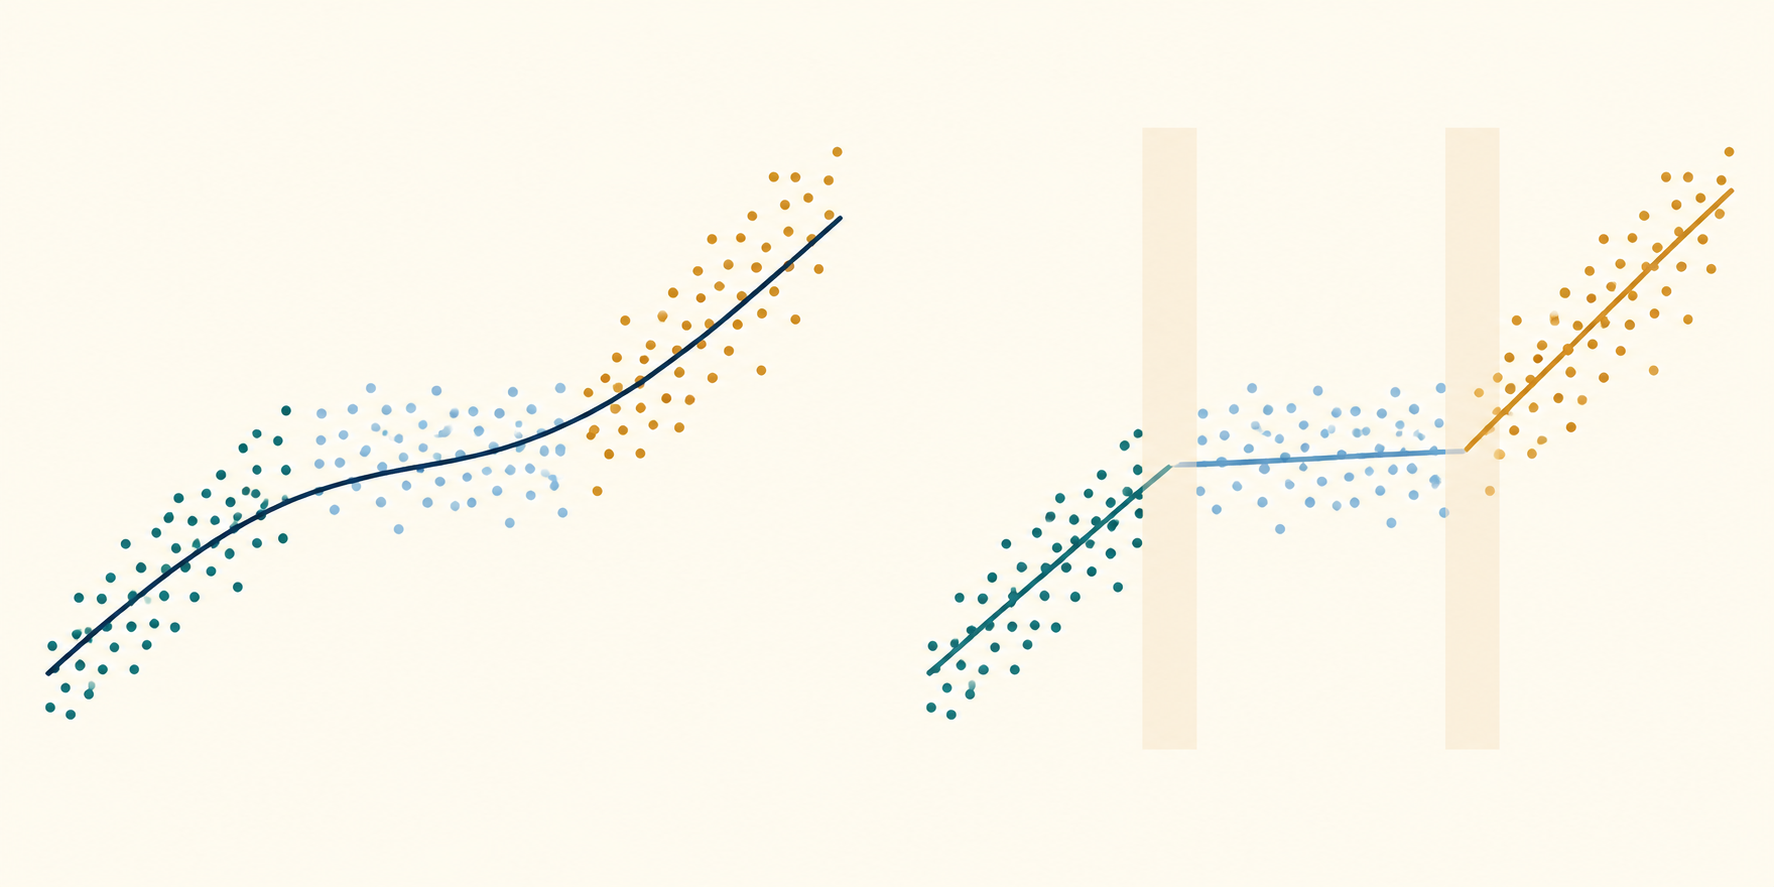
Seleziona il numero di rotture con inferenza corretta per la ricerca o con criteri
Dopo aver calcolato le partizioni migliori per i numeri candidati, ci sono vari metodi per scegliere \(m\). Un test sequenziale \(\sup F(\ell+1\mid\ell)\) confronta un modello con \(\ell\) rotture con uno che ne aggiunge una, usando il supremo della statistica sulle date ammissibili. Test a doppio massimo come UDmax o WDmax verificano l'ipotesi di nessuna rottura contro un'alternativa con numero ignoto fino a un massimo prefissato. I criteri informativi, tra cui quelli di tipo BIC, confrontano il miglioramento dell'adattamento con una penalità di complessità. Questi metodi sono collegati, ma non pongono la stessa domanda.
In generale, dopo aver massimizzato sulle date di rottura sconosciute non è appropriato usare il valore critico F ordinario. Sotto l'ipotesi nulla di nessuna rottura, le date candidate non sono identificate come sotto l'alternativa e ciò produce distribuzioni asintotiche non standard. I valori critici dipendono da caratteristiche come il trimming, il cambiamento puro o parziale, i regressori e le ipotesi sulla covarianza degli errori. Bai e Perron (1998) derivano test per cambiamenti multipli; il successivo studio dei valori critici tabula valori per diverse regole di trimming e specificazioni. Andrews (1993) offre risultati importanti per test di instabilità con un solo punto di cambiamento sconosciuto, ma i suoi valori critici non sostituiscono una procedura per rotture multiple.
I test sequenziali sono interpretabili, ma il risultato può dipendere dalla potenza in ciascun passaggio e dal numero massimo di rotture specificato in anticipo. I criteri informativi possono selezionare numeri diversi a causa delle diverse penalità e perché i modelli candidati possono essere soltanto approssimazioni. Più rotture non significano automaticamente una descrizione più realistica: un piccolo miglioramento dell'adattamento può comportare coefficienti di segmento instabili. Riporta metodo, massimo, trimming, sequenza di test o criterio e ipotesi sui valori critici usati. Se la scelta è rilevante, mostra la sensibilità invece di presentare un solo numero come certo.
Tratta le date stimate come stime condizionate e incerte
Le date che minimizzano il criterio sono stime puntuali sotto un modello specificato. Non presentarle come se i dati rivelassero l'istante esatto in cui una relazione economica è cambiata. Variabilità campionaria, piccoli cambiamenti dei coefficienti, rotture ravvicinate, esiti rumorosi, regressori con poca variabilità e una lunga lunghezza minima possono appiattire la funzione obiettivo vicino al minimo. Diverse partizioni vicine possono quindi adattarsi quasi altrettanto bene.
Bai e Perron sviluppano intervalli di confidenza per le date di rottura sotto condizioni esplicite. Tali intervalli descrivono l'incertezza campionaria delle date modellate; non includono ogni incertezza sulla corretta specificazione della regressione, sulle variabili da includere, sul numero di rotture o sulla regola di trimming. Se anche il numero di rotture è incerto, un intervallo ristretto condizionato a un solo numero selezionato può sottostimare l'incertezza complessiva.
Nel resoconto distingui la convenzione di datazione, l'indice di osservazione stimato, la corrispondente data di calendario e l'intervallo per ogni rottura. Se gli intervalli sono ampi o si sovrappongono, descrivi la localizzazione come poco precisa. Non scegliere una data da un grafico dopo aver visto il risultato e poi presentarla come un evento previsto in modo indipendente. Se confronti le rotture stimate con un evento noto, considera che l'evento e la finestra potrebbero essere stati selezionati dopo aver osservato i dati.
Adegua l'inferenza alla dipendenza seriale e ai cambiamenti della varianza
La partizione RSS è un criterio di adattamento; la validità dei test e degli intervalli di confidenza dipende dalle ipotesi sui regressori e sugli errori. Le regressioni finanziarie possono presentare autocorrelazione, eteroschedasticità condizionale, valori anomali, volatilità variabile, rendimenti sovrapposti o osservazioni asincrone. Se lo stimatore di covarianza e i valori critici presuppongono errori indipendenti e con varianza costante, mentre i residui sono dipendenti o eteroschedastici, la significatività riportata può risultare fuorviante anche se le date stimate sembrano plausibili.
I lavori Bai–Perron sviluppano procedure sotto condizioni più generali, incluse forme di eteroschedasticità e dipendenza seriale. Occorre comunque usare una correzione di covarianza e valori di riferimento adatti al caso concreto. Una stima robusta o HAC della covarianza non corregge dinamiche omesse, regressori endogeni, una media condizionale mal specificata o un calendario che combini intervalli incompatibili. Né un errore standard robusto, da solo, trasforma la funzione obiettivo RSS in un modello migliore dei dati.
Controlla dipendenza e andamenti della varianza dei residui all'interno e tra i segmenti candidati. Specifica se le ipotesi sugli errori consentono varianze specifiche per segmento, correlazione seriale o distribuzioni dei regressori variabili, e se la teoria del test selezionato li copre. Nei segmenti molto brevi, la stima robusta della covarianza è particolarmente fragile: per questo trimming e dimensione del modello vanno pianificati insieme. Per i fondamenti della stima e delle ipotesi di covarianza nella regressione, consulta la guida alla regressione OLS.
Riporta l'analisi delle rotture senza trasformarla in un'affermazione causale o di trading
Un rapporto riproducibile indica il risultato, tutti i regressori, le trasformazioni, l'intervallo temporale e la frequenza del campione, l'intercetta e i vincoli sui coefficienti, la specificazione di cambiamento puro o parziale, il massimo \(m\) considerato, la frazione di trimming e la lunghezza minima, la convenzione di datazione, il metodo di ottimizzazione e il test o criterio usato per scegliere \(m\). Include il numero selezionato, i coefficienti per segmento, date e intervalli di incertezza, statistiche di test, trattamento della covarianza e fonte dei valori critici. Spiega eventuali estremi o osservazioni esclusi dalla ricerca.
Una rottura rilevata statisticamente fornisce evidenza di instabilità dei parametri nella regressione specificata e sotto le relative ipotesi. Non identifica l'evento che ha causato il cambiamento, non dimostra che una specifica notizia o politica ne sia responsabile e non mostra che i coefficienti prima e dopo la rottura persisteranno. La rottura può riflettere una variabile omessa, un cambiamento nella definizione dei dati, un episodio di volatilità, un problema di misurazione o un cambiamento economico reale; il test di regressione non distingue queste spiegazioni.
Nel trading quantitativo, una ricerca sull'intero campione usa osservazioni da entrambi i lati di ogni rottura stimata. Agire come se la data selezionata fosse stata nota in tempo reale introduce look-ahead bias. Valuta in ordine cronologico ogni regola di regime proposta e ristimala solo con le informazioni disponibili a ciascuna data; includi spread, commissioni, impatto di mercato, finanziamento, costi di prestito, turnover e latenza. Confrontala con riferimenti semplici a parametri fissi e senza operazioni, e conserva dati realmente successivi per la validazione. Una rottura può motivare una revisione del modello o del rischio; non dimostra capacità predittiva né un vantaggio investibile.
Bai e Perron (1998) presentano test e stima per cambiamenti strutturali multipli nei modelli lineari nel loro articolo originale. Il loro articolo di calcolo del 2003 spiega la programmazione dinamica e i modelli di cambiamento parziale; il loro articolo sui valori critici illustra come questi varino con il disegno. L'articolo di Andrews sui punti di cambiamento sconosciuti offre una base correlata per una singola rottura. Tra le diagnostiche vicine, confronta il test di Chow con data prestabilita con il CUSUM di regressione.
Domande frequenti
Q1Bai–Perron mi dice il numero vero di rotture?
No. Il metodo stima partizioni e fornisce test o criteri per scegliere tra numeri candidati. Il risultato dipende dalla specificazione della regressione, dal trimming, dalle ipotesi sugli errori, dal massimo consentito e dalla regola di selezione; non dimostra che il processo generatore avesse esattamente quel numero di rotture.
Q2La data di rottura è la data in cui un evento economico ha causato il cambiamento?
No. È una stima della posizione di instabilità dei parametri sotto un modello adattato, con incertezza campionaria. Attribuire una causa richiede evidenze aggiuntive e un disegno che escluda spiegazioni concorrenti.
Q3Posso fare trading direttamente sulle date di rottura stimate?
Non basandoti solo su una stima retrospettiva dell'intero campione. La ricerca usa anche osservazioni successive alla rottura candidata. Una regola in tempo reale richiede valutazione cronologica, informazioni disponibili al momento, costi e validazione successiva; una rottura rilevata non dimostra un segnale redditizio.
Fonti e approfondimenti
Segnala un problema
Prepareremo un’e-mail con il link a questo articolo. Mark riceverà la segnalazione solo dopo l’invio
Controllo rapido
Hai finito la guida? Verifica ciò che hai capito con 3 domande
Domanda 01
In un esempio con 240 osservazioni, che cosa implica una regola di segmento minimo del 15%?
Scegli una risposta per vedere la spiegazione
Glossario delle opzioni
A relationship describing how an outcome would differ under a specified intervention or counterfactual change; observed association alone does not identify it.
Leggi la guida completaMulticollinearityStrong linear dependence among included regressors that makes their separate coefficients imprecise and sensitive to the sample.
Leggi la guida completa