

Fama–MacBeth रिग्रेशन: दो चरणों में जोखिम प्रीमियम
समय-श्रृंखला beta से तारीख़-विशिष्ट cross-sectional risk price तक Fama–MacBeth प्रक्रिया समझें, फिर standard error, Shanken adjustment और HAC inference का अंतर जानें।
इस गाइड मेंसमय-श्रृंखला beta नहीं, exposure की कीमत अनुमानित करें
संक्षिप्त सारांश
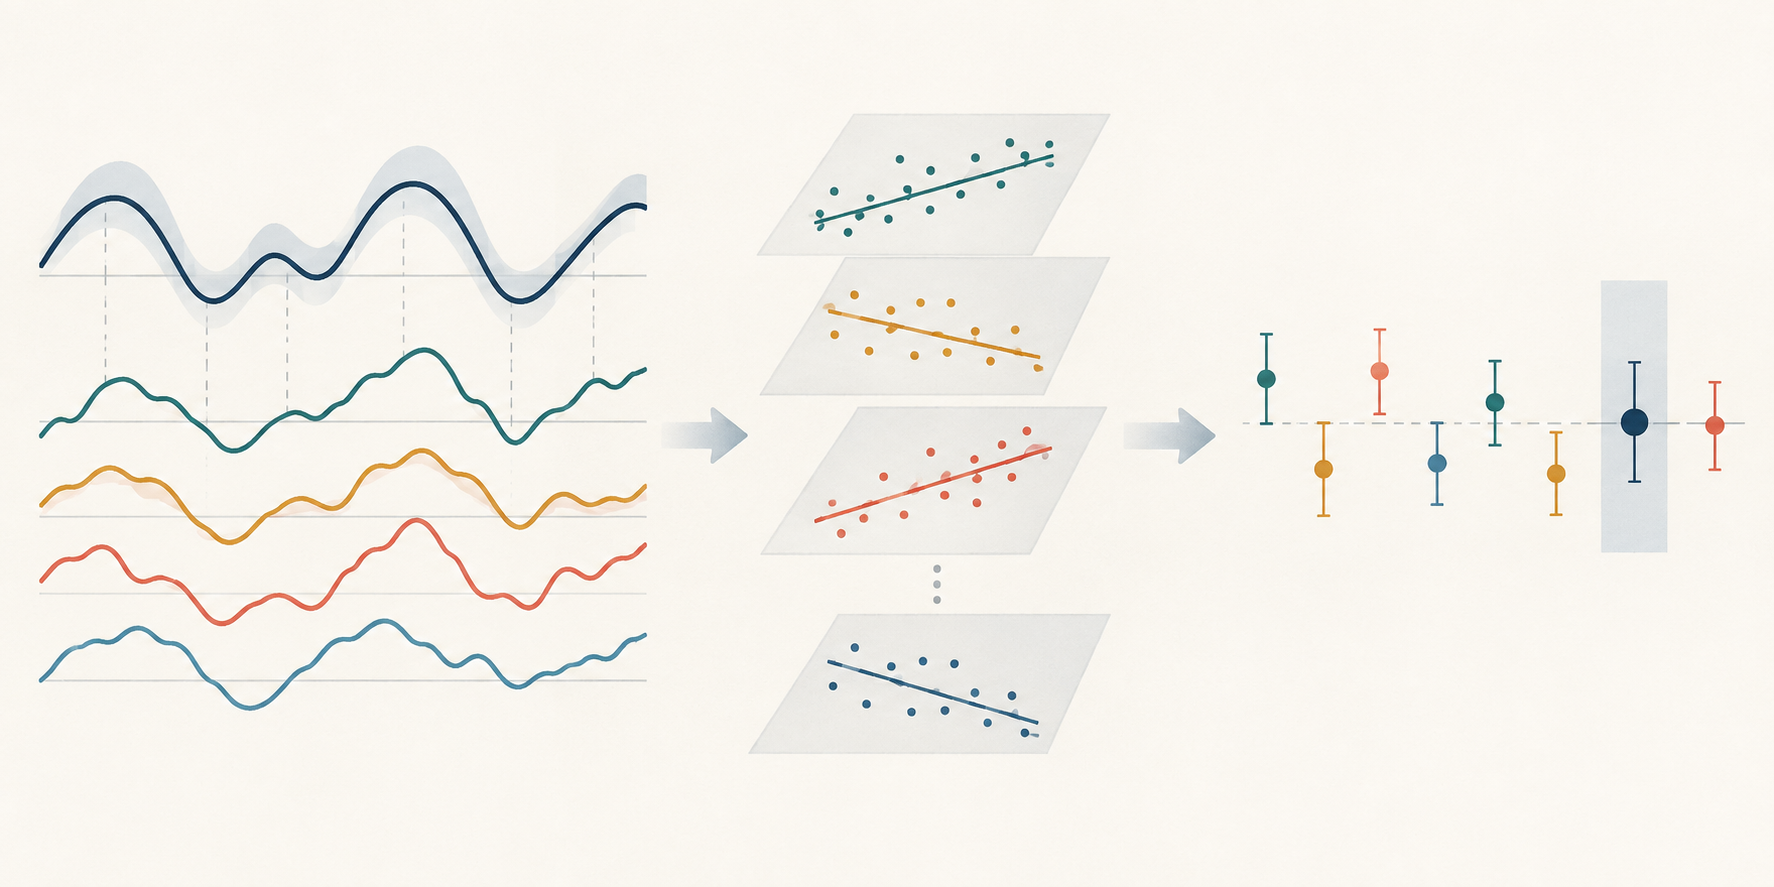
Fama–MacBeth प्रक्रिया हर परीक्षण-परिसंपत्ति का factor exposure उसकी समय-श्रृंखला से अनुमानित करती है, हर तारीख पर परिसंपत्तियों के रिटर्न को अनुमानित exposure पर cross-sectionally regress करती है, और फिर तारीख़-विशिष्ट risk-price slopes का समय के साथ औसत लेती है। slopes की समय-श्रृंखला से सामान्य uncertainty calculation मिलती है। लेकिन दूसरे चरण का standard error अनुमानित beta, serial dependence या गलत तरह से निर्दिष्ट pricing model को अपने-आप शामिल नहीं करता। औसत risk price का सांख्यिकीय रूप से महत्वपूर्ण होना ट्रेडिंग लाभ का अनुमान नहीं है।
समय-श्रृंखला beta नहीं, exposure की कीमत अनुमानित करें
Factor beta और factor risk price अलग सवालों का जवाब देते हैं। beta बताता है कि पहले चरण की time-series regression में किसी परिसंपत्ति का return factor के साथ कैसे चला। Risk-price coefficient, जिसे अक्सर \(\lambda\) लिखा जाता है, दूसरे चरण के cross-section में बताता है कि अलग-अलग अनुमानित beta वाली परिसंपत्तियों के रिटर्न कैसे भिन्न होते हैं। Fama–MacBeth प्रक्रिया हर तारीख के लिए risk price अनुमानित करती है, फिर समय के साथ उन अनुमानों का सार निकालती है।
यह तरीका तब उपयोगी है जब शोध का प्रश्न यह हो कि किसी प्रस्तावित risk factor का exposure, चुने गए शेयरों या पोर्टफोलियो के समूह में औसत रिटर्न से जुड़ा है या नहीं। यह asset-pricing की सांख्यिकीय प्रक्रिया है, causal design नहीं। यह अपने-आप ऐसा पोर्टफोलियो भी परिभाषित नहीं करती जिसे उस समय उपलब्ध सूचना से कारोबार किया जा सके।
Fama और MacBeth के मूल अध्ययन ने NYSE शेयरों पर जोखिम और रिटर्न की बार-बार cross-sectional regressions कीं। बाद के काम, जिनमें Fama और French के empirical tests शामिल हैं, ने औसत risk prices का अनुमान लगाने और परीक्षण करने के लिए महीने-दर-महीने cross-sectional slopes को सामान्य तरीका बनाया। इस प्रक्रिया को दो जुड़ी estimation समस्याओं के रूप में समझना बेहतर है, जिनमें हर चरण की धारणाएँ अलग हैं।
पहला चरण: हर परीक्षण-परिसंपत्ति का exposure अनुमानित करें
हर परिसंपत्ति या परीक्षण-पोर्टफोलियो \(i\) के लिए ऐसी time-series regression अनुमानित करें:
\[ r^{e}_{i,t} = \alpha_i + \boldsymbol{\beta}_i^\top \mathbf{f}_t + \varepsilon_{i,t}, \]
जहाँ \(r^{e}_{i,t}\) परिसंपत्ति का excess return है, \(\mathbf{f}_t\) तारीख़ \(t\) पर factor returns का vector है, और \(\boldsymbol{\beta}_i\) exposure vector है। अनुमानित \(\hat{\boldsymbol{\beta}}_i\) दूसरे चरण में explanatory variable बन जाता है। केवल market वाला उदाहरण एक beta उपयोग करता है; multi-factor उदाहरण में हर factor के लिए एक अनुमानित loading होती है।
पहले चरण में slopes अनुमानित करने के लिए factors में समय के साथ पर्याप्त variation चाहिए। लंबी window अधिक observations दे सकती है, लेकिन अलग-अलग market regimes को मिला सकती है। छोटी window हाल का exposure दिखा सकती है, पर beta estimates को अधिक noisy छोड़ती है। Return frequency, sample dates, factor construction, missing-data नियम, intercept का उपयोग और estimation window बताएं।
इसका अर्थ यह नहीं कि हर beta हमेशा पूरे sample पर अनुमानित हो। Ex-post asset-pricing test में full-sample beta अध्ययन के sample का वर्णन कर सकती है। ऐतिहासिक trading simulation में भविष्य के observations से निकली beta का उपयोग करने से भविष्य की जानकारी अतीत में चली जाएगी। उस उपयोग के लिए हर simulated decision से पहले उपलब्ध data से point-in-time beta अनुमानित करनी होगी।
दूसरा चरण: हर तारीख के cross-section में exposure की कीमत निकालें
हर तारीख़ \(t\) पर उस तारीख की test-asset returns को पहले चरण की beta पर regress करें:
\[ r^{e}_{i,t} = \lambda_{0,t} + \hat{\boldsymbol{\beta}}_i^\top \boldsymbol{\lambda}_t + \eta_{i,t}. \]
\(\boldsymbol{\lambda}_t\) में तारीख़-विशिष्ट risk prices होती हैं। एक factor होने पर cross-sectional slope \(\lambda_t\), उस तारीख को अनुमानित beta की एक इकाई से जुड़ा return difference मापती है। \(\lambda_{0,t}\) अलग cross-sectional intercept है। उसे स्वतंत्र अनुमानित करना है, constrain करना है या zero-beta asset का return मानना है—यह परीक्षणाधीन model और raw या excess returns के उपयोग पर निर्भर करता है।
दूसरी regression एक तारीख पर परिसंपत्तियों के बीच cross-section है; यह दूसरी time-series regression नहीं है। इसका fit test assets की संख्या और संरचना, उनकी अनुमानित beta के फैलाव और उन beta के correlation पर निर्भर करता है। अगर assets की beta में बहुत कम अंतर है, तो risk prices को अलग पहचानने के लिए cross-section में कम जानकारी है। लगभग समान exposure वाली बहुत-सी assets जोड़ने से अनुपस्थित exposure variation पैदा नहीं होती।
इस regression को दोहराने से \(\hat{\boldsymbol{\lambda}}_1,\ldots,\hat{\boldsymbol{\lambda}}_T\) की series मिलती है। Factor \(k\) का Fama–MacBeth estimate समय का औसत है:
\[ \bar{\lambda}_k = \frac{1}{T}\sum_{t=1}^{T}\hat{\lambda}_{k,t}. \]
औसत की return units और frequency दूसरे चरण के returns जैसी ही होती है। Cross-section weights, अनुपस्थित तिथियाँ या asset universe में बदलाव उस औसत का अर्थ बदलते हैं, इसलिए इन विकल्पों की रिपोर्ट करें।
उदाहरण एक महीने और औसत को अलग दिखाता है
मान लें, तीन परीक्षण-पोर्टफोलियो के पहले चरण में अनुमानित market beta \(0.5\), \(1.0\) और \(1.5\) हैं। एक काल्पनिक महीने में उनके excess returns \(0.3\%\), \(0.8\%\) और \(1.3\%\) हैं। ये तीन बिंदु इस रेखा पर हैं:
\[ r^{e}_{i,t} = -0.2\% + 1.0\%\times\hat{\beta}_{i}. \]
उस महीने का अनुमानित slope beta की प्रति इकाई 1.0 percentage point है और intercept \(-0.2\%\) है। यह जानबूझकर छोटा, सटीक fit वाला उदाहरण है; इससे साबित नहीं होता कि market beta priced है, और तीन बिंदु उपयोगी empirical test नहीं देते।
अब मान लें कि छह अलग महीनों में दूसरे चरण के slopes beta की प्रति इकाई \(0.8\%\), \(-0.4\%\), \(1.0\%\), \(-0.2\%\), \(0.6\%\), और \(0.0\%\) हैं। उनका arithmetic mean है:
\[ (0.8 - 0.4 + 1.0 - 0.2 + 0.6 + 0.0)/6 = 0.3\%\text{ प्रति माह}. \]
पहले महीने का slope अंतिम Fama–MacBeth estimate नहीं है। अनुमान छह तारीख़-विशिष्ट slopes का औसत है। नकारात्मक महीने भी गणना में रहते हैं; केवल सकारात्मक महीनों को चुनने से estimand बदलता है और एक और selection step जुड़ती है। ये गढ़े हुए आँकड़े केवल गणना दिखाते हैं, बाजार का परिणाम या factor की return-predictive क्षमता का दावा नहीं।
सामान्य standard error में inference का आयाम समय है
सबसे सरल गणना में \(T\) मासिक slopes का sample standard deviation \(s_\lambda\) लेकर उसे \(\sqrt{T}\) से बाँटते हैं:
\[ \operatorname{SE}(\bar{\lambda}) = \frac{s_\lambda}{\sqrt{T}}. \]
संबंधित t-statistic अनुमानित औसत slope को इस standard error से बाँटता है। औसत risk price की uncertainty के लिए समय दोहराया जाने वाला आयाम है। परिसंपत्तियों की संख्या \(N\) तय करती है कि हर मासिक cross-section slope कितनी अच्छी तरह अनुमानित कर सकता है; समय-औसत के standard error में यह \(T\) का स्थान नहीं लेती।
ऊपर के छह illustrative slopes के लिए sample standard deviation करीब 0.576 percentage point प्रति माह है। इसे \(\sqrt{6}\) से बाँटने पर सामान्य standard error लगभग 0.235 percentage point होता है; \(0.3/0.235\) करीब 1.28 है। छह observations विश्वसनीय significance assessment के लिए बहुत कम हैं। यह गणना केवल दिखाती है कि सकारात्मक औसत और सटीक अनुमानित औसत एक बात नहीं।
सामान्य standard error slopes की time series संबंधी शर्तों पर भी निर्भर करता है। यदि estimates serially dependent हैं, तो स्वतंत्र observations मानने वाला standard error uncertainty को गलत आँक सकता है। छोटा sample या परिसंपत्तियों का बदलता मिश्रण asymptotic t-statistics को खास तौर पर कमज़ोर बनाता है। सिर्फ cross-sectional asset count नहीं, \(\lambda_t\) series की लंबाई और frequency भी बताएं।
Fama–MacBeth और pooled OLS के point estimates हमेशा अलग नहीं होते
“Fama–MacBeth” और “pooled panel regression” को अक्सर ऐसे आमने-सामने रखा जाता है मानो दोनों से अलग slopes आना तय हो। एक महत्वपूर्ण विशेष स्थिति है: हर तारीख़ पर वही परिसंपत्तियाँ हों, beta regressors समय में स्थिर रहें, और हर मासिक cross-section में ordinary least-squares का वही design हो, तो तारीख़-विशिष्ट OLS coefficients का औसत pooled OLS के common-slope coefficient के बराबर होता है। दोनों उसी balanced set of cross-sectional regressions का सार देते हैं।
यह समानता तब टूट सकती है जब asset set या weights तारीख के साथ बदलें, beta समय में बदलें, panel unbalanced हो, controls अलग हों या pooled model अतिरिक्त प्रतिबंध लगाए। तब प्रक्रियाएँ तारीखों या observations को अलग-अलग weight कर सकती हैं और sample के अलग प्रश्नों का उत्तर दे सकती हैं। केवल नाम के आधार पर विधि न चुनें; design matrix, weighting scheme और target coefficient स्पष्ट करें।
Point estimates समान होने पर भी uncertainty calculation अलग हो सकती है। Fama–MacBeth inference cross-sectional slopes के समयगत बदलाव का उपयोग करता है। Pooled regression को panel की error structure के अनुरूप covariance estimator चाहिए। तारीख या asset पर clustering, two-way covariance estimate और time-series HAC estimate अलग धारणाओं पर आधारित हैं; model को pooled या Fama–MacBeth कहने मात्र से कोई विधि सही नहीं हो जाती।
अनुमानित beta और HAC uncertainty के अलग स्रोतों को संभालते हैं
दूसरा चरण \(\hat{\boldsymbol{\beta}}_i\) को ज्ञात मानता है, जबकि वह पहले चरण की अनुमानित regression से आया है। Generated regressor में error risk-price estimate और उसकी uncertainty को प्रभावित कर सकता है। Shanken का विश्लेषण निर्दिष्ट asset-pricing setup के तहत beta-pricing inference के लिए adjustment निकालता है; यह ऐसा सार्वभौमिक multiplier नहीं जो हर two-pass design को ठीक कर दे। बाद के काम अलग स्थितियों में large-sample व्यवहार और वैकल्पिक estimators की पड़ताल करते हैं। इस्तेमाल किया गया correction या inference तरीका तथा उसे प्रासंगिक बनाने वाली धारणाएँ बताएं।
\(\hat{\lambda}_{k,t}\) में serial correlation अलग समस्या है। उदाहरण के लिए, कई महीनों के overlapping returns से पास-पास की तारीख़ों के slopes में समान return observations आ सकते हैं। Newey–West covariance estimate जैसा heteroskedasticity-and-autocorrelation-consistent estimator चुनी गई lag window तक serial dependence को ध्यान में रखकर समय-औसत की estimated variance समायोजित करता है। यह पहले चरण की beta-estimation error दूसरे चरण में वापस नहीं जोड़ता, गलत factor specification ठीक नहीं करता और look-ahead bias नहीं हटाता। इसके उलट, Shanken adjustment lambda series की dependence की जाँच का विकल्प नहीं।
Jagannathan और Wang तथा Shanken और Zhou विशेष model और sampling conditions के तहत beta-pricing procedures के गुणों का अध्ययन करते हैं। उनके निष्कर्ष इस बात का कारण हैं कि वास्तविक two-pass design का वर्णन करें, न कि यह blanket rule दोहराएँ कि सामान्य Fama–MacBeth standard errors हमेशा कम या हमेशा वैध होते हैं। बताएं beta एक बार अनुमानित है या समय-समय पर update होती है, lambda series dependence कैसे संभाली गई, generated-beta correction लगा या नहीं, और यह चुनाव प्रश्न से कैसे मेल खाता है।
महत्वपूर्ण औसत risk price ट्रेडिंग लाभ का अनुमान नहीं
शून्य से सांख्यिकीय रूप से अलग सकारात्मक औसत \(\lambda\) का अर्थ है कि चुने गए test-asset universe, factor definition, beta estimates और inference procedure के तहत sample में अधिक अनुमानित exposure वाली परिसंपत्तियों का औसत return अधिक था। यह नहीं दिखाता कि निवेशक लागत के बाद उस spread को कमा सकता था, factor return का कारणात्मक स्रोत है, या pricing model सही है।
Factor set, sample period, portfolio construction, beta window, test assets या weighting scheme बदलने पर नतीजा बदल सकता है। कई factors, sample cuts और specifications में खोज multiple-testing की समस्या जोड़ती है। एक अनुमानित risk price की जाँच सभी assets की संयुक्त pricing error का सार भी नहीं देती। स्पष्ट करें कि नतीजा conditional association है, model-based pricing test है या out-of-sample forecast; इन शब्दों को एक-दूसरे के बदले न इस्तेमाल करें।
वास्तविक या simulated strategy में exposure और portfolio weights केवल उस समय उपलब्ध जानकारी से बननी चाहिए। Executable entry prices, turnover, trading costs, financing, capacity और rebalancing rule भी चाहिए। Factor beta exposure का अनुमान है; औसत \(\lambda\) ऐसे portfolio का return नहीं जो अपने-आप beta premium कमा लेता है। आगे के लिए factor loading और factor model गाइड, robust standard error और HAC गाइड, और rank information coefficient गाइड देखें।
डिज़ाइन दर्ज करें ताकि दूसरा शोधकर्ता इसे दोहरा सके
व्याख्यायोग्य नतीजे में test assets, factor returns, उपयोग होने पर risk-free series, return units, तारीख़ की frequency और sample period की पहचान होनी चाहिए। यह भी दर्ज करें कि हर beta कैसे अनुमानित हुई, पहले चरण की estimation window दूसरे चरण की test period से overlap करती है या नहीं, हर तारीख़ पर कौन-सी assets शामिल हैं, missing returns और बदलती membership कैसे संभाली गई, cross-sections को weight किया या नहीं, और intercept शामिल या constrained है।
Inference के लिए तारीख़-विशिष्ट slopes की कुल संख्या \(T\), उनका time-series mean और dispersion, standard-error estimator, कोई HAC bandwidth, beta-estimation correction और finite-sample choices बताएं। t-statistics के साथ beta dispersion और cross-sectional fit भी दिखाएँ; assets की बड़ी संख्या लगभग समान exposure की भरपाई नहीं करती। उचित वैकल्पिक windows, factor definitions और test-asset construction की तुलना करें, लेकिन केवल वह संस्करण न चुनें जिसमें p-value संयोग से सबसे कम हो।
मूल विधि और उसके applications उदाहरण हैं; यह गारंटी नहीं कि हर आधुनिक dataset उनकी धारणाएँ पूरी करे। डिज़ाइन के अलग पहलुओं पर Fama और MacBeth का 1973 का पेपर, Fama और French के 1992 cross-sectional tests, Shanken का beta-pricing विश्लेषण, Jagannathan और Wang का asymptotic विश्लेषण, Shanken और Zhou का beta-pricing estimators की तुलना, तथा Newey और West की HAC covariance विधि चर्चा करते हैं। रिपोर्ट किए गए coefficient के साथ उसकी धारणाएँ भी पढ़ें।
आम सवाल
Q1क्या Fama–MacBeth regression causal test है?
नहीं। चुने गए pricing model और test-asset design के तहत यह अनुमानित exposure और returns के बीच संबंध का अनुमान लगाती है। Causal व्याख्या के लिए अलग identification argument चाहिए।
Q2क्या अधिक assets जोड़ने से risk-price estimate हमेशा अधिक सटीक होता है?
नहीं। अधिक assets किसी तारीख़ का cross-section सुधार सकते हैं, लेकिन precision इस पर भी निर्भर करती है कि beta कितनी अलग हैं, कितनी अच्छी तरह अनुमानित हुईं और औसत में कितनी तारीख़ें शामिल हैं।
Q3HAC standard error कब उपयोग करना चाहिए?
जब तारीख़-विशिष्ट risk-price series में heteroskedasticity या serial dependence हो सकती है, जैसे overlapping returns में, तब इस पर विचार करें। Lag window बताएं और याद रखें कि HAC पहले चरण की beta-estimation error को ठीक नहीं करता।
स्रोत और आगे पढ़ें
समस्या की रिपोर्ट करें
हम इस लेख का लिंक जोड़कर ईमेल तैयार करेंगे। भेजने के बाद ही Mark को आपकी रिपोर्ट मिलेगी
त्वरित जाँच
गाइड पढ़ने के बाद 3 सवालों से खुद को जाँचें
सवाल 01
मानक two-pass प्रक्रिया में तारीख़ t पर दूसरे चरण का slope क्या अनुमानित करता है?
व्याख्या देखने के लिए एक उत्तर चुनें
विकल्प शब्दावली
A model decomposing asset returns into exposure to a small set of common factors and an asset-specific residual.
विस्तृत गाइड पढ़ेंHeteroskedasticityVariation in the conditional error variance across regressor values or states, invalidating an equal-variance covariance formula.
विस्तृत गाइड पढ़ेंएट द मनीवह स्थिति जिसमें विकल्प का स्ट्राइक मूल्य अंतर्निहित परिसंपत्ति के बाजार मूल्य के बहुत करीब हो। उसमें अभी महत्वपूर्ण आंतरिक मूल्य न हो, फिर भी बचे हुए समय और अनिश्चितता के कारण प्रीमियम हो सकता है।
विस्तृत गाइड पढ़ें