

Tests de Bai–Perron des ruptures structurelles multiples en régression
Découvrez comment les méthodes de Bai–Perron recherchent un nombre et des dates inconnus de ruptures dans une régression, comment le trimming et les valeurs critiques interviennent, et ce que les estimations ne permettent pas d'établir.
Dans ce guideQuelle question pose un test de régression à ruptures multiples
Bref résumé
Les méthodes de Bai–Perron estiment conjointement les dates de rupture d'une régression pour un nombre de ruptures fixé. Des tests ou des critères de sélection évaluent ensuite le nombre de ruptures étayé par les données. Les dates et leur nombre dépendent de la régression, de la longueur minimale des segments, des hypothèses sur les erreurs et de la procédure de recherche ; ils n'identifient ni une cause ni un avantage de trading.
Quelle question pose un test de régression à ruptures multiples
Une rupture structurelle dans une régression signifie qu'un ou plusieurs coefficients ont pu changer à un point inconnu de l'échantillon. Une estimation unique sur tout l'échantillon peut masquer ce changement : si la relation entre rendement et risque est positive sur une période, puis plus faible ou inversée sur une autre, son coefficient moyen peut mal décrire chacune des deux périodes. Les méthodes de Bai–Perron transforment cette question en une recherche explicite parmi les partitions possibles des observations.
La différence essentielle avec le test de Chow est de savoir si la date a été fixée à l'avance. Un test de Chow compare des sous-échantillons autour d'une date indiquée ; tester de nombreuses dates et ne rapporter que le plus grand statistique de Chow ordinaire ne conserve pas la distribution de référence habituelle d'un test unique. Les tests de Bai–Perron tiennent compte de la recherche parmi les dates candidates et peuvent évaluer plusieurs ruptures. Pour le cas d'une date spécifiée à l'avance, voir le guide du test de Chow.
Il faut aussi distinguer cette méthode du CUSUM de régression. Le CUSUM examine une trajectoire ordonnée de résidus récursifs pour rechercher des indices contre la stabilité, mais ne fournit pas à lui seul un ensemble choisi de dates de ruptures multiples. Bai–Perron estime plutôt une partition selon un modèle explicite de régression par segments. Aucune de ces méthodes n'explique pourquoi la relation a changé. Pour le diagnostic fondé sur la trajectoire des résidus, voir le guide du CUSUM de régression.
Écrire la régression avec des dates et un nombre de ruptures inconnus
Supposons que l'échantillon contienne \(T\) observations et \(m\) ruptures aux dates entières \(T_1<\cdots<T_m\). Posons \(T_0=0\) et \(T_{m+1}=T\), et définissons le segment \(j\) comme les observations \(T_{j-1}+1,\ldots,T_j\). Dans un modèle de changement structurel pur,
\[ y_t=x_t'\beta_j+u_t,\qquad T_{j-1}<t\le T_j,\quad j=1,\ldots,m+1. \]
Ici, \(y_t\) est le résultat étudié, \(x_t\) le vecteur des variables explicatives incluses, \(\beta_j\) le vecteur des coefficients du segment \(j\) et \(u_t\) l'erreur. Les inconnues ne se limitent pas aux coefficients : sauf contrainte préalable dans le plan d'analyse, il faut aussi estimer ou choisir les dates de rupture et leur nombre \(m\). Le modèle suppose en outre un ordre pertinent des observations et un vecteur de coefficients stable dans chaque segment selon la spécification retenue.
Dans un exemple financier, \(y_t\) pourrait être le rendement d'un portefeuille et \(x_t\) inclure le rendement du marché, une variation de taux ou une mesure de volatilité. Une rupture détectée indique que, dans l'échantillon et selon la procédure, la moyenne conditionnelle linéaire par segments s'ajuste mieux. Elle ne signifie pas qu'un événement désigné a modifié le coefficient, qu'une variable explicative est exogène ni que la relation reste stable hors échantillon.
Il faut distinguer date d'observation et date calendaire. Si les données correspondent à des séances boursières quotidiennes, une rupture entre les séances 120 et 121 ne correspond pas nécessairement à une seule journée calendaire ; jours fériés, cotations manquantes et intervalles irréguliers modifient cette correspondance. Précisez l'ordre de l'échantillon et la convention de datation avant de traiter la rupture comme l'horodatage d'un événement.
Choisir délibérément entre changement pur et partiel
Dans un modèle de changement structurel pur, chaque coefficient de \(\beta_j\) peut varier entre les segments. L'ordonnée à l'origine et toutes les pentes peuvent changer, mais le nombre de paramètres propres aux segments augmente. Les ruptures peuvent donc être difficiles à estimer précisément si les segments sont courts ou si le vecteur des variables explicatives est grand. Le changement pur convient uniquement si la question autorise toutes les relations modélisées à se réinitialiser.
Dans un modèle de changement structurel partiel, certains coefficients restent communs et d'autres peuvent changer. Par exemple, écrivons \(\beta_j=(\delta',\gamma_j')'\), avec \(\delta\) commun à tous les segments et \(\gamma_j\) propre au segment. Cela peut traduire une restriction de fond : laisser changer l'ordonnée à l'origine et la pente associée à une exposition politique, tout en imposant un effet commun à une variable de contrôle. Cette restriction modifie l'objectif d'ajustement et la distribution de référence du test. Il faut la déclarer, et non la traiter comme une simplification sans conséquence.
Le calcul diffère aussi. Avec un changement pur, la somme des carrés résiduels (RSS) d'une partition est la somme des RSS de segments indépendants ; une récurrence de programmation dynamique peut donc optimiser la partition pour un nombre de ruptures fixé. Dans le modèle partiel, les coefficients communs relient tous les segments. Bai et Perron décrivent une procédure itérative qui estime les dates et les coefficients variables en tenant fixes les coefficients communs, puis met à jour ces derniers pour une partition donnée. La simple récurrence additive des RSS par segment ne résout pas à elle seule l'ensemble du problème contraint. La spécification doit répondre à la question scientifique ou prévisionnelle, et non être choisie parce qu'elle fait apparaître davantage de ruptures.
Fixer une longueur minimale de segment avant d'examiner les dates candidates
La recherche impose un nombre minimal d'observations dans chaque segment. Cette règle de trimming évite d'ajuster des intervalles extrêmement courts qui produiraient des coefficients instables, mais elle exclut aussi des changements réels trop proches d'une extrémité de l'échantillon ou d'une autre rupture. La règle fait partie du plan d'analyse ; ce n'est pas une loi universelle.
Considérons un exemple explicitement hypothétique avec \(T=240\) observations et une fraction de trimming choisie de 15 %. On obtient \(h=0{,}15\times240=36\) observations comme longueur minimale de chaque segment. Si la date de rupture désigne la dernière observation du segment précédent, les dates admissibles pour une rupture sont \(36\le T_1\le204\). Chaque côté contient alors au moins 36 observations.
Avec deux ruptures, les paires de dates admissibles doivent satisfaire les conditions suivantes :
\[ 36\le T_1,\qquad T_1+36\le T_2\le204. \]
Autrement dit, \(T_1\le168\), et \(T_2\) doit se situer au moins 36 observations après la première rupture et laisser 36 observations après la deuxième. La paire \((72,156)\) est admissible : ses trois segments contiennent 72, 84 et 84 observations. La paire \((80,100)\) ne l'est pas, car le segment central n'en contient que 20. Avec ce \(h\), cinq ruptures au maximum tiennent dans 240 observations : six segments exigent au moins \(6\times36=216\) observations, tandis que sept en exigent 252.
La valeur de 15 % est ici un choix de plan explicitement hypothétique, et non une recommandation par défaut. Une fraction plus élevée peut exclure des régimes de courte durée et des dates proches des bornes de l'échantillon ; une fraction plus faible admet de courts segments, mais peut laisser trop peu d'information pour estimer fiablement les pentes et les quantités de covariance de long terme. Choisissez la règle selon la fréquence d'échantillonnage, le nombre de variables explicatives, la durée plausible des régimes et la méthode d'inférence. Indiquez-la et, lorsque cela a un sens substantiel, montrez si les conclusions changent avec des valeurs proches. Les implémentations peuvent définir différemment la taille effective et les bornes en présence de retards ou de données manquantes ; documentez la convention réellement utilisée.
Utiliser la programmation dynamique pour trouver une segmentation globale à nombre fixé
Dans un modèle de changement pur avec \(m\) fixé, la recherche des dates peut s'écrire comme la minimisation de la RSS totale des segments :
\[ \min_{T_1,\ldots,T_m}\;\sum_{j=1}^{m+1}\operatorname{SSR}(T_{j-1}+1,T_j), \]
sous les contraintes d'ordre des dates et de longueur minimale des segments. \(\operatorname{SSR}(a,b)\) est la somme des carrés résiduels minimale des moindres carrés pour l'ajustement d'un segment sur les observations \(a,\ldots,b\). Une recherche naïve vérifie toutes les combinaisons de dates, dont le nombre augmente rapidement avec \(T\) et \(m\).
La programmation dynamique réutilise les sous-problèmes déjà optimisés. Si \(D(r,j)\) est la RSS minimale pour partitionner les observations 1 à \(j\) en \(r\) segments admissibles, une forme de la récurrence est
\[ D(r,j)=\min_i\{D(r-1,i)+\operatorname{SSR}(i+1,j)\}, \]
où la coupure \(i\) est contrainte de façon que les \(r-1\) premiers segments et le dernier respectent tous la longueur minimale. Conserver la coupure minimisante à chaque étape permet de retrouver les dates. Pour chaque nombre de segments autorisé, l'algorithme obtient une partition globalement minimale en RSS sous le modèle et les contraintes spécifiés, au lieu d'ajouter les ruptures une à une de manière gloutonne. Bai et Perron (2003) développent ce calcul et traitent les modèles de changements purs et partiels.
« Globale » signifie ici conditionnelle au nombre choisi, aux variables explicatives, aux termes déterministes, au trimming et à l'objectif. Cela ne signifie pas que le modèle statistique soit vrai, que ce nombre soit correct ou que la partition soit optimale parmi toutes les spécifications imaginables. La méthode peut comparer efficacement plusieurs nombres, mais le choix de \(m\) est une étape distincte d'inférence ou de sélection du modèle.
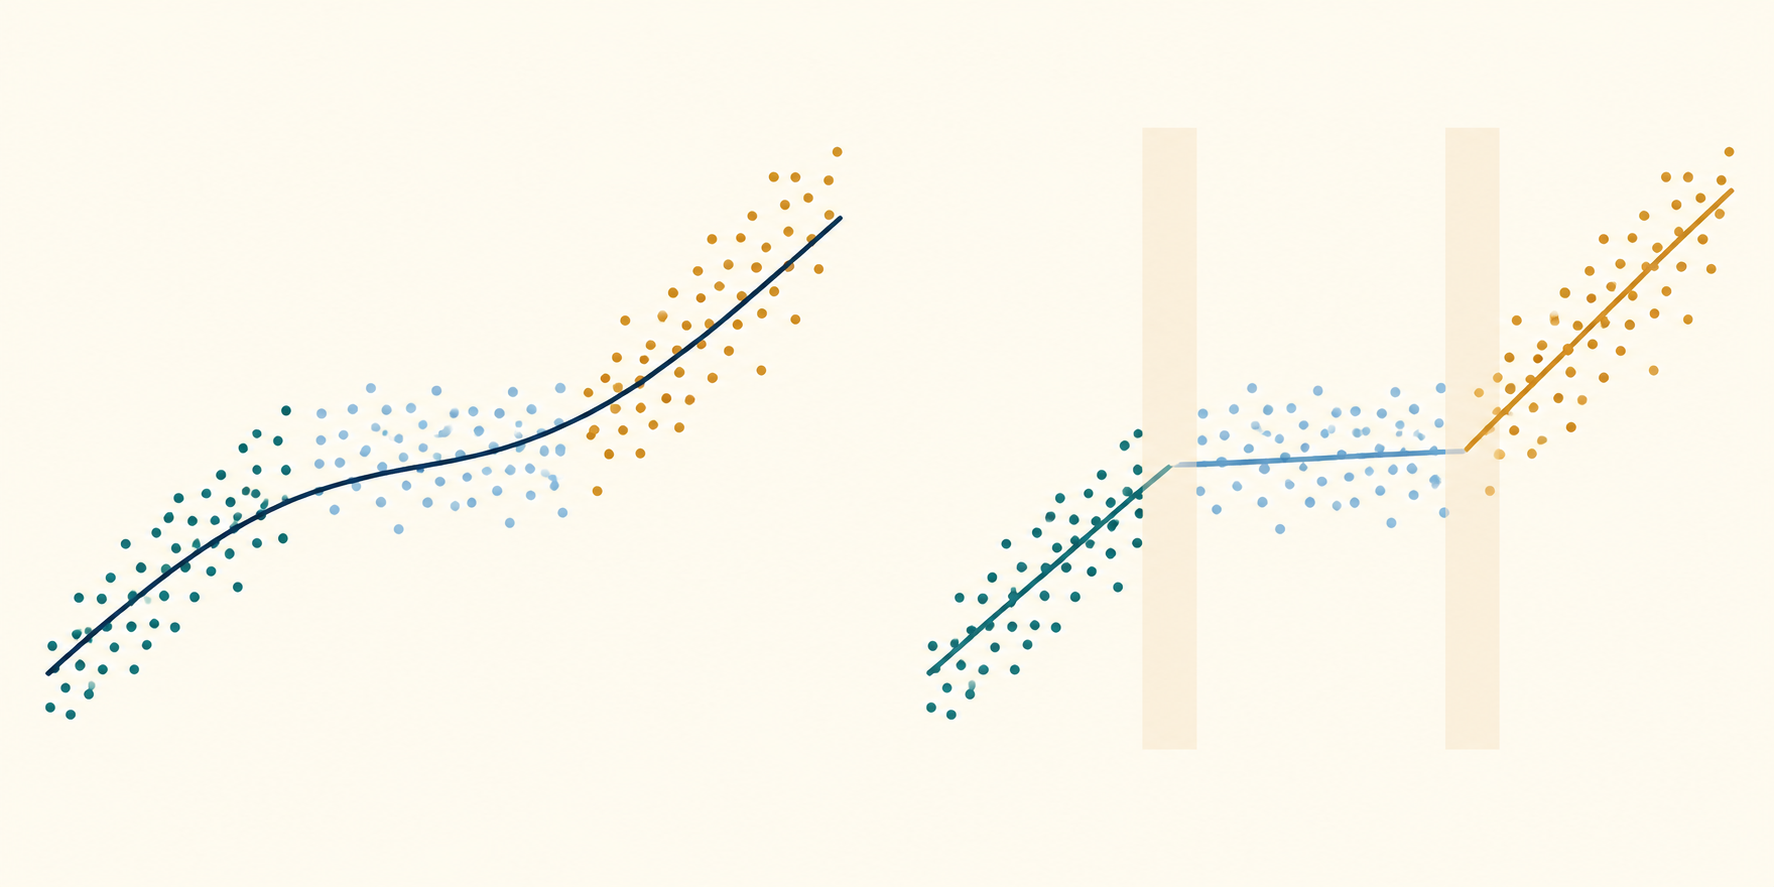
Choisir le nombre de ruptures avec une inférence ajustée à la recherche ou des critères
Une fois les meilleures partitions calculées pour plusieurs nombres candidats, différentes approches peuvent guider le choix de \(m\). Un test séquentiel \(\sup F(\ell+1\mid\ell)\) compare un modèle à \(\ell\) ruptures à un modèle qui en ajoute une, au moyen du supremum de la statistique sur les dates admissibles. Des tests à double maximum comme UDmax ou WDmax testent l'absence de rupture contre une alternative dont le nombre, inconnu, ne dépasse pas une limite fixée. Les critères d'information, notamment les versions de type BIC, mettent en balance amélioration de l'ajustement et pénalité de complexité. Ces méthodes répondent à des questions proches, mais différentes.
La valeur critique F ordinaire ne convient généralement pas après maximisation sur des dates inconnues. Sous l'hypothèse nulle sans rupture, les dates candidates ne sont pas identifiées de la même manière que sous l'alternative, ce qui produit des distributions asymptotiques non standard. Les valeurs critiques dépendent notamment du trimming, du changement pur ou partiel, des variables explicatives et des hypothèses sur la covariance des erreurs. Bai et Perron (1998) dérivent des tests de changements multiples ; leur étude ultérieure des valeurs critiques en fournit selon différentes règles de trimming et spécifications. Andrews (1993) établit des résultats importants pour les tests d'instabilité à point de changement unique inconnu, mais ses valeurs critiques ne remplacent pas une procédure à ruptures multiples.
Les tests séquentiels sont interprétables, mais leurs résultats peuvent dépendre de la puissance à chaque étape et du nombre maximal de ruptures fixé à l'avance. Les critères d'information peuvent retenir des nombres différents en raison de leurs pénalités distinctes ; tous les modèles candidats peuvent aussi n'être que des approximations. Davantage de ruptures ne signifie pas automatiquement une description plus réaliste : un faible gain d'ajustement peut s'accompagner de coefficients de segment instables. Indiquez la méthode, le maximum, le trimming, la séquence de tests ou le critère et les hypothèses des valeurs critiques correspondantes. Si le choix est important, montrez sa sensibilité au lieu de présenter un seul nombre comme certain.
Traiter les dates estimées comme des estimations conditionnelles incertaines
Les dates minimisant le critère sont des estimations ponctuelles sous un modèle donné. Ne les présentez pas comme si les données révélaient l'instant exact où une relation économique a changé. La variation d'échantillonnage, une faible variation des coefficients, des ruptures rapprochées, un résultat bruité, des variables explicatives peu variables ou une grande longueur minimale peuvent aplatir l'objectif autour de son minimum. Plusieurs partitions voisines peuvent alors s'ajuster presque aussi bien.
Bai et Perron élaborent des intervalles de confiance des dates de rupture sous des conditions précises. Ces intervalles décrivent l'incertitude d'échantillonnage des dates modélisées ; ils ne couvrent pas toutes les incertitudes sur la bonne spécification de la régression, les variables à inclure, le nombre de ruptures ou la règle de trimming. Si le nombre de ruptures est lui-même incertain, un intervalle étroit calculé conditionnellement à un seul nombre choisi peut sous-estimer l'incertitude globale.
Dans la pratique, distinguez la convention de date, l'indice d'observation estimé, la date calendaire correspondante et l'intervalle de chaque rupture. Si les intervalles sont larges ou se chevauchent, indiquez que la localisation est peu précise. Ne sélectionnez pas une date sur un graphique après avoir vu le résultat pour la présenter ensuite comme celle d'un événement prédit indépendamment. En comparant les ruptures à un événement connu, tenez compte du fait que l'événement et la fenêtre peuvent avoir été choisis après observation des données.
Adapter l'inférence à la dépendance sérielle et aux changements de variance
La partition par RSS est un critère d'ajustement ; la validité des tests et des intervalles de confiance dépend des hypothèses sur les variables explicatives et les erreurs. Les régressions financières peuvent présenter une autocorrélation, une hétéroscédasticité conditionnelle, des valeurs aberrantes, une volatilité changeante, des rendements qui se chevauchent ou des observations asynchrones. Si l'estimateur de covariance et les valeurs critiques supposent des erreurs indépendantes et de variance constante alors que les résidus sont dépendants ou hétéroscédastiques, la significativité rapportée peut être trompeuse même si les dates estimées semblent plausibles.
Les travaux de Bai–Perron développent des procédures sous des conditions plus générales, notamment certaines formes d'hétéroscédasticité et de dépendance sérielle. Il faut néanmoins utiliser la correction de covariance et les valeurs de référence adaptées au cas étudié. Une estimation robuste ou HAC de la covariance ne corrige ni une dynamique omise, ni un régresseur endogène, ni une moyenne conditionnelle mal spécifiée, ni un calendrier d'observations qui mélange des intervalles incompatibles. Elle ne transforme pas non plus, à elle seule, la fonction objectif RSS en un meilleur modèle des données.
Vérifiez la dépendance et les profils de variance des résidus dans chaque segment candidat et entre segments. Précisez si les hypothèses d'erreur autorisent des variances propres aux segments, une corrélation sérielle ou un changement de distribution des variables explicatives, et si la théorie du test retenu les couvre. Dans des segments très courts, l'estimation robuste de covariance est particulièrement fragile ; le trimming et la dimension du modèle doivent donc être conçus ensemble. Pour les bases des estimations de régression et des hypothèses de covariance, voir le guide de régression OLS.
Rapporter l'analyse sans en tirer une conclusion causale ou de trading
Un rapport reproductible précise la variable étudiée, tous les régresseurs, les transformations, la période et la fréquence de l'échantillon, l'ordonnée à l'origine et les restrictions de coefficients, le modèle de changement pur ou partiel, le maximum candidat \(m\), la fraction de trimming et la longueur minimale, la convention de date, l'algorithme d'optimisation et le test ou critère de sélection de \(m\). Il fournit le nombre retenu, les coefficients par segment, les dates et leurs intervalles d'incertitude, les statistiques de test, le traitement de la covariance et la source des valeurs critiques. Expliquez les bornes ou observations exclues de la recherche.
Une rupture détectée statistiquement est un indice d'instabilité des paramètres dans la régression spécifiée et sous ses hypothèses. Elle n'identifie pas l'événement qui a provoqué le changement, ne prouve pas qu'une annonce ou une politique particulière en soit responsable et ne montre pas que les coefficients avant ou après la rupture persisteront. Une rupture peut refléter une variable omise, une définition des données modifiée, un épisode de volatilité, un problème de mesure ou un véritable changement économique ; le test de régression ne départage pas ces explications.
En trading quantitatif, une recherche sur l'échantillon complet utilise des observations avant et après chaque rupture estimée. Trader comme si la date retenue avait été connue en temps réel introduit un biais d'anticipation. Évaluez chronologiquement toute règle de régime proposée et ne la réestimez qu'avec les informations disponibles à chaque date ; incluez spread, frais, impact de marché, financement, emprunt, rotation et latence. Comparez-la à des références simples à paramètres fixes et sans transaction, et réservez réellement des données ultérieures pour la validation. Une rupture peut motiver un examen du modèle ou du risque ; elle ne prouve ni pouvoir prédictif ni avantage négociable.
Bai et Perron (1998) présentent les tests et l'estimation de changements structurels multiples dans les modèles linéaires dans leur article original. Leur article de calcul de 2003 explique la programmation dynamique et les changements partiels ; leur article sur les valeurs critiques détaille leur dépendance au plan d'analyse. L'article d'Andrews sur les points de changement inconnus constitue un fondement connexe pour une rupture unique. Parmi les diagnostics voisins, comparez le test de Chow à date spécifiée au CUSUM de régression.
Questions fréquentes
Q1Bai–Perron me donne-t-il le vrai nombre de ruptures ?
Non. La méthode estime des partitions et fournit des tests ou critères pour choisir parmi plusieurs nombres candidats. Le résultat dépend de la spécification de régression, du trimming, des hypothèses d'erreur, du maximum retenu et de la règle de sélection ; il ne prouve pas que le processus générateur comportait exactement ce nombre de ruptures.
Q2La date estimée est-elle celle où un événement économique a causé le changement ?
Non. C'est une estimation, avec incertitude d'échantillonnage, de la localisation d'une instabilité des paramètres sous un modèle ajusté. Attribuer une cause exige des éléments supplémentaires et un plan d'analyse qui écarte les explications concurrentes.
Q3Puis-je trader directement à partir des dates de rupture estimées ?
Pas à partir d'une seule estimation rétrospective sur l'échantillon complet. La recherche utilise aussi des observations postérieures à une rupture candidate. Une règle en temps réel doit être évaluée chronologiquement, avec les informations alors disponibles, les coûts et des données ultérieures ; une rupture détectée ne prouve pas l'existence d'un signal rentable.
Sources et lectures complémentaires
Signaler un problème
Nous préparons un e-mail avec le lien de cet article. Mark ne reçoit le signalement qu’après son envoi
Vérification rapide
Guide terminé ? Vérifiez vos acquis avec 3 questions
Question 01
Dans un exemple de 240 observations, que signifie une règle de segment minimal de 15 % ?
Choisissez une réponse pour voir l'explication
Glossaire des options
A relationship describing how an outcome would differ under a specified intervention or counterfactual change; observed association alone does not identify it.
Lire le guide approfondiMulticollinearityStrong linear dependence among included regressors that makes their separate coefficients imprecise and sensitive to the sample.
Lire le guide approfondi