

回測過度擬合機率(PBO)與 CSCV 詳解
了解組合對稱交叉驗證如何估計 PBO、如何將樣本外排名轉換為 logit,以及為何它不是未來虧損的預測
本指南內容PBO 衡量選擇程序,而非單一策略
簡短摘要
回測過度擬合機率(PBO)衡量在樣本內(IS)被選為最佳的策略,在樣本外(OOS)排名低於候選組中位數的頻率。組合對稱交叉驗證(CSCV)反覆將等長時間區塊的一半用於選擇、另一半用於評估,藉此估計這個頻率。PBO 是基於特定搜尋、評分準則及歷史績效矩陣的條件診斷;它不是實際交易策略虧損的機率。
PBO 衡量選擇程序,而非單一策略
研究團隊可能嘗試不同的回看視窗、進場門檻、持倉期間、標的範圍、成本假設及投資組合限制,再保留回測分數最高的版本。獲選結果因此有很多機會貼合樣本的特性。PBO 概括這項搜尋的一個後果:在既定 IS/OOS 分割中,IS 勝出者有多常在 OOS 低於同一候選組的中位數?
Bailey、Borwein、López de Prado 和 Zhu 提出 PBO 架構以研究策略選擇風險,並提出 CSCV 作為其中一種估計方法。其定義關注如何從已測試的設定中選擇策略,而不只是某個預測方程是否有太多參數。每個分割中的 IS 是用於選擇候選的子集,不一定等同所有底層模型的估計期間。正式設定見PBO 原論文。
單一策略在全樣本中或許有很高的夏普比率,但仍可能只是弱研究候選組中最幸運的一個。相反,即使所有候選的報酬均為負,選擇程序仍可能經常選出 OOS 排名高於中位數的候選。PBO 比較提交候選組內的相對排名;它本身不會檢驗預期報酬是否為正。
PBO 回答的問題有別於其他驗證工具
按時間順序留出資料或進行 walk-forward 測試,是要觀察既定研究程序在較後期、未用於較早決策的資料上表現如何。Purged cross-validation 處理訓練標籤區間與測試結果重疊的問題;embargo 則可另加有獨立理據的緩衝期。但這些措施本身均不會衡量大型策略搜尋的勝出者有多常跌至 OOS 候選中位數以下。參閱[purged cross-validation 與 embargo 指南](/zh-TW/learn/purged-cross-validation-embargo-time-series-finance-explained)。
PBO 亦有別於多重檢定校正。White’s Reality Check 用 bootstrap 檢驗考慮資料窺探後,某候選組中的最佳規則有否勝過基準。Deflated Sharpe Ratio 會按選擇效應及非正態報酬調整以 Sharpe 為基礎的顯著性計算。PBO 則總結各分割中 IS 所選候選的 OOS 排名。這些方法的統計量及假設不同,不能自動互相取代。參閱White 有關 Reality Check 的原論文,以及 Bailey 和 López de Prado 關於Deflated Sharpe Ratio 的研究。
由完整且同步的績效矩陣開始
假設 M 是 T 行 N 列的矩陣。N 列各代表一個候選策略或設定,T 行則代表所有候選共用的觀察區間。一行可以是扣除相關交易成本後的每日報酬。若候選的交易頻率不同,先定義共同時間索引,再以一致方式彙總績效。逐行比較一個策略的每日報酬與另一策略的每月總額,並不能構成有意義的矩陣。
候選組應反映實際的選擇機會:網格搜尋中被淘汰的版本、看過結果後的人工修改、其他標的範圍,以及影響最終選擇的規則。PBO 只能評估提供的候選及其績效歷史。如果更大規模的搜尋後只記錄入圍版本,估算便會低估實際搜尋範圍。
所有候選都應使用相同的報酬口徑、幣別、槓桿處理方式及績效指標。若以淨 Sharpe 選擇,應先在每列計入相關費用、價差、融資、資金費、借貸成本及執行假設,再計算 Sharpe。該指標亦須能在之後的子樣本中計算。原論文要求各候選列資料同步,而且指標能在每個子樣本估計;交易頻率不同時,建議將序列對齊至共同索引。
CSCV 將每半個樣本與其補集配對
選擇偶數個 S 個互不重疊、大小相同的時間區塊,並保留每個區塊內的時間順序。對每種 S/2 區塊的選擇,將所選區塊組成樣本內(IS)集合,其餘 S/2 區塊則為樣本外(OOS)。若指標依賴路徑,須按原始順序排列所選區塊,並記錄串接區塊對指標的意義。
IS 分配數為 C(S,S/2)。若有 A、B、C、D 四個區塊,六種分配為 AB、AC、AD、BC、BD 和 CD;每種分配的補集亦會獨立計算。S = 16 時,C(16,8) = 12,870。這些是同一歷史資料的確定性組合,而非 12,870 次獨立市場實驗。
「對稱」指某個組合的補集會在另一組合中重新用作選擇集合:一次分割中 AB 為 IS、CD 為 OOS;另一次則相反。「組合」指列出所有一半區塊的選法,而非隨機抽取一次分割。此程序並非按時間重播。所選集合可能同時含有較早和較後的區塊,補集則含中間區塊。因此,這裏的 OOS 不等於「訓練期之後的未來」。
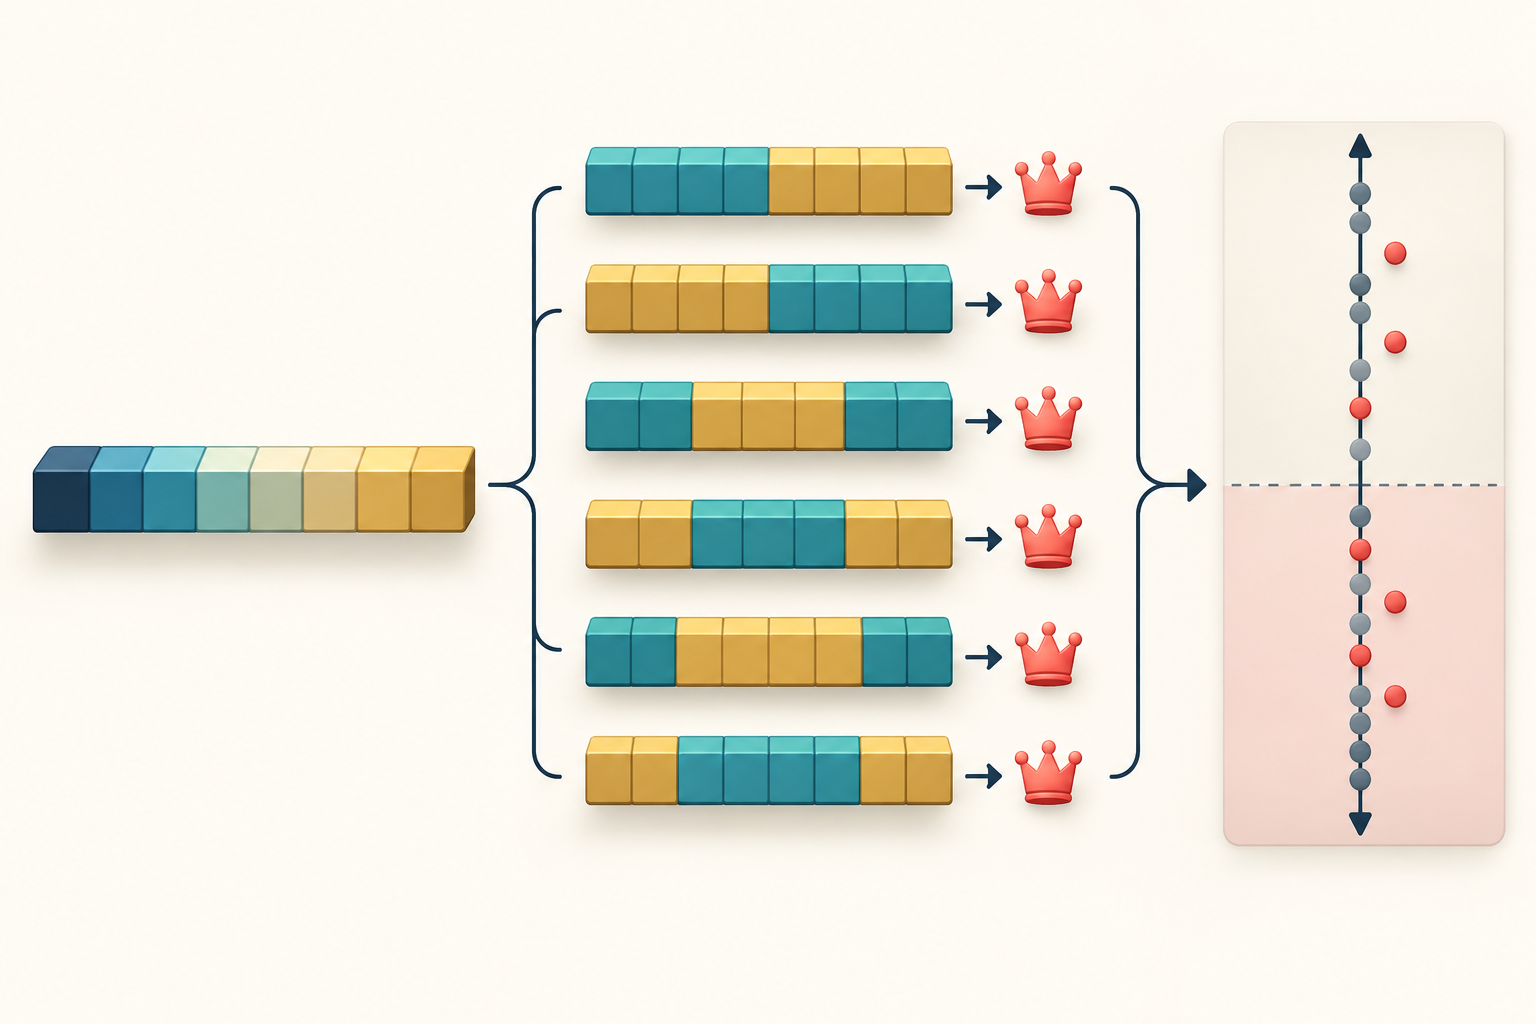
將所選候選的 OOS 排名轉換為 logit
在每個分割 c,將研究中的選擇規則套用至 IS 子集,選出最佳候選 n*(c)。接着,以相同績效指標評估補集 OOS 中全部 N 個候選。以 r(c) 表示所選候選的 OOS 排名:1 為最差,N 為最佳。應預先訂明如何處理同分,並在每個分割中保持一致。
將排名轉為相對排名 ω(c) = r(c)/(N+1)。分母 N+1 令最低及最高排名的數值仍嚴格介乎 0 和 1 之間。Logit 為 λ(c) = ln(ω(c)/(1−ω(c)))。所選候選低於 OOS 中位數時為負,在中位數為零,高於中位數時為正。估算 PBO 是所有 CSCV 分配中 λ(c) ≤ 0 的比例。
單一 PBO 數值概括 IS 勝出者達到或低於 OOS 中位數的頻率。完整 logit 分佈亦顯示所選候選通常是否接近中間、是否經常大幅下跌,或傾向排名較高。Logit 是相對排名的轉換值,並非個別實際交易的機率,亦非經校準的未來報酬預測。
四個區塊的假設例子得出 66.7% PBO
假設有四個大小相同的歷史區塊,以及 R1 至 R4 四條候選規則。下表列出六種 IS 分配。「OOS 排名」是 IS 所選規則在補集區塊上、四條規則中的名次。所有數值均屬假設,只為說明計算。
| IS 區塊 | IS 勝出者 | OOS 排名 r | 相對排名 ω = r/5 | Logit ln(ω/(1−ω)) | 等於或低於中位數? |
|---|---|---|---|---|---|
| AB | R1 | 1 | 0.20 | −1.386 | 是 |
| AC | R3 | 4 | 0.80 | +1.386 | 否 |
| AD | R2 | 2 | 0.40 | −0.405 | 是 |
| BC | R1 | 1 | 0.20 | −1.386 | 是 |
| BD | R4 | 3 | 0.60 | +0.405 | 否 |
| CD | R3 | 2 | 0.40 | −0.405 | 是 |
六條獲選規則中有四條的 OOS 相對排名不高於二分之一。因此,經驗 PBO 為 4/6 ≈ 0.667,即約 66.7%。例如排名 2 得到 ω = 2/(4+1) = 0.4,λ = ln(0.4/0.6) ≈ −0.405。排名 3 得到 ω = 0.6,logit 符號相反,約為 +0.405。
這不代表下個月有 66.7% 機會虧錢。它的意思是,在這個假設矩陣和排名規則下,IS 勝出者在六種分割中有四次處於 OOS 候選中位數或以下。其餘兩次勝出者的絕對 OOS 報酬亦可能為負,只是相對表現較佳。
將 PBO 視為有條件且有限制的診斷
PBO 取決於候選組、觀察到的績效矩陣、選擇指標、時間區塊及同分規則。未有記錄的實驗不在評估範圍內。「模型無關」是指毋須知道預測方程,亦可根據候選的績效歷史計算;並非代表不受設計選擇、資料品質或假設影響。
CSCV 將區塊組成對稱且大小相同的子集,但 OOS 通常不是一段連續的後續時間。重新拼接區塊可能破壞長期依賴、季節性或經濟狀態的先後次序。S 同時決定組合數及每個區塊代表的時間長度,應按策略相關期限及結構選擇並記錄。組合很多亦不會產生同等數量的獨立觀察,因為相同區塊會重複使用。
統計量會承接原始報酬中的偏差。倖存者偏差、修訂資料、當時未能取得的特徵、不真實成交、漏計成本或事後選定的標的範圍,都可能令所有候選歷史失真。CSCV 不會自動移除重疊標籤區間,不一定會在每次分割內重新估算整個模型流程,也不會防止前處理洩漏。應按研究問題明確實施這些步驟。時序防漏可參閱TimeSeriesSplit 官方文件及 purged 驗證指南。
最大回撤等依賴路徑的指標須格外小心:串接不相連區塊會改變路徑,亦可能改變指標。PBO 論文指出,有些指標與 Sharpe 不同,會受觀察次序影響。解讀排名前,應交代如何處理次序、間隔、缺失觀察及複利。
將 PBO 與時序證據及完整搜尋紀錄一併報告
計算前,保存候選登記、看過結果後作出的每項修改、績效矩陣、選擇指標及同分規則。報告 T、N、S、區塊構造、C(S,S/2)、OOS 排名規則、估算 PBO 及 logit 分佈。另列絕對 OOS 績效、成本、換手率、回撤及虧損候選數目;排名本身無法顯示所有候選是否都表現欠佳。
使用 walk-forward 或真正按時間順序留出的 holdout,在較後期資料上評估已凍結的研究程序。選擇模型和門檻時,不要查看最後一段期間;反覆檢視會令它成為另一個選擇集。像 TimeSeriesSplit 這類按時間排序的工具,會根據文件所述假設建立時序折分;PBO 則衡量候選組另一種排名特性。
因此,PBO 可補充標籤重疊控制、多重檢定分析、實際執行模型、前瞻評估及實盤監察,但不能取代它們。另可閱讀[金融中的多重檢定與錯誤發現率](/zh-TW/learn/multiple-testing-false-discovery-rate-finance-explained)及[序列相關下的 Sharpe 比率調整](/zh-TW/learn/sharpe-ratio-serial-correlation-annualization-explained)。任何單一統計量都不能把歷史排名轉化成持續交易優勢的證明。
常見問題
Q1PBO 是否代表策略有這個機率虧損?
不是。它估算在指定分割中,IS 所選候選於 OOS 排名等於或低於中位數的頻率。這不是未來虧損機率,亦不是經校準的實盤報酬預測。
Q2CSCV 是否等同 walk-forward 測試?
不是。CSCV 將每半區塊與其補集配對,因此 OOS 可以同時包含較早及較後的區塊。Walk-forward 則將訓練期保留在每個較後測試期之前,以檢視接近部署情境的時序路徑。
Q3PBO 偏低是否證明所選策略有優勢?
不是。勝出者可以勝過一組較弱的候選,但絕對報酬仍可能為負。應分開評估淨報酬、不確定性、成本、資訊洩漏及真正較後期資料上的表現。
資料來源與延伸閱讀
回報問題
我們會準備一封包含本文連結的電子郵件。寄出後,Mark 才會收到你的回報
快速檢查
讀完指南後,用 3 道題檢查一下
問題 01
哪種情況會計入 PBO 估算?
選擇答案即可查看解釋