

อธิบายความน่าจะเป็นของการโอเวอร์ฟิตแบ็กเทสต์ (PBO) และ CSCV
เรียนรู้ว่า combinatorially symmetric cross-validation ประมาณค่า PBO อย่างไร แปลงอันดับ OOS เป็น logit อย่างไร และเหตุใดจึงไม่ใช่การพยากรณ์การขาดทุนในอนาคต
ในคู่มือนี้PBO วัดกระบวนการเลือก ไม่ใช่กลยุทธ์เดี่ยว
สรุปสั้น
ความน่าจะเป็นของการโอเวอร์ฟิตแบ็กเทสต์ (PBO) ถามว่ากลยุทธ์ที่เลือกว่าดีที่สุดในชุดข้อมูลภายใน (IS) อยู่ต่ำกว่าค่ามัธยฐานของชุดผู้สมัครในชุดข้อมูลภายนอก (OOS) บ่อยแค่ไหน Combinatorially symmetric cross-validation (CSCV) ประมาณความถี่นี้ด้วยการแบ่งบล็อกเวลาที่มีขนาดเท่ากันครึ่งหนึ่งสำหรับการเลือกและอีกครึ่งหนึ่งสำหรับการประเมิน PBO เป็นค่าตรวจวินิจฉัยที่ขึ้นกับการค้นหา คะแนน และเมทริกซ์ผลการดำเนินงานในอดีตที่กำหนด ไม่ใช่ความน่าจะเป็นที่กลยุทธ์ซึ่งใช้งานจริงจะขาดทุน
PBO วัดกระบวนการเลือก ไม่ใช่กลยุทธ์เดี่ยว
ทีมวิจัยอาจลองช่วง lookback เกณฑ์เข้า ระยะเวลาถือครอง universe สมมติฐานต้นทุน และข้อจำกัดพอร์ตหลายแบบ แล้วเก็บรูปแบบที่ได้คะแนนแบ็กเทสต์สูงสุด ผลที่เลือกจึงมีโอกาสหลายครั้งในการปรับเข้ากับลักษณะเฉพาะของชุดข้อมูล PBO สรุปผลอย่างหนึ่งของการค้นหานี้: ในการแบ่ง IS/OOS ที่กำหนด ผู้ชนะ IS อยู่ต่ำกว่าค่ามัธยฐาน OOS ของผู้สมัครชุดเดิมบ่อยเพียงใด
Bailey, Borwein, López de Prado และ Zhu เสนอ PBO เพื่อใช้ประเมินความเสี่ยงจากการเลือกกลยุทธ์ และเสนอ CSCV เป็นวิธีประมาณค่าแบบหนึ่ง นิยามนี้เกี่ยวกับขั้นตอนการเลือกจาก configuration ที่ทดสอบ ไม่ใช่เพียงว่ามี parameter มากเกินไปในสมการพยากรณ์หนึ่งหรือไม่ ในแต่ละการแบ่ง IS คือ subset ที่ใช้เลือกผู้สมัคร และไม่จำเป็นต้องตรงกับช่วงที่ใช้ประมาณโมเดลพื้นฐานทุกตัว อ่านนิยามอย่างเป็นทางการได้ในบทความ PBO ฉบับต้นฉบับ
กลยุทธ์หนึ่งอาจมี Sharpe ratio สูงเมื่อดูข้อมูลทั้งหมด แต่ยังเป็นเพียงผู้สมัครที่โชคดีที่สุดในกลุ่มวิจัยที่อ่อนแอได้ ในทางกลับกัน กระบวนการเลือกอาจเลือกผู้สมัครที่มีอันดับสูงกว่าค่ามัธยฐาน OOS บ่อย แม้ว่าผลตอบแทนของผู้สมัครทุกตัวจะติดลบ PBO เปรียบเทียบอันดับสัมพัทธ์ภายในกลุ่มที่ส่งให้เท่านั้น ไม่ได้ทดสอบผลตอบแทนคาดหวังที่เป็นบวกด้วยตัวมันเอง
PBO ตอบคำถามต่างจากเครื่องมือตรวจสอบอื่น
Chronological holdout หรือ walk-forward test ถามว่ากระบวนการวิจัยที่กำหนดไว้ทำงานอย่างไรกับข้อมูลช่วงหลังซึ่งไม่ได้ใช้ตัดสินใจก่อนหน้า Purged cross-validation จัดการการทับซ้อนระหว่างช่วง label สำหรับฝึกกับผลลัพธ์ทดสอบ ส่วน embargo อาจเพิ่มช่วงกันชนที่มีเหตุผลรองรับแยกต่างหาก แต่มาตรการเหล่านี้เพียงอย่างเดียวไม่ได้วัดว่าผู้ชนะจากการค้นหากลยุทธ์วงกว้างตกต่ำกว่าค่ามัธยฐานของผู้สมัครใน OOS บ่อยแค่ไหน ดูคู่มือ purged cross-validation และ embargo
PBO ยังต่างจากการปรับแก้ multiple testing ด้วย White’s Reality Check ใช้ bootstrap ทดสอบว่ากฎที่ดีที่สุดในกลุ่มชนะ benchmark หรือไม่หลังคำนึงถึง data snooping ส่วน Deflated Sharpe Ratio ปรับการคำนวณนัยสำคัญที่อิง Sharpe ให้คำนึงถึงผลจากการเลือกและผลตอบแทนที่ไม่เป็นปกติ ขณะที่ PBO สรุปอันดับ OOS ของผู้สมัครที่เลือกใน IS ในแต่ละการแบ่ง ทั้งสามวิธีใช้สถิติและสมมติฐานต่างกัน จึงใช้แทนกันโดยอัตโนมัติไม่ได้ อ่านบทความ Reality Check ต้นฉบับของ White และงานของ Bailey กับ López de Prado เรื่อง Deflated Sharpe Ratio
เริ่มจากเมทริกซ์ผลการดำเนินงานที่ครบถ้วนและซิงโครไนซ์กัน
ให้ M เป็นเมทริกซ์ T คูณ N แต่ละคอลัมน์จาก N คอลัมน์แทนกลยุทธ์หรือ configuration ผู้สมัครหนึ่งรายการ และแต่ละแถวจาก T แถวแทนช่วงสังเกตเดียวกันสำหรับผู้สมัครทั้งหมด หนึ่งแถวอาจเป็นผลตอบแทนรายวันหลังหักต้นทุนซื้อขายที่เกี่ยวข้อง หากความถี่การซื้อขายต่างกัน ให้กำหนดดัชนีเวลาร่วมก่อนและรวมผลการดำเนินงานอย่างสม่ำเสมอ การเทียบผลตอบแทนรายวันของกลยุทธ์หนึ่งกับยอดรวมรายเดือนของอีกกลยุทธ์แบบแถวต่อแถวไม่ให้เมทริกซ์ที่มีความหมาย
ชุดผู้สมัครควรสะท้อนโอกาสเลือกจริง: variant ที่ตัดออกจาก grid search การแก้ด้วยมือหลังเห็นผล universe ทางเลือก และกฎที่มีผลต่อการเลือกสุดท้าย PBO ประเมินได้เฉพาะผู้สมัครและประวัติผลการดำเนินงานที่ให้ไว้ หากบันทึกแค่ตัวเลือกสุดท้ายหลังจากค้นหามากกว่านั้นมาก ค่าประมาณจะทำให้ขอบเขตการค้นหาจริงดูแคบเกินไป
ใช้ convention ของผลตอบแทน สกุลเงิน วิธีจัดการ leverage และเกณฑ์วัดผลเดียวกันทุก candidate หากเลือกด้วย Sharpe สุทธิ ให้ใส่ค่าธรรมเนียม spread ต้นทุนเงินทุน funding ค่า borrow และสมมติฐาน execution ที่เกี่ยวข้องในแต่ละคอลัมน์ก่อนคำนวณ metric นั้นต้องคำนวณได้ใน subset ที่ใช้ต่อไปด้วย บทความต้นฉบับกำหนดให้แถวซิงโครไนซ์และ metric ประมาณค่าได้ในแต่ละ subsample หากความถี่ซื้อขายต่างกัน แนะนำให้จัด series ให้อยู่บนดัชนีร่วม
CSCV จับคู่แต่ละครึ่งของข้อมูลกับส่วนเติมเต็ม
เลือกจำนวนคู่ S ของบล็อกเวลาที่ไม่ทับซ้อนและมีขนาดเท่ากัน โดยคงลำดับเวลาในแต่ละบล็อก สำหรับทุกวิธีเลือก S/2 บล็อก ให้นำมารวมเป็นชุด in-sample (IS) และใช้ S/2 บล็อกที่เหลือเป็น out-of-sample (OOS) หาก metric ขึ้นกับเส้นทาง ให้คงลำดับเดิมของบล็อกที่เลือกและบันทึกว่าการนำมาต่อกันมีความหมายอย่างไรต่อ metric
จำนวนการจัดสรร IS คือ C(S,S/2) เมื่อมีสี่บล็อก A, B, C และ D จะมีหกการจัดสรร ได้แก่ AB, AC, AD, BC, BD และ CD โดยส่วนเติมเต็มของแต่ละชุดนับเป็นอีกการจัดสรรหนึ่ง หาก S = 16 จะได้ C(16,8) = 12,870 นี่คือชุดผสมแบบกำหนดแน่นอนจากประวัติเดียวกัน ไม่ใช่การทดลองตลาดอิสระ 12,870 ครั้ง
“สมมาตร” หมายถึงนำส่วนเติมเต็มกลับมาใช้เป็นชุดสำหรับเลือกในอีกชุดผสมหนึ่ง เช่น รอบหนึ่ง AB เป็น IS และ CD เป็น OOS แต่อีกรอบสลับกัน “เชิงจัดหมู่” หมายถึงไล่เลือกครึ่งหนึ่งของบล็อกทุกแบบ แทนการสุ่มแบ่งเพียงครั้งเดียว วิธีนี้ไม่ใช่การจำลองตามลำดับเวลา ชุดที่เลือกอาจมีทั้งบล็อกช่วงต้นและปลาย ขณะที่ส่วนเติมเต็มมีบล็อกช่วงกลาง ดังนั้น OOS ที่นี่ไม่ได้หมายถึง “อนาคตหลังช่วงฝึก”
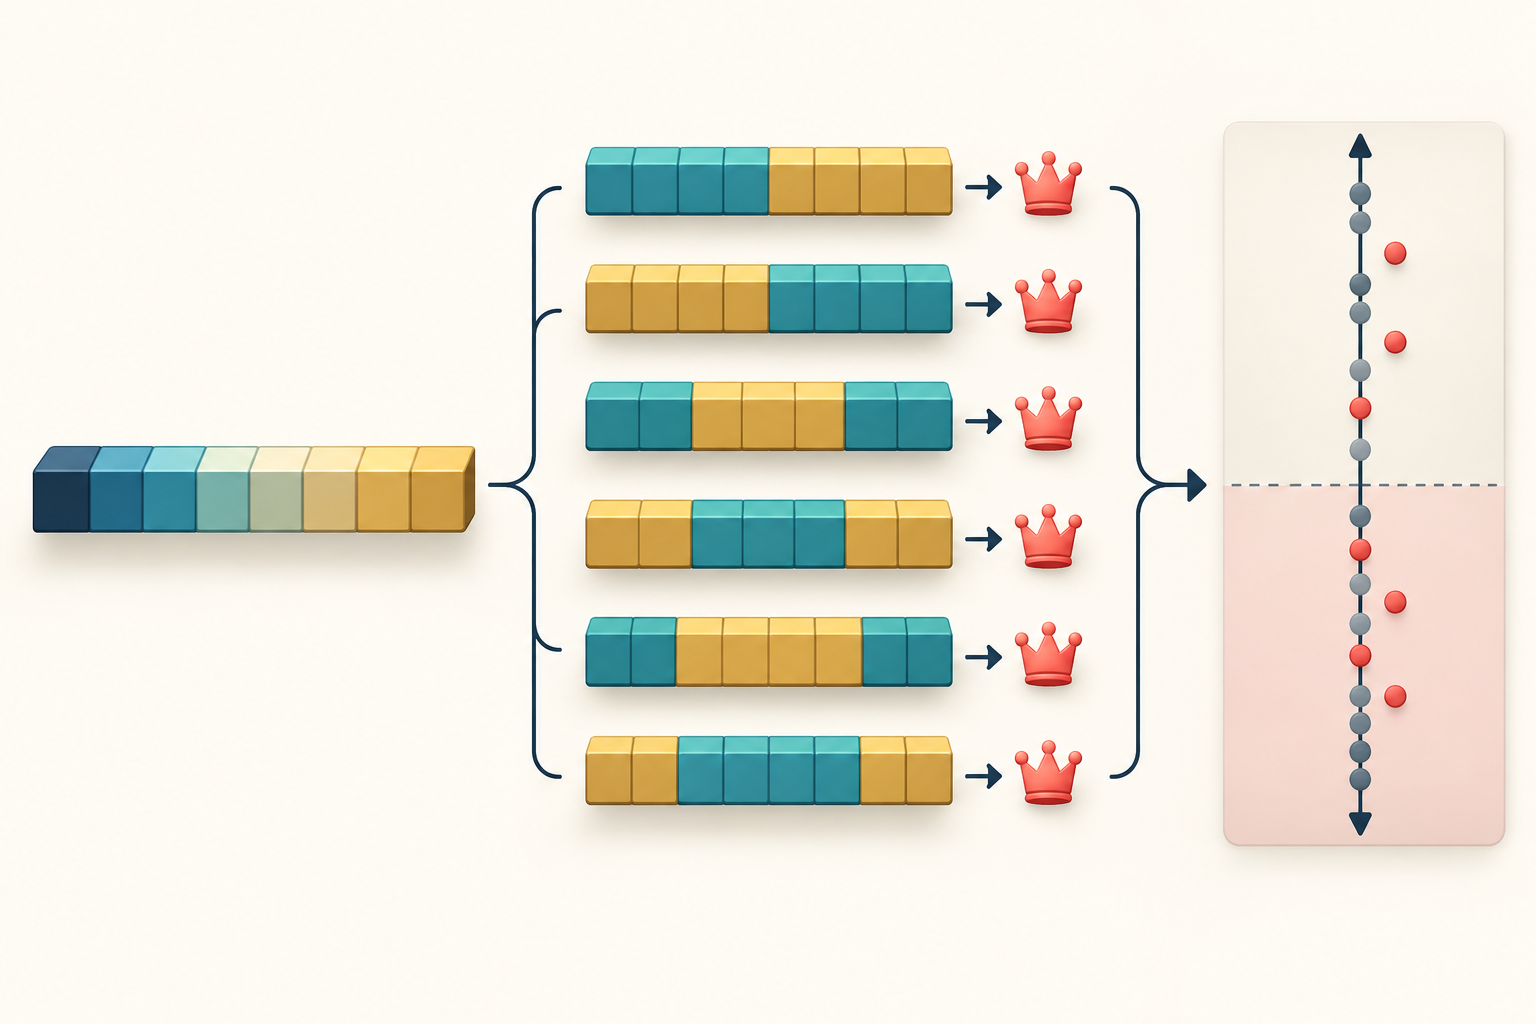
แปลงอันดับ OOS ของผู้สมัครที่เลือกเป็น logit
สำหรับการแบ่ง c ให้ใช้กฎเลือกของงานวิจัยกับ subset IS แล้วเลือกผู้สมัครที่ดีที่สุด n*(c) จากนั้นให้คะแนนผู้สมัครทั้ง N รายบน OOS ซึ่งเป็นส่วนเติมเต็มด้วย metric เดียวกัน กำหนด r(c) เป็นอันดับ OOS ของผู้สมัครที่เลือก โดย 1 คือแย่ที่สุดและ N คือดีที่สุด ระบุวิธีจัดการคะแนนเสมอกันล่วงหน้าและใช้เหมือนกันทุกการแบ่ง
แปลงอันดับเป็นอันดับสัมพัทธ์ ω(c) = r(c)/(N+1) ตัวหาร N+1 ทำให้ค่าต่ำกว่า 1 และสูงกว่า 0 อย่างเคร่งครัด แม้เป็นอันดับต่ำสุดหรือสูงสุด logit คือ λ(c) = ln(ω(c)/(1−ω(c))) ค่านี้ติดลบเมื่อผู้สมัครที่เลือกอยู่อันดับต่ำกว่าค่ามัธยฐาน OOS เป็นศูนย์ที่มัธยฐาน และเป็นบวกเมื่อสูงกว่า PBO ที่ประมาณได้คือสัดส่วนของการจัดสรร CSCV ทั้งหมดที่มี λ(c) ≤ 0
ค่า PBO เพียงค่าเดียวบอกว่าผู้ชนะ IS อยู่ไม่เกินค่ามัธยฐาน OOS บ่อยเพียงใด การดูการกระจาย logit ทั้งหมดช่วยให้เห็นว่าผู้สมัครที่เลือกมักอยู่ใกล้ตรงกลาง ตกลงไปมากบ่อยครั้ง หรือมักอยู่อันดับเหนือกว่า logit เป็นการแปลงอันดับสัมพัทธ์ ไม่ใช่ความน่าจะเป็นของธุรกรรมจริงรายการหนึ่งหรือการพยากรณ์ผลตอบแทนอนาคตที่สอบเทียบแล้ว
ตัวอย่างสมมติสี่บล็อกให้ค่า PBO 66.7%
สมมติว่ามีบล็อกอดีตขนาดเท่ากันสี่บล็อกและกฎผู้สมัคร R1 ถึง R4 ตารางแสดงการจัดสรร IS ทั้งหกแบบ คอลัมน์ OOS rank คืออันดับของกฎที่เลือกใน IS เมื่อเทียบกับกฎทั้งสี่บนบล็อกส่วนเติมเต็ม ค่าทั้งหมดเป็นค่าจำลองเพื่ออธิบายการคำนวณเท่านั้น
| บล็อก IS | ผู้ชนะ IS | อันดับ OOS r | อันดับสัมพัทธ์ ω = r/5 | Logit ln(ω/(1−ω)) | อยู่ที่หรือต่ำกว่ามัธยฐานหรือไม่ |
|---|---|---|---|---|---|
| AB | R1 | 1 | 0.20 | −1.386 | ใช่ |
| AC | R3 | 4 | 0.80 | +1.386 | ไม่ |
| AD | R2 | 2 | 0.40 | −0.405 | ใช่ |
| BC | R1 | 1 | 0.20 | −1.386 | ใช่ |
| BD | R4 | 3 | 0.60 | +0.405 | ไม่ |
| CD | R3 | 2 | 0.40 | −0.405 | ใช่ |
กฎที่ถูกเลือกสี่รายการจากหกรายการมีอันดับสัมพัทธ์ OOS ไม่เกินหนึ่งในสอง ดังนั้น PBO เชิงประจักษ์เท่ากับ 4/6 ≈ 0.667 หรือประมาณ 66.7% ตัวอย่างเช่น อันดับ 2 ให้ ω = 2/(4+1) = 0.4 และ λ = ln(0.4/0.6) ≈ −0.405 ส่วนอันดับ 3 ให้ ω = 0.6 และ logit เครื่องหมายตรงข้ามประมาณ +0.405
นี่ไม่ได้หมายความว่ามีโอกาส 66.7% ที่จะเสียเงินในเดือนหน้า แต่หมายความว่าในเมทริกซ์สมมตินี้และตามกติกาอันดับนี้ ผู้ชนะ IS อยู่ที่หรือต่ำกว่ามัธยฐานของผู้สมัคร OOS ในสี่จากหกการแบ่ง ผู้ชนะอีกสองครั้งก็อาจมีผลตอบแทน OOS สัมบูรณ์ติดลบ แม้จะทำได้ดีกว่าคู่แข่ง
มอง PBO เป็นการวินิจฉัยแบบมีเงื่อนไขและมีข้อจำกัด
PBO ขึ้นกับกลุ่มผู้สมัคร เมทริกซ์ผลการดำเนินงานที่สังเกต metric ที่ใช้เลือก บล็อกเวลา และกติกาคะแนนเสมอ การทดลองที่ไม่ได้บันทึกอยู่นอกขอบเขต “ไม่ขึ้นกับโมเดล” หมายความว่าคำนวณจากประวัติผลของผู้สมัครได้โดยไม่ต้องรู้สมการพยากรณ์ ไม่ได้หมายความว่าปราศจากการตัดสินใจด้านการออกแบบ คุณภาพข้อมูล หรือสมมติฐาน
CSCV ผสมบล็อกเป็น subset สมมาตรขนาดเท่ากัน แต่ OOS มักไม่ใช่ช่วงเวลาต่อเนื่องช่วงเดียวที่อยู่ภายหลัง การนำบล็อกมาต่อใหม่อาจรบกวน dependence ระยะยาว ฤดูกาล หรือลำดับ regime เศรษฐกิจ S กำหนดทั้งจำนวนชุดผสมและช่วงเวลาที่แต่ละบล็อกแทนอยู่ เลือกและบันทึกโดยคำนึงถึง horizon และโครงสร้างที่เกี่ยวข้องของกลยุทธ์ จำนวนชุดผสมมากไม่ได้สร้าง observation อิสระจำนวนเท่ากัน เพราะบล็อกเดิมถูกนำกลับมาใช้
สถิติยังรับช่วง bias จากผลตอบแทนต้นทาง เช่น survivorship bias ข้อมูลที่แก้ไขย้อนหลัง feature ที่ไม่มีในเวลานั้น fill ที่ไม่สมจริง ต้นทุนที่ตกหล่น หรือ universe ที่เลือกหลังเห็นผล CSCV ไม่ได้ purge ช่วง label ที่ทับซ้อนโดยอัตโนมัติ ไม่ได้ fit pipeline โมเดลใหม่ทุกส่วนในทุก split เสมอไป และไม่ป้องกันข้อมูลรั่วจาก preprocessing ต้องจัดการขั้นตอนเหล่านี้ให้ชัดตามโจทย์วิจัย สำหรับการป้องกันตามลำดับเวลา ดูเอกสารทางการของ TimeSeriesSplit และคู่มือ purged validation
Metric ที่ขึ้นกับเส้นทาง เช่น maximum drawdown ต้องระวังเป็นพิเศษ: การต่อบล็อกที่ไม่ติดกันเปลี่ยนเส้นทางและอาจเปลี่ยน metric ได้ บทความ PBO ระบุว่าลำดับ observation สำคัญสำหรับ metric บางชนิด แม้ไม่สำคัญกับ Sharpe อธิบายวิธีจัดการลำดับ ช่องว่าง observation ที่หายไป และการทบต้นก่อนตีความอันดับ
รายงาน PBO ควบคู่หลักฐานตามเวลาและบันทึกการค้นหาครบถ้วน
ก่อนคำนวณ ให้เก็บทะเบียนผู้สมัคร การปรับทุกครั้งหลังเห็นผล เมทริกซ์ผลการดำเนินงาน metric การเลือก และกติกาคะแนนเสมอ รายงาน T, N, S วิธีสร้างบล็อก C(S,S/2) convention ของอันดับ OOS ค่า PBO โดยประมาณ และการกระจาย logit เพิ่มผล OOS สัมบูรณ์ ต้นทุน turnover drawdown และจำนวนผู้สมัครที่ขาดทุน เพราะอันดับอย่างเดียวไม่บอกว่าทุกตัวอ่อนแอหรือไม่
ใช้ walk-forward หรือ chronological holdout จริงเพื่อประเมินกระบวนการวิจัยที่ตรึงไว้กับข้อมูลที่มาทีหลัง อย่าเปิดดูช่วงสุดท้ายระหว่างเลือกโมเดลและ threshold เพราะการตรวจซ้ำทำให้ช่วงนั้นกลายเป็นชุดเลือกอีกชุดหนึ่ง เครื่องมือตามลำดับเวลา เช่น TimeSeriesSplit สร้าง fold ตามลำดับเวลาภายใต้สมมติฐานที่ระบุไว้ ส่วน PBO วัดคุณสมบัติด้านอันดับอีกแบบหนึ่งของกลุ่มผู้สมัครที่ค้นหา
ดังนั้น PBO ช่วยเสริม แต่ใช้แทนการควบคุม label overlap การวิเคราะห์ multiple testing การจำลอง execution ที่สมจริง การประเมินล่วงหน้า และการติดตาม live ไม่ได้ อ่านต่อเรื่อง multiple testing และอัตราการค้นพบเท็จในตลาดการเงิน และการปรับ Sharpe ratio เมื่อมี serial correlation ไม่มีสถิติเดียวที่เปลี่ยนอันดับในอดีตให้เป็นหลักฐานของความได้เปรียบในการเทรดที่ยั่งยืน
คำถามที่พบบ่อย
Q1PBO หมายความว่ากลยุทธ์มีโอกาสขาดทุนเท่านั้นหรือไม่?
ไม่ใช่ PBO ประมาณว่าผู้สมัครที่เลือกใน IS ได้อันดับที่มัธยฐาน OOS หรือต่ำกว่าบ่อยแค่ไหนใน split ที่กำหนด ไม่ใช่โอกาสขาดทุนในอนาคตหรือการพยากรณ์ผลตอบแทน live ที่สอบเทียบแล้ว
Q2CSCV เหมือนกับการทดสอบ walk-forward หรือไม่?
ไม่ใช่ CSCV จับคู่ครึ่งหนึ่งของบล็อกที่เลือกกับส่วนเติมเต็ม ดังนั้น OOS จึงมีบล็อกทั้งช่วงก่อนหน้าและหลังหน้าได้ ส่วน walk-forward วางช่วงฝึกไว้ก่อนช่วงทดสอบที่มาทีหลังแต่ละช่วงเพื่อศึกษาลำดับเวลาที่คล้ายการนำไปใช้งาน
Q3PBO ต่ำพิสูจน์หรือไม่ว่ากลยุทธ์ที่เลือกมี edge?
ไม่ ผู้ชนะอาจชนะกลุ่มที่อ่อนแอ แต่ยังขาดทุนในเชิงสัมบูรณ์ได้ ให้ประเมินผลตอบแทนสุทธิ ความไม่แน่นอน ต้นทุน ข้อมูลรั่ว และผลบนข้อมูลที่ใหม่กว่าจริงแยกกัน
แหล่งข้อมูลและการอ่านเพิ่มเติม
รายงานปัญหา
เราจะเตรียมอีเมลพร้อมลิงก์บทความนี้ Mark จะได้รับรายงานเมื่อคุณส่งอีเมลแล้วเท่านั้น
ตรวจสอบอย่างรวดเร็ว
อ่านคู่มือจบแล้ว ลองตอบคำถาม 3 ข้อ
คำถาม 01
เหตุการณ์ใดมีส่วนในการประมาณ PBO?
เลือกคำตอบเพื่อดูคำอธิบาย