

การทดสอบ Diebold–Mariano: วิธีเปรียบเทียบความแม่นยำของพยากรณ์
เรียนรู้ว่าการทดสอบ Diebold–Mariano เปรียบเทียบค่าความสูญเสียของพยากรณ์แบบจับคู่และจัดการกับช่วงพยากรณ์ที่ซ้อนทับกันอย่างไร รวมถึงเหตุใดค่า p ที่ต่ำจึงไม่ได้พิสูจน์ทักษะการเทรด
ในคู่มือนี้ความคลาดเคลื่อนจากการทดสอบย้อนหลังที่ต่ำกว่ายังไม่ใช่หลักฐานว่าพยากรณ์ดีกว่า
สรุปสั้น
การทดสอบ Diebold–Mariano เปรียบเทียบพยากรณ์สองแบบด้วยผลต่างของค่าความสูญเสียที่คำนวณจากผลลัพธ์จริงชุดเดียวกัน ผลการทดสอบขึ้นอยู่กับฟังก์ชันความสูญเสีย ตัวอย่างที่นำมาประเมิน ระยะพยากรณ์ และวิธีประมาณความไม่แน่นอน ความคลาดเคลื่อนในตัวอย่างที่ต่ำกว่าไม่ได้แปลโดยอัตโนมัติว่าความแม่นยำที่คาดหวังดีกว่า และความแม่นยำของพยากรณ์ที่สูงกว่าก็ไม่เท่ากับกลยุทธ์การเทรดที่ทำกำไร
ความคลาดเคลื่อนจากการทดสอบย้อนหลังที่ต่ำกว่ายังไม่ใช่หลักฐานว่าพยากรณ์ดีกว่า
สมมติว่าแบบจำลองสองแบบพยากรณ์ผลตอบแทน ความผันผวน หรือตัวแปรทางเศรษฐกิจเดียวกันในวันเดียวกัน แบบจำลอง A มีค่าความคลาดเคลื่อนเฉลี่ยต่ำกว่า B ในตัวอย่างที่ประเมิน ข้อมูลนี้อธิบายสิ่งที่พบในตัวอย่าง แต่ยังไม่ได้บอกว่า A แม่นยำกว่าอย่างสม่ำเสมอหรือไม่ หรือช่องว่างดังกล่าวอาจเกิดจากความแปรปรวนทั่วไปของวันที่บังเอิญถูกนำมาทดสอบ
การทดสอบ Diebold–Mariano (DM) เปลี่ยนการเปรียบเทียบนี้ให้เป็นอนุกรมเวลาที่จับคู่กัน ณ จุดเริ่มต้นการพยากรณ์แต่ละจุด จะนำพยากรณ์ทั้งสองไปเทียบกับค่าจริงเดียวกัน ให้คะแนนด้วยฟังก์ชันความสูญเสียที่กำหนดไว้ล่วงหน้า แล้วตรวจสอบลำดับของผลต่างค่าความสูญเสีย การจับคู่มีความสำคัญ: ในวันที่ตลาดผันผวน ค่าความสูญเสียของทั้งสองแบบจำลองอาจสูงขึ้นพร้อมกัน แต่การเปรียบเทียบถามว่าในวันเดียวกันนั้นแบบจำลองใดมีแนวโน้มสูญเสียน้อยกว่า
กรอบวิธีดั้งเดิมไม่ได้จำกัดอยู่แค่ความคลาดเคลื่อนกำลังสองหรือความคลาดเคลื่อนของพยากรณ์ที่แจกแจงแบบปกติ สามารถเปรียบเทียบฟังก์ชันความสูญเสียหลายแบบ รวมถึงแบบไม่สมมาตรได้ หากคะแนนนั้นสอดคล้องกับคำถามการพยากรณ์ อย่างไรก็ตาม ยังต้องออกแบบการประเมินให้มีเหตุผลและประมาณความไม่แน่นอนของผลต่างค่าความสูญเสียเฉลี่ย Diebold และ Mariano (1995) เสนอการทดสอบสมมติฐานว่าความแม่นยำในการพยากรณ์เท่ากัน ส่วน Harvey, Leybourne และ Newbold (1997)00719-4) ศึกษาการปรับแก้สำหรับตัวอย่างขนาดเล็ก
จัดพยากรณ์ให้เปรียบเทียบกันได้ก่อนคำนวณค่าสถิติ
แต่ละแถวควรแทนจุดเริ่มต้นการพยากรณ์ที่เทียบกันได้ แบบจำลองทั้งคู่ต้องพยากรณ์เป้าหมายเดียวกันในระยะเดียวกัน โดยใช้ข้อมูลที่มีอยู่ ณ จุดเริ่มต้นนั้น จัดแนวค่าจริง เวลา สกุลเงินหรือหน่วย ชุดข้อมูลตามรุ่น และกติกาการจัดการข้อมูลที่หายให้ตรงกันก่อนเปรียบเทียบค่าความสูญเสีย หากแบบจำลองหนึ่งพยากรณ์ราคาปิดวันถัดไป แต่อีกแบบจำลองพยากรณ์ค่าเฉลี่ยห้าวัน ความคลาดเคลื่อนของทั้งสองตอบคำถามคนละข้อ
ใช้พยากรณ์ที่สร้างขึ้นโดยไม่มองข้อมูลอนาคต การกันข้อมูลตามลำดับเวลาไว้ทดสอบหรือการประเมินนอกตัวอย่างจำลองแบบเลื่อนหน้าต่างอาจช่วยได้ แต่การแบ่งข้อมูลอย่างเดียวไม่เพียงพอ หากมีการใช้ชุดทดสอบเดิมซ้ำ ๆ เพื่อปรับคุณลักษณะ เกณฑ์ตัดสินใจ หรือตัวแปรของแบบจำลอง ควรเก็บพยากรณ์ที่สร้างในแต่ละจุดย้อนหลังไว้ รวมถึงข้อมูลและรุ่นของแบบจำลองที่ใช้ มิฉะนั้นข้อมูลเศรษฐกิจมหภาคที่มีการแก้ไข ตัวกรองอคติจากการรอดอยู่ หรือการปรับข้อมูลกิจกรรมของบริษัทที่ทราบภายหลัง อาจทำให้ผลประเมินเปลี่ยนย้อนหลังได้
ประเมินทั้งสองแบบจำลองบนชุดจุดเริ่มต้นพยากรณ์เดียวกัน การตัดวันที่ยากออกจากแบบจำลองเดียวทำลายการเปรียบเทียบแบบจับคู่ หากพยากรณ์หายไป ให้ใช้ตัวอย่างร่วมกันหรืออธิบายเหตุผลของวิธีจัดการค่าที่หาย อย่าปล่อยให้แบบจำลองเผชิญภาวะตลาดคนละช่วงโดยไม่แจ้ง กำหนดวันเริ่มต้นและสิ้นสุดก่อนตรวจดูว่าตัวอย่างช่วงใดให้ผลที่ต้องการ
ฟังก์ชันความสูญเสียเป็นตัวกำหนดว่า “แม่นยำกว่า” หมายถึงอะไร
ให้ค่าจริง ณ จุด t เป็น yₜ และพยากรณ์จากแบบจำลอง A และ B เป็น ŷA,ₜ และ ŷB,ₜ ตามลำดับ ความคลาดเคลื่อนคือ eA,ₜ = yₜ − ŷA,ₜ และ eB,ₜ = yₜ − ŷB,ₜ ฟังก์ชันความสูญเสีย L แปลงความคลาดเคลื่อนแต่ละค่าเป็นคะแนน โดยคะแนนต่ำกว่าถือว่าดีกว่า ความสูญเสียกำลังสอง L(e) = e² ลงโทษความคลาดเคลื่อนขนาดใหญ่มากกว่า ส่วนความสูญเสียสัมบูรณ์ L(e) = |e| เพิ่มขึ้นตามขนาดความคลาดเคลื่อนแบบเส้นตรง พยากรณ์ควอนไทล์อาจใช้ความสูญเสียแบบ pinball ที่ไม่สมมาตร เพราะต้นทุนของการพยากรณ์สูงหรือต่ำเกินไปไม่เท่ากัน
คะแนนที่เลือกอาจเปลี่ยนว่าแบบจำลองใดดูดีกว่า ลองพิจารณาคู่ความคลาดเคลื่อนสมมติสองช่วงที่วัดในหน่วยเดียวกัน: A มีความคลาดเคลื่อน 0 และ 2 ส่วน B มี 1 และ 1 ภายใต้ความสูญเสียกำลังสอง ค่าความสูญเสียเฉลี่ยเป็น 2 และ 1 ดังนั้น B ได้คะแนนดีกว่า ภายใต้ความสูญเสียสัมบูรณ์ ทั้งคู่มีค่าเฉลี่ยเท่ากับ 1 ไม่มีการคำนวณใดถูกต้องที่สุดสำหรับทุกกรณี แต่ละแบบตอบคำถามต่างกันว่าเราสนใจความคลาดเคลื่อนชนิดใด
ความคลาดเคลื่อนกำลังสองอาจมีประโยชน์กับพยากรณ์ค่าเฉลี่ยแบบมีเงื่อนไขของผลตอบแทน ส่วนพยากรณ์ความผันผวนควรใช้คะแนนที่ออกแบบสำหรับเป้าหมายนั้น และพยากรณ์ Value-at-Risk ควรใช้คะแนนควอนไทล์หรือการทดสอบย้อนหลังด้านความเสี่ยงโดยเฉพาะ การเลือกฟังก์ชันความสูญเสียหลังเห็นว่าแบบจำลองใดชนะ ทำให้การทดสอบกลายเป็นการค้นหาอีกขั้นหนึ่ง จึงควรกำหนดฟังก์ชันและทิศทางของ “ดีกว่า” ก่อนดูผลเปรียบเทียบ
พยากรณ์ VaR มุ่งประเมินควอนไทล์หางของการแจกแจง ไม่ใช่พยากรณ์ค่าจุดทั่วไป คู่มือการทดสอบย้อนหลัง VaR อธิบายวิธีตรวจสอบความถี่และลำดับของเหตุการณ์ที่เกินเกณฑ์สำหรับพยากรณ์ความเสี่ยงประเภทนั้น
สร้างผลต่างค่าความสูญเสียแบบจับคู่และระบุสมมติฐานศูนย์
หากค่าความสูญเสียที่ต่ำกว่าถือว่าดีกว่า กำหนดผลต่างในช่วง t ดังนี้
dₜ = L(eA,ₜ) − L(eB,ₜ)
ตามข้อตกลงเรื่องเครื่องหมายนี้ dₜ ที่เป็นบวกหมายถึง A มีค่าความสูญเสียสูงกว่า จึงเป็นประโยชน์ต่อ B ในจุดนั้น ส่วนค่าลบเป็นประโยชน์ต่อ A ค่าเฉลี่ยตัวอย่างคือ d̄ = (1/n) Σ dₜ สมมติฐานศูนย์ของความแม่นยำแบบไม่มีเงื่อนไขที่เท่ากันคือ E[dₜ] = 0 สมมติฐานทางเลือกแบบสองด้านถามว่าค่าความสูญเสียที่คาดหวังแตกต่างกันหรือไม่ในทิศทางใดทิศทางหนึ่ง สมมติฐานทางเลือกด้านเดียวที่กำหนดไว้ล่วงหน้าอาจถามว่าแบบจำลองที่ระบุมีค่าความสูญเสียที่คาดหวังต่ำกว่าหรือไม่
ค่าสถิติพื้นฐานคือ
DM = d̄ / √(Ŝd / n)
ในที่นี้ Ŝd ประมาณความแปรปรวนระยะยาวของอนุกรมผลต่างค่าความสูญเสีย ไม่ใช่เพียงความแปรปรวนของความคลาดเคลื่อนพยากรณ์ของแต่ละแบบจำลอง ภายใต้สมมติฐานศูนย์และเงื่อนไขความสม่ำเสมอที่เหมาะสม ค่าสถิติมีการแจกแจงแบบปกติมาตรฐานเมื่อขนาดตัวอย่างเข้าใกล้อนันต์ ค่าบวกขนาดใหญ่เป็นประโยชน์ต่อ B ตามข้อตกลงเครื่องหมายข้างต้น ส่วนค่าลบขนาดใหญ่เป็นประโยชน์ต่อ A ค่า p วัดว่าข้อมูลสอดคล้องกับสมมติฐานศูนย์และสมมติฐานการสุ่มตัวอย่างที่กำหนดเพียงใด ไม่ใช่ความน่าจะเป็นที่แบบจำลองใดแบบจำลองหนึ่งเป็นจริง
การจับคู่ช่วยตัดความแตกต่างที่ไม่เกี่ยวข้องของระดับความคลาดเคลื่อนโดยรวมของแบบจำลองได้เท่าที่ผลต่างรายจุดสะท้อน แต่ไม่ได้ทำให้อนุกรมค่าความสูญเสียเป็นอิสระ ไม่ได้รวมความไม่แน่นอนจากการประมาณพารามิเตอร์โดยอัตโนมัติ และไม่ได้แก้ปัญหาการค้นหาจากเป้าหมายหรือข้อกำหนดหลายแบบ ประเด็นเหล่านี้ต้องจัดการในแบบวิจัยและการประมาณความไม่แน่นอน
ตัวอย่างพยากรณ์หนึ่งขั้นแยกช่องว่างในตัวอย่างออกจากหลักฐาน
สมมติว่ามีพยากรณ์หนึ่งขั้นแบบจับคู่ที่เป็นข้อมูลสมมติ 100 คู่ ค่าความสูญเสียกำลังสองเฉลี่ยของ A เท่ากับ 0.26 และของ B เท่ากับ 0.23 โดยใช้หน่วยเป็นกำลังสองของจุดเปอร์เซ็นต์ ดังนั้นผลต่างเฉลี่ยคือ d̄ = 0.26 − 0.23 = 0.03 ซึ่งเป็นประโยชน์ต่อ B ค่า RMSE ที่สอดคล้องกันอยู่ที่ประมาณ 0.510 และ 0.480 จุดเปอร์เซ็นต์ ซึ่งเป็นช่องว่างเชิงพรรณนาประมาณ 0.030 อย่างไรก็ตาม สถิติ DM ใช้ผลต่างของความสูญเสียกำลังสองที่จับคู่กัน ไม่ได้ทดสอบผลต่างระหว่างรากที่สองทั้งสองค่า สำหรับตัวอย่างเพื่อการสอนที่คำนวณง่ายนี้ สมมติว่าความแปรปรวนระยะยาวของ dₜ ที่ประมาณได้เท่ากับ 0.04 และไม่มีสหสัมพันธ์ข้ามช่วงเวลา
ค่าคลาดเคลื่อนมาตรฐานของผลต่างเฉลี่ยที่ประมาณได้คือ √(0.04 / 100) = 0.02 ค่าสถิติก่อนปรับแก้คือ 0.03 / 0.02 = 1.50 สำหรับระยะพยากรณ์ h = 1 และ T = 100 ตัวคูณปรับแก้ตัวอย่างขนาดเล็กของ Harvey–Leybourne–Newbold คือ √[(T + 1 − 2h + h(h − 1)/T) / T] = √0.99 ≈ 0.995 เมื่อนำมาคูณแล้ว ค่าสถิติที่ปรับแก้จะอยู่ใกล้ 1.49 ส่วนค่า p แบบสองด้านโดยใช้อ้างอิงการแจกแจง t₉₉ โดยประมาณอยู่ที่ 0.14
B มีค่าความคลาดเคลื่อนกำลังสองเฉลี่ยที่สังเกตได้ต่ำกว่า แต่ตัวอย่างนี้ไม่ได้ให้หลักฐานหนักแน่นพอที่จะปฏิเสธสมมติฐานว่าความแม่นยำที่คาดหวังเท่ากัน ณ ระดับนัยสำคัญตามปกติ การไม่ปฏิเสธไม่ได้พิสูจน์ว่าแบบจำลองทั้งสองแม่นยำเท่ากัน และแม้ปฏิเสธได้ ข้อสรุปก็ยังขึ้นอยู่กับคะแนน จุดประเมิน และสมมติฐานที่เลือก ค่าความแปรปรวนและค่าความสูญเสียทั้งหมดเป็นข้อมูลสมมติสำหรับสอนวิธีคำนวณ ไม่ใช่ผลเชิงประจักษ์
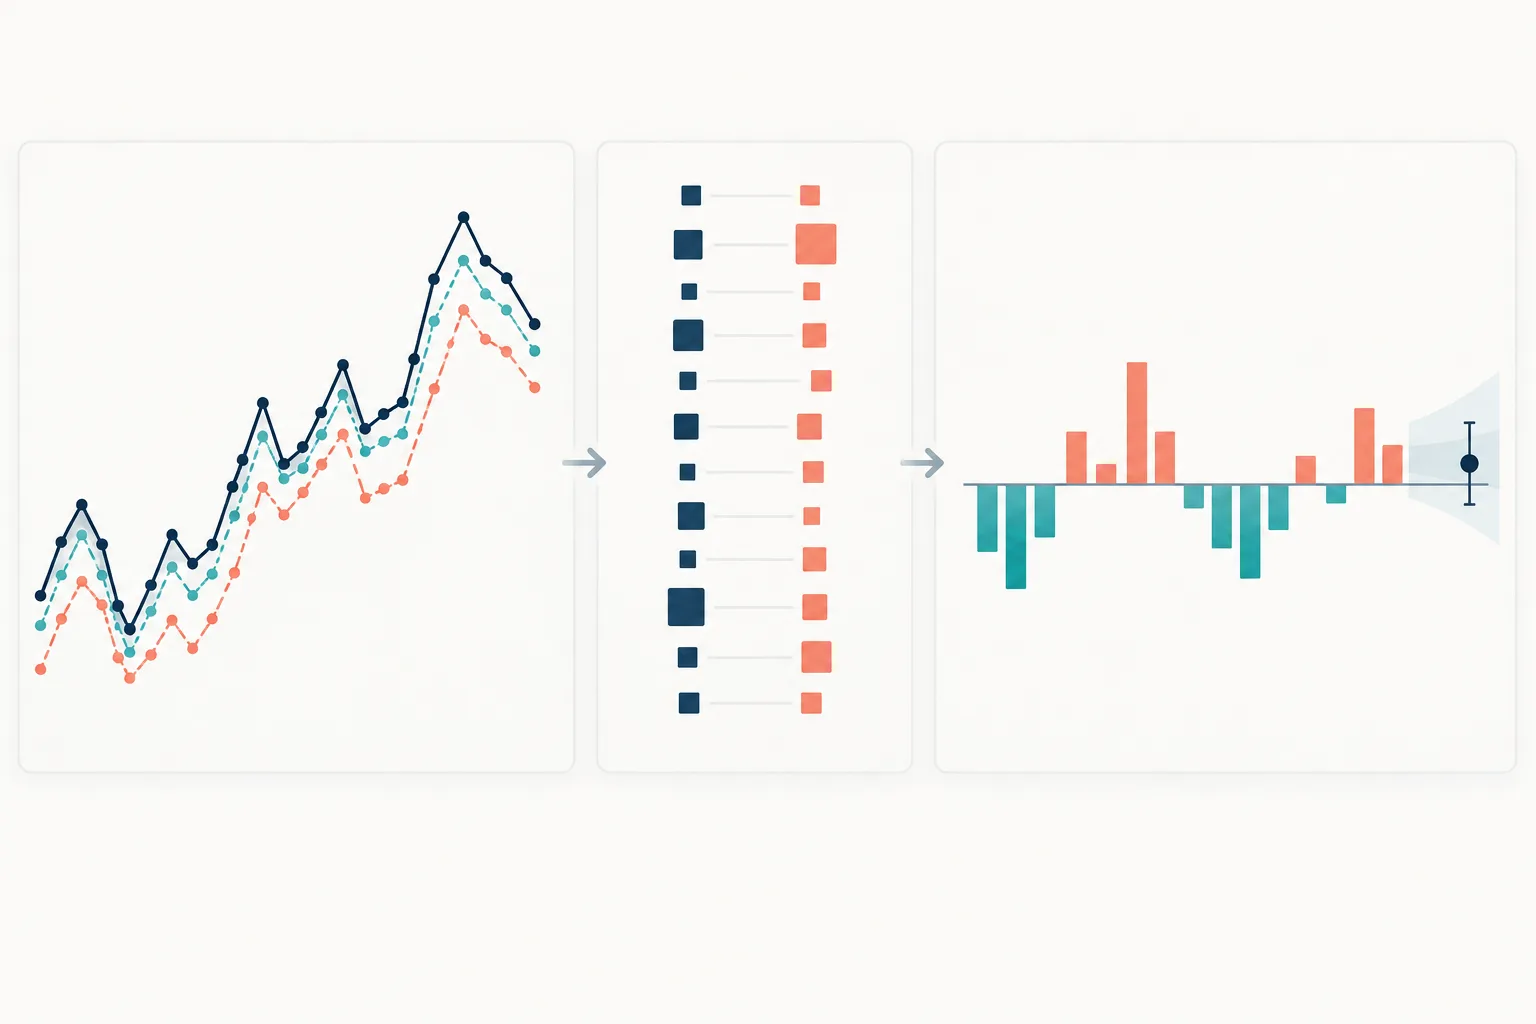
ช่วงพยากรณ์ที่ซ้อนทับกันทำให้ผลต่างค่าความสูญเสียขึ้นต่อกัน
หากออกพยากรณ์ล่วงหน้าห้าวันทุกวัน พยากรณ์ที่อยู่ติดกันจะใช้วันเป้าหมายร่วมกันสี่วันจากทั้งหมดห้าวัน ความคลาดเคลื่อน ค่าความสูญเสีย และผลต่างค่าความสูญเสียจึงอาจเคลื่อนไหวไปด้วยกัน การนับจุดพยากรณ์รายวัน 100 จุดเป็นการเปรียบเทียบอิสระ 100 ครั้ง อาจประเมินความไม่แน่นอนต่ำเกินไปและทำให้ค่าสถิติดูสูงเกินจริง
ความแปรปรวนระยะยาวคำนึงถึงสหสัมพันธ์ข้ามช่วงเวลาใน dₜ ตัวประมาณที่ทนต่อความแปรปรวนไม่คงที่และสหสัมพันธ์ต่อเนื่อง (HAC) ซึ่งใช้กันทั่วไปมีรูปแบบดังนี้
Ŝd = γ̂₀ + 2 Σₖ₌₁ᵐ wₖ γ̂ₖ
โดย γ̂ₖ คือค่าความแปรปรวนร่วมตัวอย่างของ d ระหว่างช่วงเวลาที่ห่างกัน k ระยะ, wₖ คือน้ำหนักเคอร์เนล และ m คือแบนด์วิดท์ที่เลือก Newey และ West (1987) เสนอตัวประมาณเมทริกซ์ความแปรปรวนร่วมแบบ HAC ที่มีสมบัติกึ่งบวกแน่นอน ภายใต้สมมติฐานที่เกี่ยวข้อง ความคลาดเคลื่อนจากพยากรณ์ h ขั้นที่เหมาะสมอาจมีการพึ่งพากันอย่างน้อย h − 1 ระยะหน่วงจากการซ้อนทับ และกรอบ DM ดั้งเดิมกล่าวถึงตัวประมาณแบบตัดทอนสำหรับกรณีนั้น ข้อมูลจริงอาจมีการพึ่งพากันยาวนานกว่านี้จากเป้าหมายที่คงอยู่ การประมาณแบบเลื่อนหน้าต่าง หรือการสร้างกลยุทธ์ ดังนั้น h − 1 จึงไม่ใช่กฎเลือกแบนด์วิดท์ที่ใช้ได้ทุกกรณี
ระบุระยะพยากรณ์ เคอร์เนล แบนด์วิดท์ และการปรับแก้ตัวอย่างขนาดเล็ก แสดงด้วยว่าข้อสรุปเปลี่ยนไปหรือไม่ภายใต้การกำหนดค่าการพึ่งพากันที่สมเหตุสมผล แทนการเลือกแบนด์วิดท์เพียงเพราะได้ค่า p ที่ต้องการ หากเว้นระยะจุดเริ่มต้นการพยากรณ์เพื่อหลีกเลี่ยงการซ้อนทับ ให้ระบุเรื่องนี้และอธิบายว่าต้องแลกกับข้อมูลหรือขนาดตัวอย่างส่วนใด การประมาณความไม่แน่นอนที่คำนึงถึงการพึ่งพากันเป็นส่วนหนึ่งของการทดสอบ ไม่ใช่ตัวเลือกสำหรับการแสดงผล
แบบจำลองซ้อนกันและความแม่นยำที่เปลี่ยนไปต้องใช้คำถามคนละแบบ
การเปรียบเทียบ DM แบบทั่วไปตีความได้ง่ายที่สุดกับพยากรณ์ที่ไม่ได้ซ้อนกันภายใต้สมมติฐานศูนย์ว่าความแม่นยำเท่ากัน หากแบบจำลองขนาดใหญ่มีแบบจำลองฐานขนาดเล็กเป็นส่วนหนึ่ง ค่าสัมประสิทธิ์ที่ประมาณเพิ่มอาจทำให้พยากรณ์มีสัญญาณรบกวน แม้ค่าจริงของสัมประสิทธิ์เหล่านั้นเป็นศูนย์ ภายใต้สมมติฐานศูนย์เช่นนี้ ผลต่างของค่าความคลาดเคลื่อนกำลังสองเฉลี่ยแบบปกติอาจมีการแจกแจงที่ไม่เป็นมาตรฐาน สำหรับการเปรียบเทียบ MSPE นอกตัวอย่างของแบบจำลองซ้อนกัน อาจใช้วิธีอย่างการปรับแก้ Clark–West เพื่อคำนึงถึงผลจากสัญญาณรบกวนในการประมาณ แต่วิธีนี้ไม่ได้ใช้แทน DM ได้ทั่วไปในทุกโครงสร้างแบบจำลอง ดู Clark และ West (2007)
สมมติฐานศูนย์ DM ทั่วไปพิจารณาค่าความสูญเสียเฉลี่ยแบบไม่มีเงื่อนไขตลอดตัวอย่างประเมิน ซึ่งอาจซ่อนการเปลี่ยนแปลงตามเวลา: A อาจทำได้ดีกว่าในช่วงตลาดสงบ ส่วน B ดีกว่าในช่วงผันผวน แม้ค่าเฉลี่ยโดยรวมใกล้กัน หากต้องการทราบว่าความแม่นยำสัมพัทธ์ขึ้นอยู่กับข้อมูลที่ทราบ ณ วันพยากรณ์หรือไม่ การทดสอบความสามารถในการพยากรณ์แบบมีเงื่อนไขจะใช้ผลต่างค่าความสูญเสียร่วมกับตัวแปรเครื่องมือที่กำหนดไว้ล่วงหน้า Giacomini และ White (2006) พัฒนากรอบดังกล่าว สมมติฐานและการออกแบบหน้าต่างประเมินยังคงสำคัญ การเพิ่มตัวแปรบ่งชี้ตามใจหลังเห็นผลไม่ใช่ทางลัดที่ถูกต้อง
เลือกการทดสอบให้ตรงกับโครงสร้างการเปรียบเทียบ: พยากรณ์ที่เป็นอิสระ แบบจำลองซ้อนกัน ความแม่นยำแบบมีเงื่อนไขที่เปลี่ยนไป หรือกลุ่มแบบจำลองที่เลือกจากหลายตัวเลือก เป็นกรณีที่ใช้แทนกันไม่ได้ สำหรับกรณีสุดท้าย คู่มือ White’s Reality Check และ Hansen’s SPA อธิบายการปรับแก้ทั้งกลุ่มหลังจากค้นหากฎการเทรดจำนวนมาก
ค่าความสูญเสียจากพยากรณ์ที่ต่ำกว่าไม่ได้ยืนยันว่ากลยุทธ์ทำกำไร
พยากรณ์ที่แม่นยำกว่าในเชิงสถิติอาจไม่ช่วยให้ผลการเทรดสุทธิดีขึ้น กลยุทธ์ต้องแปลงพยากรณ์เป็นสถานะลงทุน กำหนดเวลาซื้อขาย และรับภาระส่วนต่างราคา ค่าคอมมิชชัน การคลาดเคลื่อนของราคา ผลกระทบต่อตลาด ต้นทุนเงินทุน ต้นทุนการยืม และข้อจำกัดความเสี่ยง การปรับปรุงเล็กน้อยของค่าความคลาดเคลื่อนกำลังสองเฉลี่ยของผลตอบแทนอาจไม่เปลี่ยนการตัดสินใจ ในขณะที่แบบจำลองที่มีค่าความคลาดเคลื่อนเฉลี่ยสูงกว่าเล็กน้อยอาจจับเหตุการณ์หางที่สำคัญต่อกฎเฉพาะได้ดีกว่า
ให้การประเมินพยากรณ์และการประเมินพอร์ตโฟลิโอเป็นคนละขั้นตอน ก่อนอื่นทดสอบพยากรณ์กับเป้าหมายและค่าความสูญเสียที่ตรงกับงานพยากรณ์ จากนั้นจึงประเมินกฎการเทรดที่กำหนดครบถ้วนบนข้อมูลที่ไม่ได้ใช้เลือกพยากรณ์ โดยใช้สมมติฐานการส่งคำสั่งและการเงินที่สมจริง ค่า p จากการทดสอบพยากรณ์ไม่ใช่ผลตอบแทนจากการทดสอบย้อนหลัง ค่า Sharpe หรือความน่าจะเป็นที่จะทำกำไรในอนาคต
การลองแบบจำลอง เป้าหมาย ระยะพยากรณ์ ฟังก์ชันความสูญเสีย และช่วงตัวอย่างซ้ำ ๆ ทำให้เกิดอคติจากการคัดเลือก แม้การคำนวณ DM แต่ละครั้งจะถูกต้องก็ตาม บันทึกการค้นหาทั้งหมดและใช้วิธีปรับแก้ทั้งตระกูลการทดสอบ เมื่อคำถามคือมีตัวเลือกใดเหลือรอดจากการค้นหาหรือไม่ คู่มือ block bootstrap อธิบายการประมาณความไม่แน่นอนของสถิติที่เลือกไว้ล่วงหน้าโดยรักษาการพึ่งพาตามเวลาไว้ แต่ไม่ได้แก้การค้นหาแบบจำลองที่ไม่ได้บันทึกไว้
รายงานรายละเอียดให้ผู้อื่นทำซ้ำการเปรียบเทียบได้
ระบุชื่อแบบจำลองพยากรณ์ทั้งสอง ความสัมพันธ์กับแบบจำลองฐาน เป้าหมาย ระยะพยากรณ์ ตารางจุดเริ่มต้นการพยากรณ์ วันที่ประเมิน ชุดข้อมูลที่ใช้ได้ในขณะนั้น รุ่นข้อมูล และกติกาการเลือกตัวอย่างร่วม กำหนดฟังก์ชันความสูญเสียด้วยสมการและระบุว่า dₜ เป็นบวกแล้วเป็นประโยชน์ต่อ A หรือ B รายงาน n ค่าความสูญเสียเฉลี่ยของแต่ละแบบจำลอง d̄ ตัวประมาณความแปรปรวนระยะยาว เคอร์เนลและแบนด์วิดท์ HAC การปรับแก้ตัวอย่างขนาดเล็ก การแจกแจงอ้างอิง ทิศทางของการทดสอบ และค่า p
ระบุเพิ่มเติมว่าแบบจำลองซ้อนกันหรือไม่ ประมาณพารามิเตอร์อย่างไร เลือกการเปรียบเทียบก่อนหรือหลังดูผล และลองตัวแปรอื่นอีกกี่แบบ หากใช้ตัวอย่างประเมินเพื่อเลือกแบบจำลอง ให้ระบุว่าการทดสอบเป็นส่วนหนึ่งของขั้นตอนดังกล่าว แทนการเรียกว่าเป็นหลักฐานนอกตัวอย่างที่ไม่ถูกแตะต้อง รายงานที่ชัดเจนช่วยให้ผู้อ่านเห็นว่าการทดสอบเปรียบเทียบอะไร และยังมีปัญหาความไม่แน่นอนหรืออคติจากการคัดเลือกใดเหลืออยู่
คำถามที่พบบ่อย
Q1การทดสอบ Diebold–Mariano ต้องสมมติว่าความคลาดเคลื่อนของพยากรณ์แจกแจงแบบปกติหรือไม่?
ไม่จำเป็น กรอบวิธีนี้รองรับความคลาดเคลื่อนที่ไม่ได้แจกแจงแบบปกติได้ แต่ยังต้องประมาณความแปรปรวนของผลต่างค่าความสูญเสียอย่างเหมาะสมและมีเงื่อนไขความสม่ำเสมอที่รองรับการแจกแจงอ้างอิง
Q2เปรียบเทียบแบบจำลองสองแบบที่พยากรณ์คนละระยะได้หรือไม่?
ไม่ควรตีความว่าเป็นการเปรียบเทียบความแม่นยำแบบเงื่อนไขเดียวกัน ควรจัดเป้าหมายและระยะพยากรณ์ให้ตรงกันก่อน มิฉะนั้นแต่ละแบบจำลองกำลังตอบคำถามการพยากรณ์คนละข้อ
Q3ผลการทดสอบ DM ที่มีนัยสำคัญเพียงพอให้เลือกแบบจำลองสำหรับการเทรดหรือไม่?
ไม่เพียงพอ ผลนั้นเป็นหลักฐานเกี่ยวกับค่าความสูญเสียจากพยากรณ์ที่คาดหวังภายใต้การเปรียบเทียบที่กำหนด คุณยังต้องพิจารณาการค้นหาแบบจำลอง กฎการตัดสินใจ ต้นทุนการส่งคำสั่งและการเงิน และผลการเทรดนอกตัวอย่าง งานวิจัยหลัก - Diebold และ Mariano, “Comparing Predictive Accuracy” (1995) - Harvey, Leybourne และ Newbold, “Testing the Equality of Prediction Mean Squared Errors” (1997)00719-4) - Giacomini และ White, “Tests of Conditional Predictive Ability” (2006) - Clark และ West, “Approximately Normal Tests for Equal Predictive Accuracy in Nested Models” (2007) - Newey และ West, “A Simple, Positive Semi-Definite, Heteroskedasticity and Autocorrelation Consistent Covariance Matrix” (1987)
แหล่งข้อมูลและการอ่านเพิ่มเติม
รายงานปัญหา
เราจะเตรียมอีเมลพร้อมลิงก์บทความนี้ Mark จะได้รับรายงานเมื่อคุณส่งอีเมลแล้วเท่านั้น
ตรวจสอบอย่างรวดเร็ว
อ่านคู่มือจบแล้ว ลองตอบคำถาม 3 ข้อ
คำถาม 01
เมื่อกำหนด dₜ = L(eA,ₜ) − L(eB,ₜ) ค่าเฉลี่ยตัวอย่างที่เป็นบวกสนับสนุนแบบจำลองใด?
เลือกคำตอบเพื่อดูคำอธิบาย
อภิธานศัพท์ออปชัน
คำจำกัดความที่ชัดเจนของคำสำคัญ ตั้งแต่ call, put และตารางออปชัน ไปจนถึง IV กรีก ดอกเบี้ยคงค้าง และ max pain
ดูอภิธานศัพท์ออปชัน