

Тест Ljung–Box на автокорреляцию временных рядов
Узнайте, как статистика Ljung–Box Q объединяет автокорреляции остатков, как выбирать лаги и степени свободы и что тест не может установить о финансовой доходности.
В этом руководствеЧто проверяет тест Ljung–Box
Краткое резюме
Тест Ljung–Box проверяет, согласуются ли совместно с нулем автокорреляции до выбранного лага. Для остатков модели он проверяет наличие оставшейся линейной зависимости в этом диапазоне, но не доказывает независимость, нормальность, правильность модели или доступный для торговли прогноз доходности.
Что проверяет тест Ljung–Box
График выборочной автокорреляции может показывать зависимость на нескольких лагах, однако отдельный анализ каждого столбца создает проблему множественного тестирования. Тест Ljung–Box объединяет первые \(h\) выборочных автокорреляций в одну сводную статистику. Нулевая гипотеза утверждает, что автокорреляции генеральной совокупности на лагах от 1 до \(h\) равны нулю. Альтернатива состоит в том, что хотя бы одна из них отличается от нуля.
Box и Pierce разработали общий тест недостатка соответствия для оцененных моделей временных рядов. Ljung и Box изменили статистику, чтобы улучшить приближение на конечных выборках. Термин «сводный» означает, что одна статистика обобщает корреляции на нескольких лагах; он не означает, что проверены все виды зависимости временного ряда.
Для ряда доходностей вопрос может состоять в том, сохраняют ли прошлые доходности со знаком линейную временную зависимость. Для оцененной модели ARMA обычно проверяют, осталась ли автокорреляция в остатках после учета заданной лаговой структуры. Это связанные, но разные применения, поэтому перед интерпретацией результата укажите, какой ряд вы проверяли.
Рассчитайте статистики Box–Pierce и Ljung–Box
Обозначим через \(\hat\rho_k\) выборочную автокорреляцию на лаге \(k\), через \(n\) — число наблюдений, использованных для ее вычисления, а через \(h\) — максимальный лаг теста. Статистика Box–Pierce равна
\[ Q_{BP}=n\sum_{k=1}^{h}\hat\rho_k^2. \]
Поправка Ljung–Box взвешивает каждый лаг с учетом доступного объема выборки:
\[ Q_{LB}=n(n+2)\sum_{k=1}^{h}\frac{\hat\rho_k^2}{n-k}. \]
Поскольку корреляции возводятся в квадрат, статистику увеличивает как положительная, так и отрицательная автокорреляция. Поправка присваивает больший вес корреляции того же оцененного размера на лаге, где доступно меньше пар наблюдений. При больших выборках две статистики часто сближаются; на конечных выборках обычно используют Ljung–Box, поскольку в первоначальной работе его приближение для малых выборок оказалось лучше.
При нулевой гипотезе белого шума и необходимых условиях регулярности \(Q_{LB}\) сравнивают с распределением хи-квадрат. Для исходного ряда без оцененных динамических параметров обычно используют \(h\) степеней свободы. Для остатков оцененной модели ARMA(\(p,q\)) общая поправка равна \(h-p-q\), если это число положительно. Она учитывает параметры, использованные при описании динамики остатков; это не универсальное указание вычитать каждый коэффициент из любой регрессии. Для интегрированных, сезонных, ограниченных и других специализированных моделей могут применяться иные правила. Сопоставьте степени свободы с точным тестом остатков и реализацией программы. Например, проверка остатков ARMA(2,2) только до \(h=4\) оставляет ноль степеней свободы по общей поправке. Обычное сравнение с хи-квадрат недоступно; выберите заранее более длинный диапазон лагов или диагностический метод для данной модели, а не применяйте распределение с нулем степеней свободы. Также укажите, почему выбрали такой горизонт лагов.
Разберите гипотетический расчет для остатков
Предположим, после оценки модели осталось \(n=250\) остатков, а заранее заданная проверка пяти лагов дала автокорреляции \(0.10, 0.05, -0.08, 0.02, -0.04\). В расчете Box–Pierce сначала возводим их в квадрат и суммируем:
\[ 0.10^2+0.05^2+(-0.08)^2+0.02^2+(-0.04)^2=0.0209. \]
Тогда \(Q_{BP}=250(0.0209)=5.225\). С весами Ljung–Box получаем
\[ Q_{LB}=250(252)\left(\frac{0.0100}{249}+\frac{0.0025}{248}+\frac{0.0064}{247}+\frac{0.0004}{246}+\frac{0.0016}{245}\right)\approx 5.31. \]
Это еще не p-значение. Если остатки получены после оценки ARMA(1,1), обычно используют \(h-p-q=5-1-1=3\) степени свободы. Исходный ряд при своей нулевой гипотезе может использовать пять. Выбор степеней свободы меняет верхнюю хвостовую вероятность. Все числа здесь придуманы для иллюстрации арифметики; это не наблюдавшиеся рыночные данные и не результат реальной модели.
Небольшая статистика означает, что наблюдаемые квадраты автокорреляций не являются необычно большими относительно выбранного распределения. Это не доказывает, что корреляции точно равны нулю. Большая статистика означает, что весь набор плохо согласуется с нулевой гипотезой на выбранном уровне; проверьте, какие лаги и особенности модели обусловили результат, а не считайте одно число диагнозом.
Выберите горизонт лагов до поиска наиболее выгодного результата
Максимальный лаг \(h\) задает проверяемый вопрос. Несколько коротких лагов могут не выявить более медленную зависимость или недельную закономерность в ежедневных наблюдениях. Слишком длинный диапазон добавляет слабые и шумные оценки, снижает мощность против определенного краткосрочного паттерна и делает результат чувствительным к нескольким дальним лагам. Большой \(h\) также оставляет меньше степеней свободы после поправки ARMA.
Выбирайте лаги с учетом частоты наблюдений, известной календарной структуры, задачи модели и зависимости, которой уже не должно быть в остатках. Для ежедневных рыночных данных лаг торговой сессии не всегда равен календарному дню. Внутридневные данные могут иметь сезонность по времени суток и ночные эффекты. Сезонной модели могут понадобиться сезонные лаги или специальный сезонный тест; один общий порог может скрыть эту структуру.
Если вы пробуете много значений \(h\), преобразований, активов или порядков модели и сообщаете только минимальное p-значение, указанная значимость не учитывает процесс поиска. До интерпретации диагностики задайте диапазон лагов и правило принятия решения либо учтите широкий поиск в плане вывода.
Сопоставьте график автокорреляции с совместной статистикой
На графике автокорреляции часто показывают приблизительные границы для отдельного лага, например \(\pm1.96/\sqrt{n}\). В простой модели белого шума ими можно отметить отдельную выборочную корреляцию, но это не одновременный 95-процентный диапазон для всех лагов. Раздельный просмотр большого числа столбцов увеличивает вероятность случайного выхода хотя бы одного за границу. Тест Ljung–Box задает один совместный вопрос для заранее выбранного набора лагов и использует опорное распределение для объединенной статистики.
Совместная статистика может вырасти из-за одной сравнительно большой автокорреляции или нескольких умеренных. После теста изучите вклады отдельных лагов \(n(n+2)\hat\rho_k^2/(n-k)\) и график ACF. Один столбец за эвристической границей не равнозначен значимому результату сводного теста; а нахождение всех столбцов внутри отдельных границ не гарантирует незначимость совместной статистики.
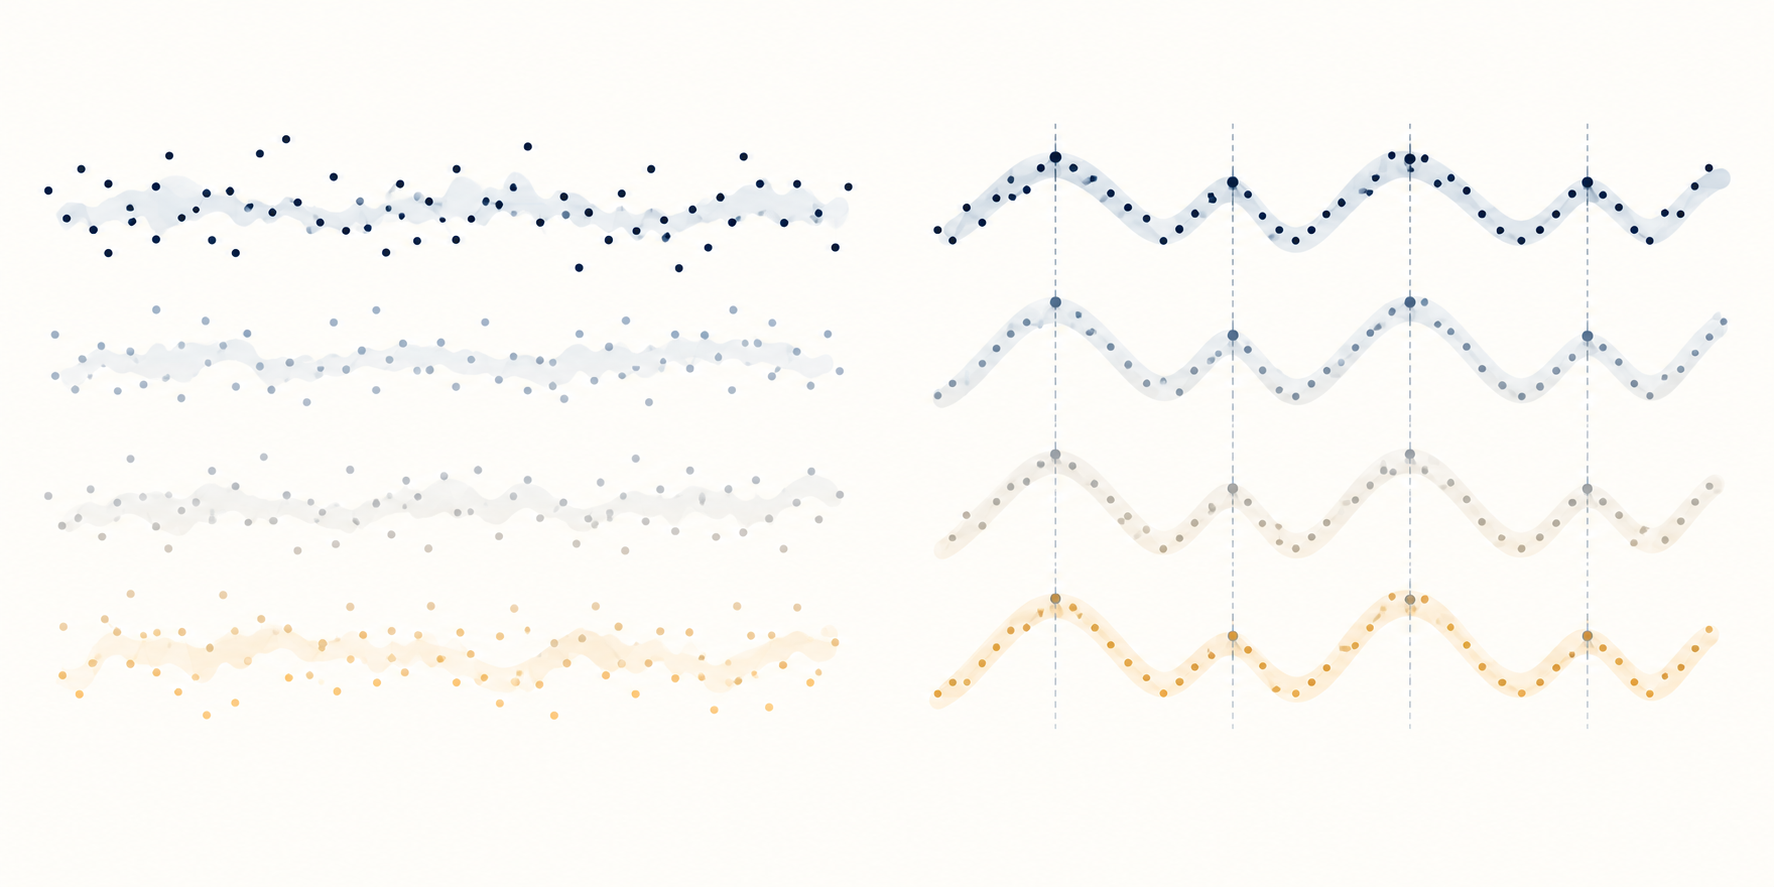
Различайте исходную доходность, остатки модели и квадраты остатков
Применение теста к доходностям со знаком проверяет, равны ли совместно нулю их линейные автокорреляции до лага \(h\). Проверка оцененных остатков показывает, оставила ли выбранная модель похожую линейную зависимость. Отвержение может стать поводом проверить спецификацию среднего, временную разметку, рыночный календарь и графики остатков; оно само по себе не определяет пропущенный член модели.
Проверьте, не создают ли зависимость перекрывающиеся окна доходности
Само определение наблюдений может породить автокорреляцию, даже если базовые однопериодные доходности не коррелируют. Например, пятиисессионная скользящая доходность и следующая пятиисессионная доходность имеют четыре общие дневные доходности. Такое перекрытие механически связывает соседние наблюдения. Ljung–Box может корректно отвергнуть отсутствие автокорреляции в построенном ряду, не показывая, что неперекрывающуюся дневную доходность можно было прогнозировать.
Укажите, являются ли наблюдения дневными доходностями, скользящими доходностями за несколько дней или остатками модели с перекрывающимися результатами. Согласуйте календарь торговых сессий, время закрытия и ночной интервал с экономическим вопросом. Если перекрывающиеся горизонты необходимы, используйте подходящий для этой конструкции вывод и опорное распределение; не трактуйте результат как самостоятельное свидетельство торгового преимущества.
Кластеризация волатильности возможна и при слабой автокорреляции доходностей со знаком. Возведение остатков в квадрат меняет вопрос: автокорреляция квадратов или абсолютных стандартизованных остатков может указывать на зависимость масштаба доходностей. McLeod и Li изучали автокорреляции квадратов остатков как диагностику нелинейной зависимости после оценки ARMA. Это по-прежнему диагностика, а не доказательство единственно верной модели волатильности. В руководстве по ARCH-LM рассматривается более целевой тест зависимости типа ARCH, а руководство по GARCH объясняет моделирование условной дисперсии.
Нулевая автокорреляция — более слабое условие, чем независимость. В ряду могут быть нулевые корреляции на проверенных лагах, но сохраняться зависимость через нелинейные преобразования, условную дисперсию, хвосты распределения или режимы. Одна статистика Ljung–Box также ничего не говорит о нормальности, стационарности, причинной структуре или доходе после издержек исполнения.
Проверьте опорное распределение после оценки параметров
Простое приближение хи-квадрат зависит от модели, построения остатков, объема выборки и способа оценки параметров. Если сначала оценена ARMA-модель, автокорреляции остатков являются оцененными величинами, а не корреляциями непосредственно наблюдаемых инноваций. Обычная поправка степеней свободы — практическое асимптотическое правило, а не гарантия точности на конечной выборке для любой спецификации.
Малые выборки, большой горизонт лагов, почти взаимно сокращающиеся корни AR и MA, выбросы, условная гетероскедастичность или временная зависимость вне выбранного семейства моделей могут снизить надежность приближения. Отвержение может отражать неверную спецификацию среднего, проблемы качества данных или неподходящее опорное распределение. Неотвержение может быть следствием низкой мощности или выбора лагов, не охватившего интересующую зависимость.
Для сложной или нестандартной модели используйте диагностическую процедуру с распределением, соответствующим оцениванию, либо проверяйте калибровку обоснованным бутстрэпом, который повторяет этап оценивания. Независимое повторное выборочное извлечение остатков не становится автоматически корректным, если проблема связана с зависимостью или изменением дисперсии. Опишите схему повторной выборки и отделите выбор модели от итоговой оценки.
Рассматривайте отвержение как начало диагностики, а не торговый сигнал
После отвержения проверьте функцию автокорреляции, при необходимости — частичную автокорреляцию, временное расположение остатков и вклады отдельных лагов в \(Q_{LB}\). Оцените, является ли закономерность краткосрочной или сезонной, вызвана ли она пропущенным членом среднего либо сосредоточена в квадратах остатков. Изменения спецификации должны отвечать обоснованному вопросу и проверяться на данных, не использовавшихся для выбора.
Для торгового правила предсказуемый паттерн на выборке еще не означает исполнимого преимущества. Прогноз следующего шага должен быть доступен до отправки ордера, сохраняться на хронологической отложенной выборке и учитывать спред, рыночное воздействие, комиссии, финансирование, заем активов и оборот. Тест Ljung–Box не проверяет чистую прибыль стратегии и не доказывает, что отвержение сохранится вне выборки.
Укажите определение и число наблюдений, проверяемый ряд, преобразования, предел лагов, отдельные автокорреляции или график, вариант теста, опорные степени свободы, статистику, p-значение и уровень значимости. Для финансовой доходности также опишите обработку торговых сессий, пропусков, перекрывающихся горизонтов и оцененной условной дисперсии. Это позволит читателю понять, что проверил тест и что осталось неразрешенным.
Статья Box и Pierce 1970 года развивает общую статистику автокорреляции остатков. Статья Ljung и Box 1978 года предлагает поправку для конечной выборки. Статья McLeod и Li 1983 года рассматривает автокорреляции квадратов остатков. Справочник NIST по Box–Ljung описывает статистику и поправку степеней свободы для остатков. См. также руководства по тестам отношения дисперсий, ARCH-LM и кластеризации волатильности GARCH.
Частые вопросы
Q1Доказывает ли незначимый результат Ljung–Box, что остатки являются белым шумом?
Нет. Он означает, что выбранные автокорреляции не были достаточно большими для отвержения совместной гипотезы на заданном уровне. Могут сохраняться зависимость на других лагах, нелинейная зависимость, кластеризация волатильности или низкая мощность теста.
Q2Какие степени свободы использовать для остатков оцененной ARMA-модели?
Если значение положительно, обычно используют \(h-p-q\) для проверки остатков ARMA(\(p,q\)), но для сезонных и специализированных моделей могут действовать другие правила. Согласуйте опорное распределение с конкретной моделью и реализацией.
Q3Может ли Ljung–Box выявить прибыльный паттерн доходности?
Нет. Это диагностика совместной автокорреляции до выбранных лагов. Утверждение о прогнозе или торговле требует заранее заданного правила реального времени, хронологических вневыборочных свидетельств и реалистичных издержек исполнения.
Источники и дополнительное чтение
Сообщить о проблеме
Мы подготовим письмо со ссылкой на эту статью. Mark получит сообщение только после отправки
Быстрая проверка
Прочитали руководство? Проверьте себя в 3 вопросах
Вопрос 01
Какова нулевая гипотеза теста Ljung–Box до лага h?
Выберите ответ, чтобы увидеть объяснение