

Testes Bai–Perron para múltiplas quebras estruturais em regressões
Entenda como os métodos Bai–Perron buscam um número e datas desconhecidos de quebras na regressão, como funcionam o trimming e os valores críticos e o que as estimativas não permitem concluir.
Neste guiaQue pergunta um teste de regressão com múltiplas quebras faz
Resumo breve
Os métodos Bai–Perron estimam conjuntamente as datas de quebra da regressão para um número fixado de quebras. Em seguida, testes ou critérios de seleção de modelo avaliam quantas quebras os dados sustentam. As datas e a quantidade dependem da regressão, do tamanho mínimo dos segmentos, das hipóteses sobre os erros e do procedimento de busca; elas não identificam uma causa nem uma vantagem de trading.
Que pergunta um teste de regressão com múltiplas quebras faz
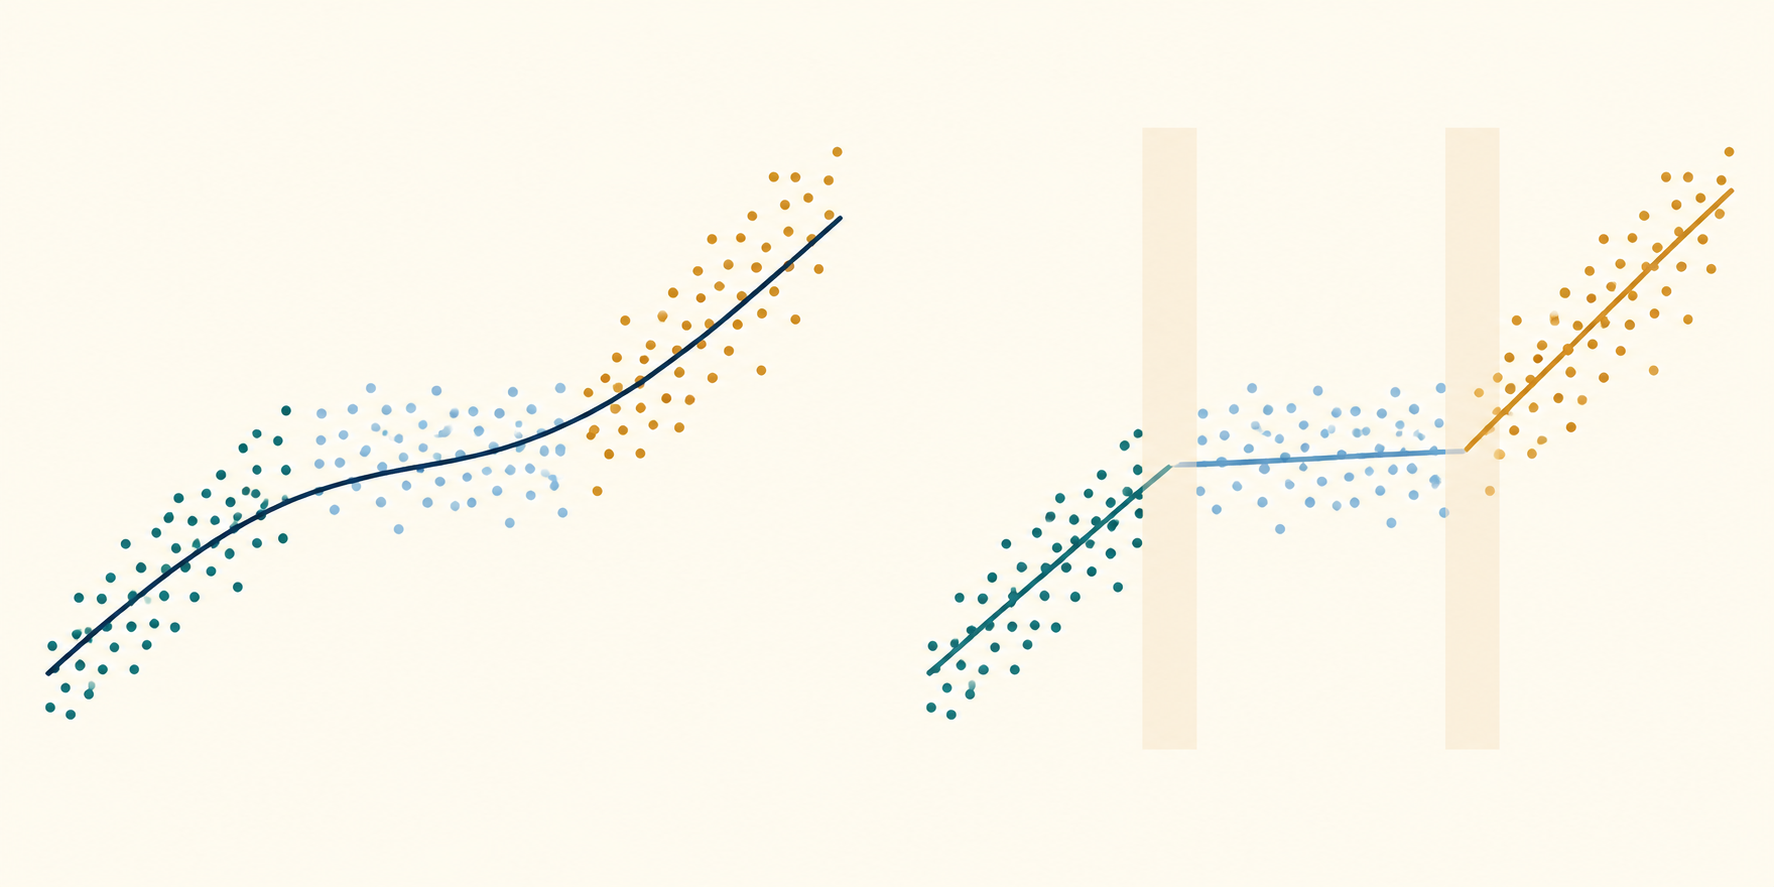
Uma quebra estrutural em uma regressão significa que um ou mais coeficientes podem ter mudado em um ponto desconhecido da amostra. Uma única estimativa para toda a amostra pode ocultar isso: se a relação entre retorno e risco é positiva em um período e depois enfraquece ou se inverte, o coeficiente médio talvez não descreva bem nenhum dos dois períodos. Os métodos Bai–Perron transformam essa preocupação em uma busca explícita entre partições possíveis das observações.
A diferença essencial em relação ao teste de Chow é se a data foi definida com antecedência. O teste de Chow compara subamostras em torno de uma data informada. Testar muitas datas e reportar a maior estatística Chow comum não preserva a distribuição de referência habitual de um único teste. Os testes Bai–Perron levam em conta a busca por datas candidatas e podem avaliar mais de uma quebra. Para o caso de uma data predefinida, veja o guia do teste de Chow.
Também é importante distingui-lo do CUSUM de regressão. O CUSUM examina uma trajetória ordenada de resíduos recursivos em busca de evidências contra a estabilidade, mas, por si só, não fornece um conjunto selecionado de várias datas de quebra. O Bai–Perron estima uma partição sob um modelo explícito de regressão por segmentos. Nenhum dos métodos explica por que uma relação mudou. Para o diagnóstico baseado na trajetória dos resíduos, consulte o guia do CUSUM de regressão.
Escreva a regressão com datas e número de quebras desconhecidos
Suponha que haja \(T\) observações e \(m\) quebras em datas inteiras \(T_1<\cdots<T_m\). Defina \(T_0=0\) e \(T_{m+1}=T\), e considere o segmento \(j\) como as observações \(T_{j-1}+1,\ldots,T_j\). Em um modelo de mudança estrutural pura,
\[ y_t=x_t'\beta_j+u_t,\qquad T_{j-1}<t\le T_j,\quad j=1,\ldots,m+1. \]
Aqui, \(y_t\) é o resultado, \(x_t\) é o vetor de regressores incluídos, \(\beta_j\) é o vetor de coeficientes do segmento \(j\) e \(u_t\) é o erro. As incógnitas não são apenas os coeficientes: a menos que o desenho as fixe, também é preciso estimar ou selecionar as datas de quebra e o número \(m\). O modelo ainda pressupõe que as observações tenham uma ordem significativa e que, segundo a especificação escolhida, cada segmento tenha um vetor de coeficientes estável.
Em um exemplo financeiro, \(y_t\) pode ser o retorno de uma carteira e \(x_t\) pode incluir o retorno do mercado, uma variação da taxa de juros ou uma medida de volatilidade. Detectar uma quebra significa que, dentro da amostra e pelo procedimento usado, a média condicional linear por segmentos se ajusta melhor. Isso não implica que um evento específico tenha mudado o coeficiente, que a variável explicativa seja exógena ou que a relação permaneça estável fora da amostra.
É útil distinguir a data da observação da data do calendário. Se as observações forem sessões diárias de negociação, uma quebra entre as sessões 120 e 121 não precisa corresponder a um único dia corrido; feriados, cotações ausentes e intervalos irregulares afetam essa associação. Especifique como a amostra foi ordenada e como a data da quebra é informada antes de tratá-la como o horário de um evento.
Escolha deliberadamente entre mudança estrutural pura e parcial
Em um modelo de mudança estrutural pura, todos os coeficientes de \(\beta_j\) podem variar entre segmentos. Isso permite mudanças no intercepto e em todas as inclinações, mas exige mais parâmetros específicos por segmento. Por isso, pode ser difícil estimar quebras com precisão quando os segmentos são curtos ou o vetor de regressores é grande. A mudança pura só é adequada quando a pergunta permite que todas as relações modeladas se redefinam.
Em um modelo de mudança estrutural parcial, alguns coeficientes permanecem comuns e outros podem mudar. Por exemplo, escreva \(\beta_j=(\delta',\gamma_j')'\), em que \(\delta\) é compartilhado entre segmentos e \(\gamma_j\) é específico de cada segmento. Isso pode representar uma restrição substantiva: permitir que o intercepto e a inclinação da exposição a uma política mudem, mantendo comum o efeito de uma variável de controle. A restrição altera tanto o objetivo de ajuste quanto a distribuição de referência do teste. Ela deve ser declarada, e não tratada como uma simplificação sem consequências.
O cálculo também é diferente. Na mudança pura, a soma dos quadrados dos resíduos (RSS) de uma partição é a soma das RSS independentes dos segmentos, então uma recorrência de programação dinâmica pode otimizar a partição para um número fixo de quebras. No modelo parcial, os coeficientes comuns conectam todos os segmentos. Bai e Perron descrevem um procedimento iterativo: estimam-se as datas e os coeficientes variáveis com os coeficientes comuns fixos e, depois, atualizam-se os coeficientes comuns para uma partição dada. A recorrência aditiva simples de RSS por segmento, sozinha, não resolve todo esse problema com restrições. Escolha a especificação segundo a questão científica ou de previsão, não segundo a versão que encontra mais quebras.
Defina o tamanho mínimo do segmento antes de examinar as datas candidatas
A busca exige um número mínimo de observações em cada segmento. Essa regra de trimming evita ajustar intervalos extremamente curtos que podem gerar coeficientes instáveis, mas também exclui mudanças reais muito próximas à borda da amostra ou a outra quebra. A regra faz parte do desenho do estudo; não é uma lei universal.
Considere um exemplo explicitamente hipotético com \(T=240\) observações e uma fração de trimming escolhida de 15%. Isso resulta em \(h=0{,}15\times240=36\) observações como tamanho mínimo de cada segmento. Se a data de quebra marcar a última observação do segmento anterior, com uma quebra as datas admissíveis são \(36\le T_1\le204\). Assim, cada lado contém pelo menos 36 observações.
Com duas quebras, os pares de datas admissíveis devem satisfazer:
\[ 36\le T_1,\qquad T_1+36\le T_2\le204. \]
Em outras palavras, \(T_1\le168\), e \(T_2\) deve ficar pelo menos 36 observações depois da primeira quebra e deixar 36 observações após a segunda. O par \((72,156)\) é admissível: os três segmentos têm 72, 84 e 84 observações. \((80,100)\) não é, pois o segmento do meio tem apenas 20 observações. Com esse \(h\), cabem no máximo cinco quebras em 240 observações: seis segmentos exigem pelo menos \(6\times36=216\) observações, enquanto sete exigiriam 252.
Os 15% são uma escolha de desenho explicitamente hipotética, não uma recomendação padrão. Uma fração maior pode excluir regimes breves e datas próximas às bordas da amostra; uma fração menor admite segmentos curtos, mas pode deixar pouca informação para estimar inclinações e quantidades de covariância de longo prazo com confiabilidade. Escolha a regra conforme a frequência de amostragem, o número de regressores, a duração plausível dos regimes e o método de inferência. Informe a escolha e, quando fizer sentido, mostre se as conclusões mudam com valores próximos. Com defasagens ou observações ausentes, implementações podem definir de outra forma o tamanho efetivo da amostra e os extremos; documente a convenção usada.
Use programação dinâmica para encontrar uma segmentação global com quantidade fixa
Em um modelo de mudança pura com \(m\) fixo, a busca por datas pode ser expressa como a minimização da RSS total dos segmentos:
\[ \min_{T_1,\ldots,T_m}\;\sum_{j=1}^{m+1}\operatorname{SSR}(T_{j-1}+1,T_j), \]
sujeita à ordem das datas e ao tamanho mínimo dos segmentos. \(\operatorname{SSR}(a,b)\) é a menor soma dos quadrados dos resíduos de mínimos quadrados ao ajustar um único segmento às observações \(a,\ldots,b\). Uma busca ingênua verifica todas as combinações de datas, cujo número cresce rapidamente com \(T\) e \(m\).
A programação dinâmica reutiliza subproblemas já otimizados. Se \(D(r,j)\) é a menor RSS para dividir as observações de 1 a \(j\) em \(r\) segmentos válidos, uma forma da recorrência é
\[ D(r,j)=\min_i\{D(r-1,i)+\operatorname{SSR}(i+1,j)\}, \]
em que a divisão \(i\) é restrita para que cada um dos primeiros \(r-1\) segmentos e o último satisfaçam o tamanho mínimo. Guardar a divisão que minimiza cada etapa permite recuperar as datas. Para cada número permitido de segmentos, o algoritmo encontra a partição de RSS globalmente mínima sob o modelo e as restrições especificados, em vez de acrescentar quebras uma a uma de forma gulosa. Bai e Perron (2003) desenvolvem o cálculo e discutem modelos de mudança pura e parcial.
“Global” aqui é condicional ao número escolhido, aos regressores, aos termos determinísticos, ao trimming e à função objetivo. Isso não significa que o modelo estatístico seja verdadeiro, que esse número esteja correto ou que a partição seja globalmente ótima entre todas as especificações possíveis. O procedimento pode comparar vários números com eficiência, mas selecionar \(m\) é uma etapa separada de inferência ou seleção de modelo.
Selecione o número de quebras com inferência ajustada pela busca ou critérios
Depois de calcular as melhores partições para números candidatos, há várias abordagens para escolher \(m\). Um teste sequencial \(\sup F(\ell+1\mid\ell)\) compara um modelo com \(\ell\) quebras a outro com uma quebra adicional, usando o supremo da estatística sobre as datas admissíveis. Testes de máximo duplo, como UDmax ou WDmax, testam a hipótese de nenhuma quebra contra uma alternativa com número desconhecido de quebras até um máximo definido. Critérios de informação, inclusive os do tipo BIC, comparam melhorias de ajuste com uma penalidade de complexidade. Esses métodos respondem a perguntas relacionadas, mas diferentes.
Em geral, o valor crítico F comum não é apropriado depois de maximizar sobre datas de quebra desconhecidas. Sob a hipótese nula de nenhuma quebra, as datas candidatas não são identificadas da mesma forma que sob a alternativa, o que produz distribuições assintóticas não padronizadas. Os valores críticos dependem de fatores como trimming, mudança pura ou parcial, regressores e hipóteses sobre a covariância dos erros. Bai e Perron (1998) derivam testes para múltiplas mudanças; o estudo posterior de valores críticos apresenta valores para diferentes regras de trimming e especificações de modelo. Andrews (1993) traz resultados importantes para testes de instabilidade com um ponto de mudança desconhecido, mas seus valores críticos não substituem um procedimento para múltiplas quebras.
Testes sequenciais são interpretáveis, mas o resultado pode depender do poder em cada etapa e do número máximo de quebras predefinido. Critérios de informação podem selecionar quantidades diferentes porque suas penalidades diferem e porque todos os modelos candidatos podem ser aproximações. Mais quebras não significam automaticamente uma descrição mais realista: um pequeno ganho de ajuste pode custar coeficientes instáveis por segmento. Informe o método, o número máximo, o trimming, a sequência de testes ou o critério e as hipóteses dos valores críticos correspondentes. Se a escolha for importante, mostre a sensibilidade em vez de apresentar uma única quantidade como certa.
Trate as datas estimadas como estimativas condicionais com incerteza
As datas que minimizam o critério são estimativas pontuais sob um modelo especificado. Não as apresente como se os dados revelassem o instante exato em que uma relação econômica mudou. Variação amostral, uma pequena mudança de coeficiente, quebras próximas, resultados ruidosos, regressores com pouca variação e um tamanho mínimo de segmento longo podem deixar o objetivo relativamente plano ao redor do mínimo. Várias partições próximas podem se ajustar quase tão bem quanto a escolhida.
Bai e Perron desenvolvem intervalos de confiança para datas de quebra sob condições especificadas. Esses intervalos descrevem a incerteza amostral das datas modeladas; não abrangem toda a incerteza sobre a especificação correta da regressão, as variáveis a incluir, o número de quebras ou a regra de trimming. Se o próprio número de quebras for incerto, um intervalo estreito condicionado a uma única quantidade escolhida pode subestimar a incerteza total.
Na prática, diferencie a convenção de data, o índice de observação estimado, a data de calendário correspondente e o intervalo de cada quebra. Se os intervalos forem amplos ou se sobrepuserem, descreva a localização como pouco precisa. Não escolha uma data em um gráfico depois de ver o resultado e depois a apresente como o momento de um evento previsto de forma independente. Ao comparar quebras estimadas com um evento conhecido, considere que o evento e a janela talvez tenham sido selecionados depois de examinar os dados.
Ajuste a inferência à dependência serial e às mudanças de variância
A partição de RSS é um critério de ajuste; a validade dos testes e dos intervalos de confiança depende das hipóteses sobre regressores e erros. Regressões financeiras podem ter autocorrelação, heterocedasticidade condicional, valores atípicos, volatilidade variável, retornos sobrepostos ou observações assíncronas. Se o estimador de covariância e os valores críticos presumirem erros independentes e com variância constante enquanto os resíduos são dependentes ou heterocedásticos, a significância reportada pode ser enganosa mesmo quando as datas estimadas parecem plausíveis.
Os trabalhos Bai–Perron desenvolvem procedimentos sob condições mais gerais, incluindo formas de heterocedasticidade e dependência serial. Ainda assim, o analista precisa usar a correção de covariância e os valores de referência adequados à aplicação. Uma estimativa robusta ou HAC da covariância não corrige dinâmica omitida, regressor endógeno, média condicional especificada incorretamente ou um calendário de observações que combina intervalos incompatíveis. Usar um erro padrão robusto, por si só, também não transforma a função objetivo RSS em um modelo melhor dos dados.
Verifique a dependência e os padrões de variância dos resíduos dentro e entre os segmentos candidatos. Informe se as hipóteses sobre os erros permitem variâncias específicas por segmento, correlação serial ou mudanças na distribuição dos regressores, e se a teoria do teste escolhido cobre esses casos. Em segmentos muito curtos, a estimação robusta de covariância é especialmente frágil; por isso, trimming e dimensão do modelo devem ser planejados em conjunto. Para conceitos básicos sobre estimação de regressão e hipóteses de covariância, consulte o guia de regressão OLS.
Relate a análise de quebras sem transformá-la em uma afirmação causal ou de trading
Um relatório reproduzível informa o resultado, todos os regressores, as transformações, o período e a frequência da amostra, o intercepto e as restrições aos coeficientes, a especificação de mudança pura ou parcial, o máximo de candidatas \(m\), a fração de trimming e o tamanho mínimo, a convenção de data, o método de otimização e o teste ou critério usado para selecionar \(m\). Inclua o número selecionado de quebras, os coeficientes por segmento, as datas e os intervalos de incerteza, as estatísticas de teste, o tratamento da covariância e a fonte dos valores críticos. Explique quais pontos extremos ou observações foram excluídos da busca.
Uma quebra detectada estatisticamente é evidência de instabilidade de parâmetros na regressão especificada, sob suas hipóteses. Ela não identifica o evento que causou a mudança, não prova que um comunicado específico ou uma política tenha sido responsável e não mostra que os coeficientes antes ou depois da quebra persistirão. A quebra pode refletir uma variável omitida, mudança na definição dos dados, episódio de volatilidade, problema de medição ou mudança econômica real; o teste de regressão não distingue essas explicações.
No trading quantitativo, uma busca na amostra inteira usa observações dos dois lados de cada quebra estimada. Negociar como se a data selecionada fosse conhecida em tempo real introduz viés de antecipação. Avalie cronologicamente qualquer regra de regime proposta e reestime apenas com informações disponíveis em cada data; inclua spread, tarifas, impacto de mercado, financiamento, empréstimo, giro e latência. Compare com referências simples de parâmetro fixo e de não operar, e reserve dados realmente posteriores para validação. Uma quebra pode motivar uma revisão do modelo ou do risco, mas não comprova poder preditivo nem uma vantagem negociável.
Bai e Perron (1998) apresentam testes e estimação de múltiplas mudanças estruturais em modelos lineares em seu artigo original. O artigo de computação de 2003 explica a programação dinâmica e os procedimentos de mudança parcial; o artigo sobre valores críticos detalha como eles variam com o desenho. O artigo de Andrews sobre pontos de mudança desconhecidos oferece uma base relacionada para uma única quebra. Como diagnósticos próximos, compare o teste de Chow com data predefinida ao CUSUM de regressão.
Perguntas frequentes
Q1Bai–Perron informa o número verdadeiro de quebras?
Não. O método estima partições e oferece testes ou critérios para escolher entre números candidatos. O resultado depende da especificação da regressão, do trimming, das hipóteses sobre os erros, do número máximo e da regra de seleção; não prova que o processo gerador dos dados tivesse exatamente aquela quantidade de quebras.
Q2A data de quebra é a data em que um evento econômico causou a mudança?
Não. É uma estimativa, sujeita à incerteza amostral, da localização da instabilidade de parâmetros em um modelo ajustado. Atribuir uma causa exige evidências adicionais e um desenho que descarte explicações concorrentes.
Q3Posso negociar diretamente com base nas datas de quebra estimadas?
Não apenas com base em uma estimativa retrospectiva da amostra inteira. A busca também usa observações posteriores a uma quebra candidata. Uma regra em tempo real precisa de avaliação cronológica, informações disponíveis naquele momento, custos e validação posterior; detectar uma quebra não comprova a existência de um sinal lucrativo.
Fontes e leituras adicionais
Relatar um problema
Vamos preparar um e-mail com o link deste artigo. Mark só receberá o relato depois que você enviar
Verificação rápida
Terminou o guia? Confira o que aprendeu com 3 perguntas
Pergunta 01
Em um exemplo com 240 observações, o que significa uma regra de segmento mínimo de 15%?
Escolha uma resposta para ver a explicação
Glossário de opções
A relationship describing how an outcome would differ under a specified intervention or counterfactual change; observed association alone does not identify it.
Ler o guia completoMulticollinearityStrong linear dependence among included regressors that makes their separate coefficients imprecise and sensitive to the sample.
Ler o guia completo