

Purged cross-validation i embargo: jak zapobiegać wyciekowi etykiet w modelach tradingowych
Dowiedz się, jak purging i embargo obsługują nakładające się etykiety forward w finansowych szeregach czasowych oraz czym różnią się od walk-forward i CPCV.
W tym przewodnikuDlaczego losowy K-fold może wprowadzać w błąd w finansach
Krótkie podsumowanie
Purged cross-validation usuwa ze zbioru treningowego obserwacje, których rzeczywisty przedział etykiety nakłada się na przedział etykiety testowej. Embargo to osobno ustalony bufor przed dopuszczeniem późniejszych obserwacji do treningu w podziałach obejmujących dane po bloku testowym. Żadne z nich samo w sobie nie jest chronologiczną symulacją przyszłego użycia.
Dlaczego losowy K-fold może wprowadzać w błąd w finansach
K-fold dzieli obserwacje na części i kolejno używa każdej z nich do testowania. W finansowych szeregach czasowych losowy podział może rozrzucić między trening i test zależne obserwacje lub nakładające się okresy etykiet forward. Trening zawiera wtedy informacje powiązane z wynikami testu, przez co zmierzona skuteczność może wyglądać zbyt dobrze.
Nie oznacza to, że każde użycie K-fold jest zawsze błędne. Może pasować do pytania, gdy obserwacje są dostatecznie niezależne, a etykiety się nie nakładają. Trzeba sprawdzić, jak powstały cechy i etykiety oraz jaki przyszły sposób użycia ma odzwierciedlać walidacja. López de Prado omawia te kwestie i purging w rozdziale 7 książki *Advances in Financial Machine Learning*.
Określ dostępne informacje i przedział każdej etykiety
Dla każdej próbki oznacz t jako moment decyzji. Zapisz, jakie informacje były wtedy dostępne, jakie historyczne okno wykorzystują cechy oraz kiedy rozstrzyga się wynik. Etykieta pięciosesyjnej stopy zwrotu obejmuje tu przedział (t, t+5]; t1 oznacza jej rzeczywisty koniec.
Wspólna historia użyta do budowy cech nie jest sama w sobie wyciekiem, jeśli była znana w obu momentach prognozy. Wyciek powstaje, gdy cecha korzysta z przyszłych wartości, została obliczona retrospektywnie lub ma błędny znacznik czasu. Budowa cech musi ograniczać się do informacji dostępnych w chwili każdej prognozy.
Usuń z treningu nakładające się przedziały etykiet
Purging usuwa próbkę treningową, gdy jej rzeczywisty przedział wyniku nakłada się na przedział próbki testowej. Sprawdź rzeczywiste znaczniki czasu początku i końca. Przy etykietach zdarzeń o zmiennej długości używaj ich faktycznych granic, a nie wygodnej, stałej liczby wierszy.
Purging nie czyni podziału automatycznie chronologicznym. Purged K-fold może nadal trenować na obserwacjach późniejszych niż blok testowy. To może pomóc w innym pytaniu o odporność modelu, lecz nie odpowiada symulacji, w której trening wykorzystuje tylko przeszłość, a test następuje później. Kierunek czasu trzeba określić osobno.
Uzasadnij embargo jako osobny bufor
Embargo to określony okres po bloku testowym, zanim późniejsze obserwacje zostaną dopuszczone do treningu w podziałach korzystających z danych po teście. Może ograniczyć pozostałą zależność wynikającą z konstrukcji zdarzeń lub cech. Nie zastępuje sprawdzania faktycznych przedziałów etykiet i nie ma uniwersalnej długości ani wartości procentowej.
Dobierz długość do częstotliwości próbkowania, horyzontu etykiety, okien cech i obserwowanej zależności. Zapisz uzasadnienie przed porównaniem wyników. W ściśle chronologicznym podziale treningowym nie ma późniejszych obserwacji, do których odnosi się ten przypadek embargo.
Przykład dzienny z horyzontem pięciu sesji
Załóżmy codzienne decyzje i etykiety zwrotu z kolejnych pięciu sesji, czyli (t, t+5]. Blok testowy dla dni decyzyjnych 11–15 ma etykiety sięgające dnia 20. Dni oznaczają sesje, a wszystkie próbki stosują tę samą konwencję przedziałów.
Treningowa etykieta (7,12] nakłada się na test, bo współdzieli dni z etykietą decyzji z dnia 11. Nakłada się też (16,21], ponieważ etykieta testowa dla dnia 15 sięga dnia 20. Obie próbki treningowe należy usunąć przez purging. Późniejsza etykieta bez nakładania może mimo to zostać wyłączona przez osobno ustaloną strefę embargo. Przykład nie wyznacza uniwersalnej przerwy.
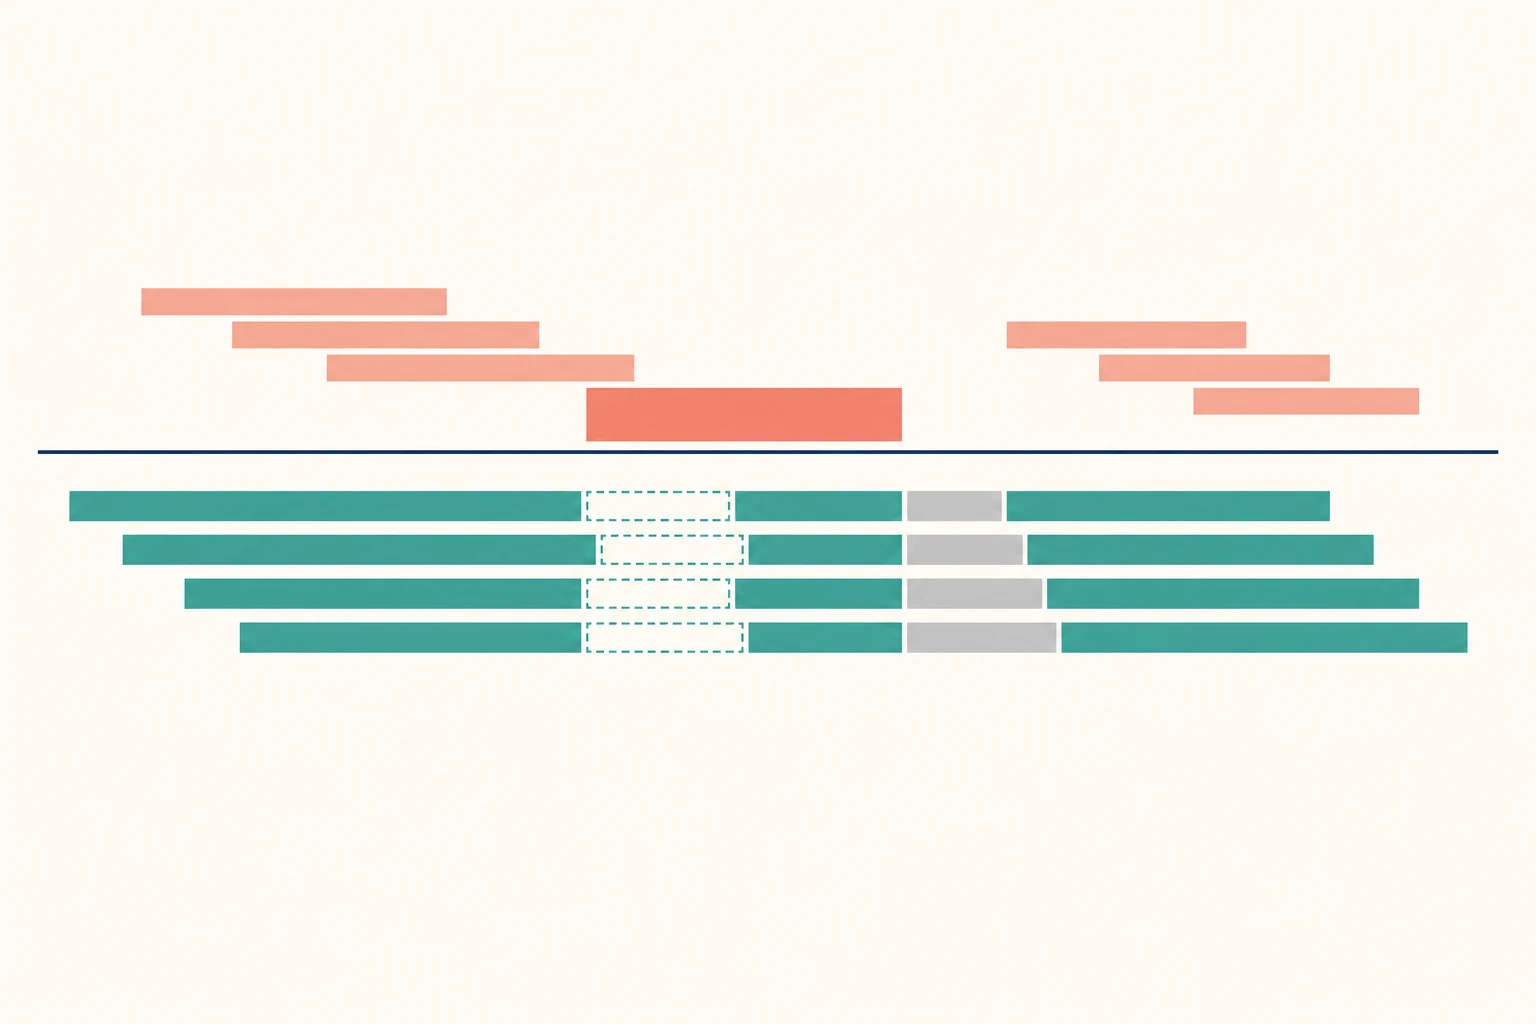
Odróżnij K-fold, walk-forward, gap, purged K-fold i CPCV
Losowy K-fold może mieszać obserwacje z różnych okresów. Walidacja walk-forward lub rolling-origin trenuje na wcześniejszych danych, a testuje na późniejszym bloku, zwykle lepiej odzwierciedlając historyczną sekwencję wdrożenia. Oficjalna dokumentacja scikit-learn dla TimeSeriesSplit opisuje podziały chronologiczne i wymaga równych odstępów między obserwacjami, jeśli długości testów mają być porównywalne.
TimeSeriesSplit(gap=...) pomija stałą liczbę wierszy przed testem. gap nie wykrywa zmiennych przedziałów zdarzeń; liczba wierszy ma sensowną interpretację czasową tylko przy odpowiednim, zwykle regularnym, próbkowaniu. Purged K-fold i Combinatorial Purged Cross-Validation (CPCV) tworzą wiele kombinacji lub ścieżek testowych, ale mogą używać w treningu danych późniejszych od bloku testowego. Nie odpowiadają więc automatycznie na to samo pytanie co historyczna symulacja walk-forward.
Rozdział 12 książki López de Prado o backtestingu szerzej omawia walk-forward i CPCV.
Inne źródła wycieku pozostają możliwe
Purging nie naprawia lookahead w cechach ani błędnych znaczników czasu, survivorship bias czy późniejszych rewizji danych. Globalna normalizacja, imputacja lub selekcja cech przed podziałem również może przenieść informacje testowe do treningu. Dopasowuj transformacje i wybór cech wewnątrz każdego treningowego foldu.
Testowanie wielu wariantów zwiększa ryzyko przypadkowego wyboru zwycięzcy backtestu. Bailey i współautorzy badają wielokrotne próby w pracy o prawdopodobieństwie przeuczenia backtestu. Do selekcji używaj zagnieżdżonej walidacji uwzględniającej czas, a na koniec zachowaj nietknięty chronologiczny holdout. Uwzględnij realistyczne koszty i realizację zleceń. Żadna cross-validation nie gwarantuje przyszłych wyników.
Raportuj wyniki i niepewność
Podaj długość próby, częstotliwość, horyzonty etykiet, dostępność cech, regułę podziału, usunięte obserwacje i uzasadnienie embargo. Wyjaśnij, czy trening dopuszczał późniejsze wiersze oraz na jakie pytanie odpowiadała metoda. Jedna łączna miara może ukrywać różnice między okresami lub ścieżkami testowymi.
Porównuj modele przy tych samych granicach czasu, etykietach, założeniach kosztowych i regułach wyboru. Uwzględnij niepewność i liczbę przetestowanych wariantów; małe różnice w krótkiej próbie są słabym dowodem. Zobacz też: kompromis bias–variance i przeuczenie modeli, wielokrotne testowanie i false discovery rate oraz annualizacja Sharpe’a przy autokorelacji szeregowej.
Ustal walidację przed uruchomieniem backtestu
Dla każdej próbki zapisz moment decyzji t, dostępne dane, okno cech i rzeczywiste granice etykiety do t1. Dobierz podział do pytania o przyszłe zastosowanie, usuń z treningu etykiety przecinające etykiety testowe, a embargo zdefiniuj osobno, gdy dotyczy późniejszych danych treningowych.
Sprawdź, czy preprocessing jest dopasowywany wewnątrz każdego foldu, opisz próby modeli i koszty, a także zachowaj nietknięty końcowy holdout chronologiczny. To zwiększa możliwość kontroli analizy, ale nie zmienia przeszłości w gwarancję przyszłych wyników. Tekst wyjaśnia mechanikę walidacji, nie stanowi porady inwestycyjnej ani rekomendacji strategii.
Częste pytania
Q1Czy losowy K-fold zawsze jest błędny dla finansowych szeregów czasowych?
Nie. Może pasować do pytania, gdy obserwacje są wystarczająco niezależne, a etykiety się nie nakładają. Przy zależności czasowej lub etykietach forward podział powinien uwzględniać tę strukturę.
Q2Czy embargo sprawia, że purging jest zbędny?
Nie. Purging sprawdza rzeczywiste nakładanie się przedziałów etykiet. Embargo dodaje bufor w niektórych podziałach z późniejszym treningiem. Obie reguły trzeba uzasadnić.
Q3Czy CPCV zastępuje testy walk-forward?
Nie automatycznie. CPCV tworzy wiele kombinacji i ścieżek testowych, ale może trenować na danych po bloku testowym. Chronologiczna symulacja historycznego użycia odpowiada na odrębne pytanie.
Źródła i dalsza lektura
Zgłoś problem
Przygotujemy e-mail z linkiem do tego artykułu. Mark otrzyma zgłoszenie dopiero po jego wysłaniu
Szybki test
Przeczytano? Sprawdź się w 3 pytaniach
Pytanie 01
Którą próbkę treningową należy usunąć przez purging?
Wybierz odpowiedź, aby zobaczyć wyjaśnienie
Słownik opcji
The relationship between systematic prediction error from model mismatch and instability caused by sensitivity to the training sample.
Czytaj szczegółowy przewodnikFamily-wise error rateThe probability of falsely rejecting at least one true null hypothesis within a predefined family of tests.
Czytaj szczegółowy przewodnikAssignmentThe process that requires an option writer to fulfill the contract after an exercise notice is allocated; it can create or remove an underlying position.
Czytaj szczegółowy przewodnik