

Ujian Diebold–Mariano: Cara Membandingkan Ketepatan Ramalan
Ketahui cara ujian Diebold–Mariano membandingkan kerugian ramalan berpasangan, menangani ufuk bertindih, dan mengapa nilai-p rendah bukan bukti kemahiran dagangan.
Dalam panduan iniRalat backtest yang lebih rendah belum membuktikan ramalan lebih baik
Ringkasan ringkas
Ujian Diebold–Mariano membandingkan dua ramalan dengan melihat perbezaan kerugian kedua-duanya pada hasil sebenar yang sama. Keputusan bergantung pada fungsi kerugian, sampel penilaian, ufuk ramalan dan anggaran ketidakpastian. Ralat sampel yang lebih rendah tidak semestinya bukti ketepatan jangkaan yang lebih baik, dan ketepatan ramalan yang lebih tinggi tidak sama dengan strategi dagangan yang menguntungkan.
Ralat backtest yang lebih rendah belum membuktikan ramalan lebih baik
Katakan dua model meramal pulangan, turun naik atau kuantiti ekonomi yang sama pada tarikh yang sama. Dalam sampel penilaian, ralat purata model A lebih kecil daripada model B. Hal itu menerangkan sampel tersebut, tetapi tidak memberitahu sama ada A lebih tepat secara konsisten atau jurang yang diperhatikan berpunca daripada variasi biasa dalam tarikh yang kebetulan diuji.
Ujian Diebold–Mariano (DM) menukar perbandingan itu menjadi siri masa berpasangan. Pada setiap titik asal ramalan, ia membandingkan kedua-dua ramalan dengan hasil sebenar yang sama, memberikan skor menggunakan fungsi kerugian yang dipilih lebih awal, lalu meneliti urutan perbezaan kerugian. Pemadanan ini penting: hari pasaran yang tidak menentu boleh meningkatkan kerugian kedua-dua model, sedangkan perbandingan menilai model mana yang cenderung mengalami kerugian lebih rendah pada hari yang sama.
Rangka kerja asal tidak terhad kepada ralat kuasa dua atau ralat ramalan yang bertaburan normal. Ia boleh membandingkan pelbagai fungsi kerugian, termasuk yang tidak simetri, apabila skor itu sesuai dengan persoalan ramalan. Namun, reka bentuk penilaian perlu berasas dan ketidakpastian bagi purata perbezaan kerugian mesti dianggarkan. Diebold dan Mariano (1995) memperkenalkan ujian kesamaan ketepatan ramalan; Harvey, Leybourne dan Newbold (1997)00719-4) mengkaji pengubahsuaian sampel kecil.
Bandingkan perkara yang setara sebelum mengira statistik
Setiap baris sepatutnya mewakili satu titik asal ramalan yang boleh dibandingkan. Kedua-dua model perlu meramal sasaran dan ufuk yang sama berdasarkan maklumat yang tersedia pada titik asal tersebut. Selaraskan hasil sebenar, cap masa, mata wang atau unit, vintaj data dan peraturan bagi pemerhatian yang hilang sebelum membandingkan kerugian. Jika satu model meramal harga penutup esok dan satu lagi meramal purata lima hari, ralatnya menjawab persoalan yang berbeza.
Gunakan ramalan yang dijana tanpa melihat masa depan. Pegangan keluar kronologi atau reka bentuk pseudo luar sampel bergulir boleh membantu, tetapi pemisahan sahaja tidak mencukupi jika pegangan keluar yang sama digunakan berulang kali untuk melaras ciri, ambang atau variasi model. Simpan ramalan yang benar-benar dibuat pada setiap titik asal sejarah, termasuk versi data dan model yang menghasilkannya. Data makro yang disemak semula, penapis bias kemandirian atau pelarasan tindakan korporat berdasarkan maklumat masa depan boleh mengubah penilaian selepas kejadian.
Nilai kedua-dua model pada kumpulan titik asal yang sama. Menggugurkan tarikh yang sukar bagi satu model tetapi tidak bagi model lain merosakkan perbandingan berpasangan. Jika ramalan tiada, tetapkan sampel bersama atau berikan alasan bagi cara menangani ramalan yang hilang; jangan biarkan model menghadapi rejim pasaran yang berbeza secara senyap. Pilih tarikh mula dan tamat sebelum meneliti sampel yang menghasilkan kesimpulan pilihan.
Fungsi kerugian mentakrifkan maksud “lebih tepat”
Biarkan nilai sebenar pada titik asal t ialah yₜ dan ramalan model ialah ŷA,ₜ serta ŷB,ₜ. Ralatnya ialah eA,ₜ = yₜ − ŷA,ₜ dan eB,ₜ = yₜ − ŷB,ₜ. Fungsi kerugian L menukar setiap ralat kepada skor; nilai yang lebih rendah adalah lebih baik. Kerugian kuasa dua, L(e) = e², mengenakan penalti yang lebih besar bagi tersasar jauh. Kerugian mutlak, L(e) = |e|, meningkat secara linear mengikut saiz tersasar. Ramalan kuantil pula boleh menggunakan kerugian pinball tidak simetri kerana kos meramal terlalu rendah dan terlalu tinggi berbeza.
Skor yang dipilih boleh mengubah model yang kelihatan lebih baik. Pertimbangkan dua pasangan ralat hipotetikal dalam unit yang sama: ralat model A ialah 0 dan 2; ralat model B ialah 1 dan 1. Dengan kerugian kuasa dua, purata kerugiannya masing-masing 2 dan 1, jadi B mendapat skor lebih baik. Dengan kerugian mutlak, purata kedua-duanya ialah 1. Tiada pengiraan yang sentiasa betul; setiap satu menjawab persoalan berbeza tentang ralat yang penting.
Bagi ramalan pulangan, ralat kuasa dua mungkin berguna untuk ramalan min bersyarat. Ramalan turun naik memerlukan skor yang direka untuk sasarannya, manakala ramalan Value-at-Risk memerlukan skor kuantil atau backtest khusus risiko. Memilih fungsi kerugian selepas melihat model yang menang menjadikan ujian itu satu lagi proses carian. Tetapkan skor dan arah “lebih baik” sebelum melihat perbandingan.
Ramalan VaR menyasarkan kuantil ekor, bukannya ramalan titik biasa. Panduan backtesting VaR menerangkan cara ujian kekerapan dan masa pelanggaran menilai ramalan risiko yang berasingan itu.
Bentuk perbezaan kerugian berpasangan dan nyatakan hipotesis nol
Bagi fungsi kerugian yang lebih rendah bermakna lebih baik, takrifkan perbezaan bagi tempoh t sebagai
dₜ = L(eA,ₜ) − L(eB,ₜ)
Dengan konvensyen tanda ini, dₜ yang positif bermakna kerugian A lebih besar, jadi model B mempunyai kerugian lebih rendah pada titik asal tersebut; nilai negatif memihak kepada A. Purata sampel ialah d̄ = (1/n) Σ dₜ. Hipotesis nol ketepatan tanpa syarat yang sama ialah E[dₜ] = 0. Alternatif dua hala bertanya sama ada kerugian jangkaan berbeza dalam mana-mana arah. Alternatif satu hala yang ditentukan lebih awal boleh menguji sama ada model tertentu mempunyai kerugian jangkaan yang lebih rendah.
Statistik asasnya ialah
DM = d̄ / √(Ŝd / n)
Di sini Ŝd menganggarkan varians jangka panjang siri perbezaan kerugian, bukannya sekadar varians ralat ramalan salah satu model. Di bawah hipotesis nol dan syarat keteraturan yang sesuai, statistik ini secara asimptotik bertaburan normal piawai. Nilai positif besar memihak kepada B mengikut konvensyen tanda di atas; nilai negatif besar memihak kepada A. Nilai-p mengukur kesesuaian data dengan hipotesis nol dan andaian pensampelan yang dinyatakan, bukannya kebarangkalian bahawa salah satu model itu benar.
Pemadanan menghapuskan perbezaan skala ralat keseluruhan yang tidak berkaitan antara kedua-dua model hanya setakat perbezaan pada setiap titik asal menangkapnya. Ia tidak menjadikan siri kerugian bebas, tidak menghapuskan ketidakpastian anggaran parameter secara automatik dan tidak membetulkan carian merentasi banyak sasaran serta spesifikasi. Perkara itu perlu ditangani dalam reka bentuk dan pengiraan ketidakpastian.
Contoh satu langkah memisahkan jurang sampel daripada bukti
Katakan terdapat 100 ramalan hipotetikal satu langkah yang dipadankan. Kerugian kuasa dua purata model A ialah 0.26 dan model B ialah 0.23, dalam unit mata peratusan kuasa dua. Maka perbezaan puratanya ialah d̄ = 0.26 − 0.23 = 0.03, yang memihak kepada B dalam sampel. Demi contoh yang mudah, anggap anggaran varians jangka panjang dₜ ialah 0.04 dan tiada kovarians bersiri antara titik asal.
Ralat piawai anggaran bagi perbezaan purata ialah √(0.04 / 100) = 0.02. Statistik yang belum dilaraskan ialah 0.03 / 0.02 = 1.50. Bagi ufuk h = 1 dan T = 100, faktor sampel kecil Harvey–Leybourne–Newbold ialah √[(T + 1 − 2h + h(h − 1)/T) / T] = √0.99 ≈ 0.995. Selepas didarab, statistik terlaras kira-kira 1.49; dengan taburan rujukan t₉₉ anggaran, nilai-p dua hala kira-kira 0.14.
B mempunyai ralat kuasa dua purata yang diperhatikan lebih rendah, tetapi contoh ini tidak memberikan bukti kukuh untuk menolak ketepatan jangkaan yang sama pada ambang keertian lazim. Gagal menolak tidak membuktikan kedua-dua model sama tepat; penolakan juga tetap bergantung pada skor, titik asal dan andaian yang dipilih. Nilai varians serta semua kerugian di sini ialah input hipotetikal untuk mengajar pengiraan, bukan hasil empirikal.
Punca kuasa dua bagi kedua-dua kerugian kuasa dua purata itu memberikan root mean squared error (RMSE) kira-kira 0.510 dan 0.480 mata peratusan, dengan jurang deskriptif 0.030. Namun, statistik DM menguji perbezaan kerugian kuasa dua berpasangan; ia bukan ujian-t terhadap perbezaan antara kedua-dua punca kuasa dua tersebut.
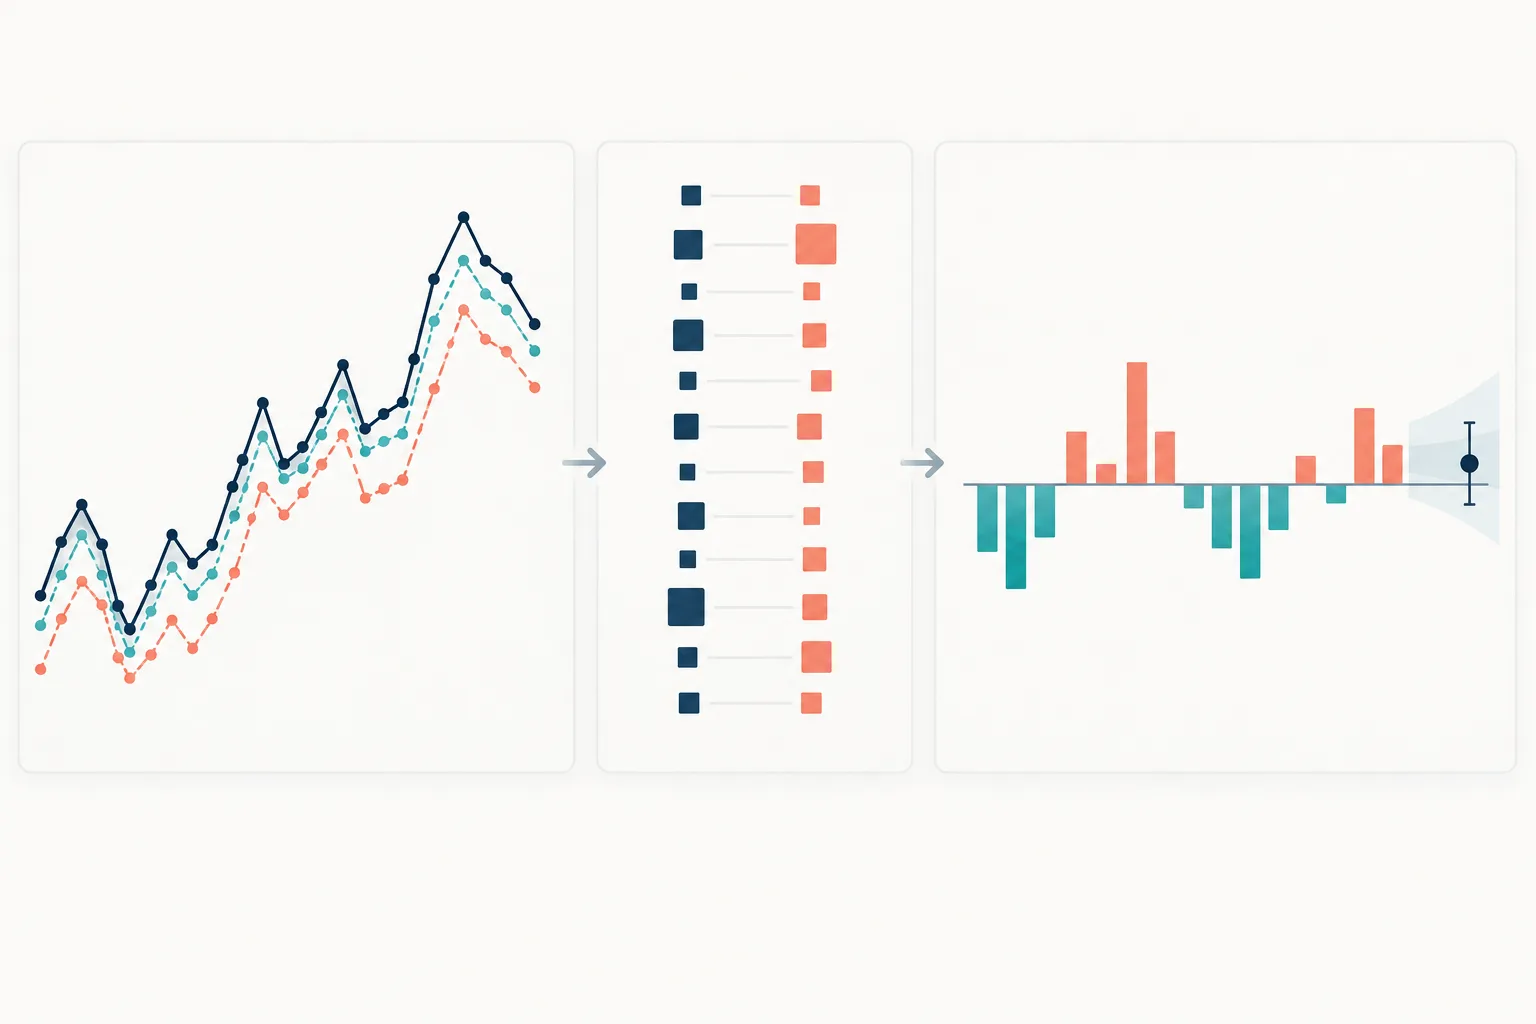
Ufuk bertindih menjadikan perbezaan kerugian saling bergantung
Jika ramalan lima hari ke hadapan dikeluarkan setiap hari, dua ramalan bersebelahan berkongsi empat daripada lima hari sasaran. Ralat, kerugian dan perbezaan kerugian boleh bergerak bersama. Menganggap 100 titik asal ramalan harian sebagai 100 perbandingan bebas boleh mengecilkan ketidakpastian dan menjadikan statistik kelihatan terlalu besar.
Varians jangka panjang mengambil kira kovarians bersiri dalam dₜ. Anggaran konsisten heteroskedastisiti dan autokorelasi (HAC) yang lazim mempunyai bentuk
Ŝd = γ̂₀ + 2 Σₖ₌₁ᵐ wₖ γ̂ₖ
dengan γ̂ₖ ialah autokovarians sampel d pada lat k, wₖ ialah pemberat kernel dan m ialah lebar jalur yang dipilih. Newey dan West (1987) memberikan penganggar kovarians HAC yang semidefinit positif. Bagi ralat ramalan h-langkah ideal di bawah andaian berkaitan, pertindihan sering menyebabkan pergantungan sekurang-kurangnya hingga lat h − 1; rangka DM asal membincangkan anggaran terpotong untuk kes itu. Data sebenar mungkin mempunyai pergantungan lebih panjang akibat sasaran yang berterusan, anggaran bergulir atau pembentukan strategi, maka h − 1 bukan peraturan lebar jalur sejagat.
Nyatakan ufuk, kernel, lebar jalur dan sebarang pelarasan sampel kecil. Tunjukkan sama ada kesimpulan berubah di bawah tetapan pergantungan yang munasabah, bukannya memilih lebar jalur kerana menghasilkan nilai-p pilihan. Jika titik asal penilaian dijarakkan supaya tidak bertindih, nyatakan hal itu dan terangkan maklumat atau saiz sampel yang dikorbankan. Ketidakpastian yang mengambil kira pergantungan ialah sebahagian daripada ujian, bukannya pilihan paparan.
Model bersarang dan kemahiran ramalan yang berubah memerlukan persoalan berbeza
Perbandingan DM biasa paling mudah ditafsirkan bagi ramalan yang tidak bersarang di bawah hipotesis nol ketepatan yang sama. Jika model lebih besar mengandungi penanda aras lebih kecil, pekali tambahan yang dianggarkan boleh menambah hingar ramalan walaupun nilai sebenarnya sifar. Di bawah hipotesis itu, perbezaan min kuasa dua ralat ramalan boleh mempunyai taburan nol bukan piawai. Untuk perbandingan MSPE luar sampel bagi model bersarang, kaedah seperti pelarasan Clark–West mengambil kira kesan hingar anggaran ini; kaedah itu bukan pengganti umum bagi DM dalam setiap reka bentuk model. Lihat Clark dan West (2007).
Hipotesis nol DM biasa merujuk kepada kerugian purata tanpa syarat sepanjang sampel penilaian. Ia boleh menyembunyikan perubahan mengikut masa: A mungkin lebih baik dalam tempoh tenang dan B semasa turun naik tinggi, sedangkan min keseluruhan hampir sama. Jika persoalannya ialah sama ada ketepatan relatif bergantung pada maklumat yang diketahui pada tarikh ramalan, ujian keupayaan ramalan bersyarat menggabungkan perbezaan kerugian dengan instrumen yang ditentukan lebih awal. Giacomini dan White (2006) membangunkan rangka kerja ini. Andaian dan reka bentuk tetingkap penilaian tetap penting; menambah penunjuk sewenang-wenangnya selepas melihat keputusan bukan jalan pintas yang sah.
Pilihan ujian patut mengikut struktur perbandingan: ramalan bebas, model bersarang, keupayaan bersyarat yang berubah, atau keluarga yang dipilih daripada banyak calon ialah kes yang berbeza. Bagi kes terakhir, panduan White Reality Check dan Hansen SPA menerangkan pembetulan seluruh keluarga selepas mencari banyak peraturan dagangan.
Kerugian ramalan yang lebih rendah tidak membuktikan strategi yang menguntungkan
Ramalan mungkin lebih tepat dari segi statistik tetapi tidak meningkatkan hasil dagangan bersih. Strategi perlu menukar ramalan kepada kedudukan, menentukan masa dagangan dan menanggung spread, komisen, gelinciran, impak pasaran, pembiayaan, pinjaman dan had risiko. Peningkatan kecil dalam ralat kuasa dua purata pulangan mungkin tidak berguna untuk keputusan; model yang ralat puratanya sedikit lebih tinggi pula mungkin lebih baik mengenal pasti peristiwa ekor yang penting bagi peraturan tertentu.
Asingkan penilaian ramalan daripada penilaian portfolio. Mula-mula uji ramalan terhadap sasaran dan kerugian yang sepadan dengan tugas ramalan yang dinyatakan. Kemudian nilai peraturan dagangan yang ditakrif sepenuhnya menggunakan data yang tidak digunakan untuk memilih ramalan, dengan andaian pelaksanaan dan pembiayaan yang realistik. Nilai-p ujian ramalan bukan pulangan backtest, nisbah Sharpe atau kebarangkalian keuntungan masa depan.
Percubaan berulang terhadap model, sasaran, ufuk, fungsi kerugian dan tetingkap sampel menimbulkan bias pemilihan walaupun setiap pengiraan DM individu adalah betul. Rekodkan keseluruhan carian dan gunakan kaedah seluruh keluarga jika persoalannya sama ada mana-mana calon bertahan daripada carian itu. Panduan block bootstrap membincangkan ketidakpastian yang mengekalkan pergantungan bagi statistik yang ditentukan lebih awal; kaedah itu sendiri tidak membetulkan carian model yang tidak didokumenkan.
Laporkan butiran yang mencukupi supaya penyelidik lain boleh mengulang analisis
Namakan kedua-dua model ramalan, hubungan penanda aras, sasaran, ufuk, jadual titik asal ramalan, tarikh penilaian, set maklumat, vintaj data dan peraturan sampel bersama. Takrifkan fungsi kerugian secara matematik dan nyatakan sama ada dₜ positif memihak kepada A atau B. Laporkan n, kerugian purata setiap model, d̄, penganggar varians jangka panjang, kernel serta lebar jalur HAC, pelarasan sampel kecil, taburan rujukan, arah ujian dan nilai-p.
Nyatakan juga sama ada model bersarang, cara parameter dianggarkan, sama ada perbandingan ditetapkan sebelum atau selepas keputusan diteliti, serta varian lain yang telah dicuba. Jika sampel digunakan untuk pemilihan model, labelkan ujian itu sebagai sebahagian daripada proses tersebut, bukannya bukti luar sampel yang belum disentuh. Laporan yang jelas membolehkan pembaca melihat perkara yang dibandingkan dan masalah ketidakpastian atau pemilihan yang masih belum ditangani.
Soalan lazim
Q1Adakah ujian Diebold–Mariano memerlukan ralat ramalan bertaburan normal?
Tidak. Rangka kerja ini boleh mengendalikan ralat ramalan bukan normal. Ujian masih memerlukan anggaran varians perbezaan kerugian yang sesuai dan syarat keteraturan bagi taburan rujukan.
Q2Bolehkah saya membandingkan dua model yang meramal ufuk berbeza?
Bukan sebagai perbandingan ketepatan yang setara. Selaraskan sasaran dan ufuk terlebih dahulu; jika tidak, setiap model menjawab persoalan ramalan yang berbeza.
Q3Adakah keputusan DM yang signifikan cukup untuk memilih model dagangan?
Tidak. Ia merupakan bukti tentang kerugian ramalan jangkaan dalam perbandingan tertentu. Anda masih perlu mengambil kira carian model, peraturan keputusan, kos pelaksanaan, pembiayaan dan prestasi strategi luar sampel. Penyelidikan utama - Diebold dan Mariano, “Comparing Predictive Accuracy” (1995) - Harvey, Leybourne dan Newbold, “Testing the Equality of Prediction Mean Squared Errors” (1997)00719-4) - Giacomini dan White, “Tests of Conditional Predictive Ability” (2006) - Clark dan West, “Approximately Normal Tests for Equal Predictive Accuracy in Nested Models” (2007) - Newey dan West, “A Simple, Positive Semi-Definite, Heteroskedasticity and Autocorrelation Consistent Covariance Matrix” (1987)
Sumber dan bacaan lanjut
Laporkan masalah
Kami akan menyediakan e-mel dengan pautan artikel ini. Mark menerima laporan hanya selepas anda menghantarnya
Semakan pantas
Sudah membaca panduan? Uji diri dengan 3 soalan
Soalan 01
Dengan dₜ = L(eA,ₜ) − L(eB,ₜ), model manakah yang disokong oleh purata sampel positif?
Pilih jawapan untuk melihat penjelasan