

Cross-validation purged ed embargo: evitare la fuga di etichette nei modelli di trading
Scopri come purging ed embargo gestiscono etichette forward sovrapposte nelle serie finanziarie e come differiscono da walk-forward e CPCV.
In questa guidaPerché il K-fold casuale può essere fuorviante in finanza
Breve sintesi
La cross-validation purged rimuove dal training le osservazioni i cui intervalli effettivi delle etichette si sovrappongono a quelli del test. L’embargo è un margine distinto, definito prima di ammettere nel training osservazioni successive al blocco di test. Nessuna delle due regole equivale da sola a una simulazione cronologica dell’impiego futuro.
Perché il K-fold casuale può essere fuorviante in finanza
K-fold divide le osservazioni in gruppi e li usa a turno per il test. Nelle serie finanziarie, una suddivisione casuale può distribuire tra training e test osservazioni dipendenti o etichette forward con periodi di risultato sovrapposti. Il training finisce così per contenere informazioni collegate ai risultati di test, facendo apparire la prestazione migliore di quanto sarebbe su dati davvero nuovi.
Questo non rende sempre invalido ogni uso di K-fold. Può essere adatto quando le osservazioni sono sufficientemente indipendenti e le etichette non si sovrappongono. Occorre esaminare come sono costruite le variabili e le etichette e quale scenario futuro si vuole stimare. López de Prado tratta questi problemi e il purging nel capitolo 7 di *Advances in Financial Machine Learning*.
Definire le informazioni disponibili e l’intervallo dell’etichetta
Per ogni campione, t è l’istante della decisione. Registra le informazioni realmente disponibili allora, la finestra passata usata per le variabili e quando si risolve l’obiettivo. Qui un’etichetta del rendimento delle cinque sedute successive copre l’intervallo (t, t+5]; t1 è il suo effettivo termine.
Due previsioni possono condividere dati storici delle variabili senza creare automaticamente leakage, se quei dati erano già noti al momento di entrambe le decisioni. C’è invece leakage se una variabile incorpora dati futuri, viene ricalcolata a posteriori o ha un timestamp errato. Le variabili devono riflettere solo l’informazione disponibile al momento di ciascuna previsione.
Rimuovere dal training gli intervalli di etichetta sovrapposti
Il purging elimina un campione di training quando il suo intervallo effettivo di risultato si sovrappone a quello di un campione di test. Controlla gli effettivi timestamp di inizio e fine. Con etichette di eventi di durata variabile, usa i limiti reali, non un numero fisso di righe scelto per comodità.
Il purging non rende automaticamente cronologica una suddivisione. Un purged K-fold può ancora addestrarsi su osservazioni successive al blocco di test. Questo può rispondere a una domanda di robustezza, ma non equivale ad addestrare solo sul passato e poi testare sul futuro. La direzione temporale va definita separatamente.
Stabilire l’embargo come margine distinto
L’embargo è un periodo specificato dopo un blocco di test, prima che osservazioni successive possano entrare nel training nelle suddivisioni che usano dati post-test. Può ridurre dipendenze residue dovute alla costruzione di eventi o variabili. Non sostituisce il controllo degli intervalli effettivi e non ha una durata o percentuale universale.
Motiva la lunghezza in base a frequenza di campionamento, orizzonte dell’etichetta, finestre delle variabili e dipendenza osservata. Definisci e documenta la regola prima del confronto dei risultati. In un test strettamente orientato in avanti non ci sono osservazioni successive al test a cui applicare questo caso di embargo.
Esempio giornaliero con orizzonte di cinque sedute
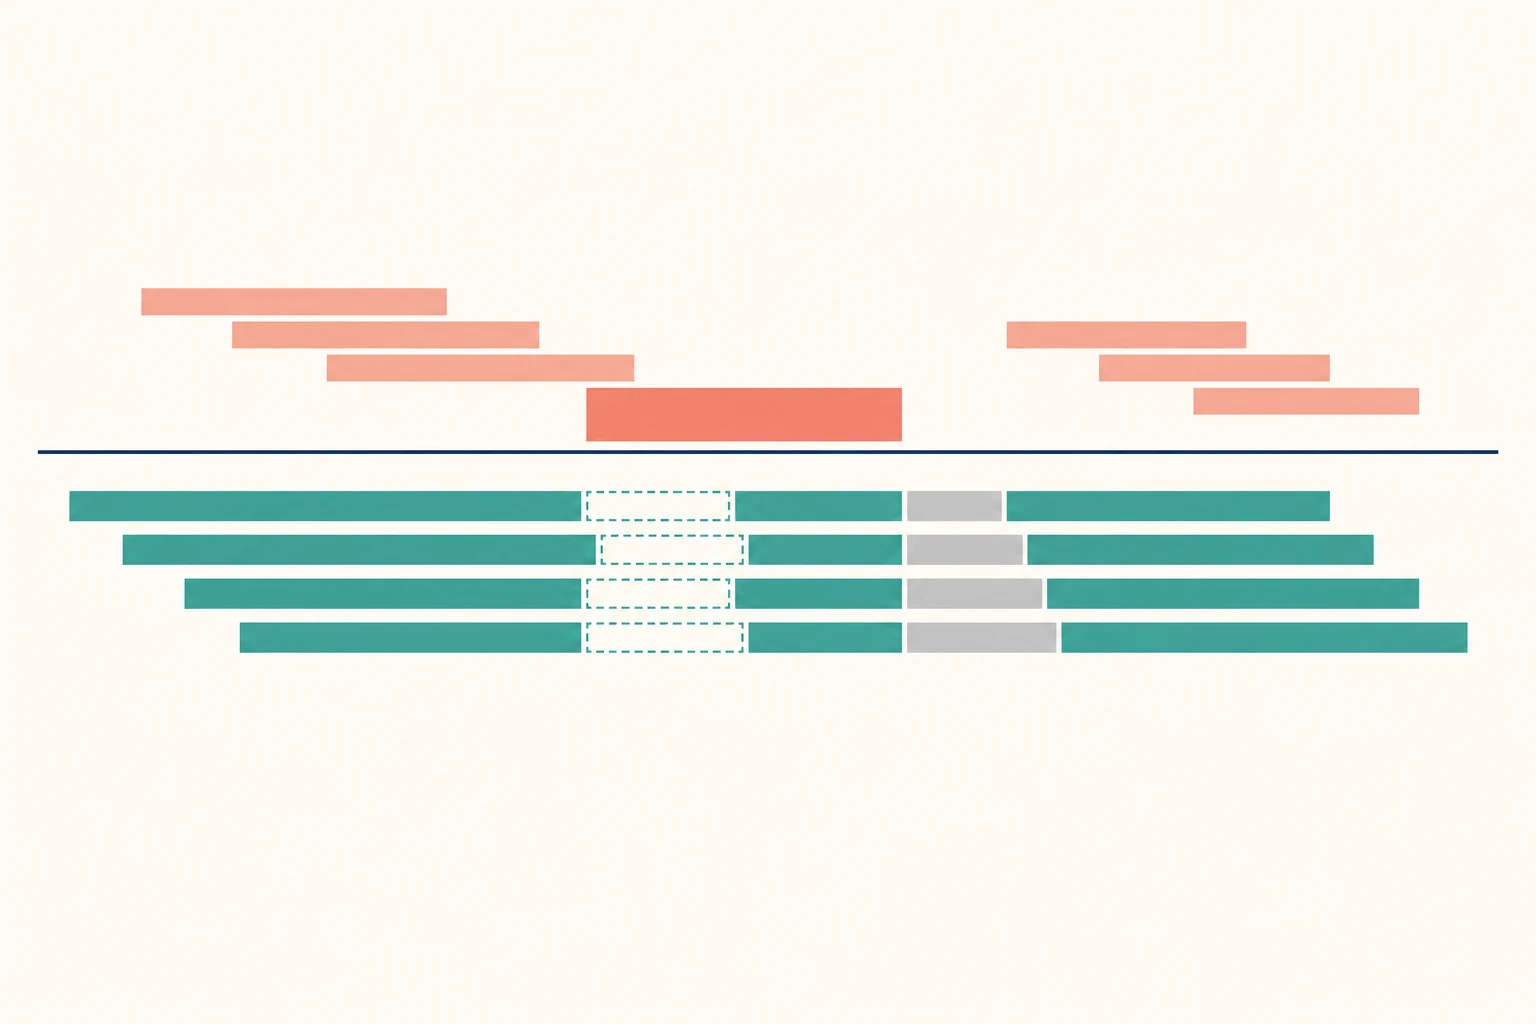
Supponiamo decisioni giornaliere e un’etichetta di rendimento sulle cinque sedute successive, (t, t+5]. Un blocco di test con date decisionali dall’11 al 15 ha etichette che arrivano fino al giorno 20. I giorni sono sedute e tutti gli intervalli seguono la stessa convenzione.
L’etichetta di training (7,12] si sovrappone al test perché condivide giorni con l’etichetta della decisione del giorno 11. Si sovrappone anche (16,21], dato che l’etichetta di test del giorno 15 arriva fino al giorno 20. Entrambi i campioni di training vanno rimossi con il purging. Anche un’etichetta successiva non sovrapposta può essere esclusa da una zona di embargo definita separatamente. L’esempio non fissa una distanza universale.
Distinguere K-fold, walk-forward, gap, purged K-fold e CPCV
Il K-fold casuale può mescolare periodi diversi. La validazione walk-forward o rolling-origin si addestra sui dati precedenti e testa su un blocco successivo, rappresentando più direttamente una sequenza storica di impiego. La documentazione ufficiale di TimeSeriesSplit di scikit-learn descrive suddivisioni cronologiche e richiede campioni equidistanti per confrontare durate di test equivalenti.
TimeSeriesSplit(gap=...) esclude un numero fisso di righe prima del test. gap non individua intervalli variabili degli eventi: il numero di righe rappresenta una distanza temporale interpretabile solo se il campionamento è adeguato, di norma regolare. Purged K-fold e Combinatorial Purged Cross-Validation (CPCV) creano più combinazioni o percorsi di test, ma possono usare per il training dati successivi al test. Non rispondono quindi automaticamente alla stessa domanda di una simulazione walk-forward storica.
Il capitolo 12 di López de Prado sul backtesting approfondisce walk-forward e CPCV.
Restano altre possibili fonti di leakage
Il purging corretto non corregge variabili con lookahead o timestamp errati, survivorship bias o dati rivisti in seguito. Anche standardizzare, imputare o selezionare variabili globalmente prima della suddivisione può trasferire informazioni di test al training. Adatta trasformazioni e selezione dentro ogni fold di training.
Provare molte varianti aumenta inoltre il rischio di scegliere per caso un vincitore del backtest. Bailey e coautori analizzano i tentativi ripetuti nel loro studio sulla probabilità di overfitting del backtest. Usa una validazione annidata che rispetti il tempo per selezionare i modelli e conserva un periodo cronologico finale intatto. Modella anche costi ed esecuzioni realistici. Nessuna cross-validation garantisce risultati futuri.
Comunicare risultati e incertezza
Riporta lunghezza del campione, frequenza, orizzonti delle etichette, disponibilità delle variabili, regola di suddivisione, campioni rimossi e motivazione dell’embargo. Specifica se il training includeva righe successive al test e quale domanda si voleva valutare. Un solo punteggio aggregato può nascondere differenze tra periodi o percorsi di test.
Confronta i modelli con gli stessi confini temporali, etichette, ipotesi sui costi e regole di selezione. Considera incertezza e numero di varianti provate: differenze minime su campioni brevi sono poco solide. Approfondisci con compromesso bias-varianza e overfitting, test multipli e false discovery rate e Sharpe ratio con autocorrelazione seriale.
Fissare la validazione prima del backtest
Per ogni campione registra l’istante t, i dati disponibili, la finestra delle variabili e i limiti reali dell’etichetta fino a t1. Scegli una suddivisione coerente con lo scenario da valutare; quindi rimuovi dal training le etichette che intersecano gli intervalli di test e definisci separatamente un embargo se necessario.
Controlla il preprocessing dentro ogni fold, documenta prove e costi, e mantieni intatto un holdout cronologico finale. Queste precauzioni rendono l’analisi verificabile, ma i dati passati non garantiscono quelli futuri. Questa guida spiega la meccanica della validazione e non raccomanda investimenti o strategie.
Domande frequenti
Q1Il K-fold casuale è sempre sbagliato per le serie finanziarie?
No. Può essere adatto a una domanda con osservazioni sufficientemente indipendenti e senza etichette sovrapposte. In presenza di dipendenza temporale o etichette forward, la suddivisione deve rispettare tale struttura.
Q2L’embargo rende superfluo il purging?
No. Il purging verifica le sovrapposizioni reali degli intervalli delle etichette. L’embargo aggiunge un margine per alcune suddivisioni con training successivo al test. Entrambe le regole richiedono una motivazione documentata.
Q3CPCV sostituisce i test walk-forward?
Non automaticamente. CPCV produce combinazioni e percorsi di test, ma può addestrarsi su dati successivi a un blocco di test. Una simulazione cronologica di impiego resta una domanda diversa.
Fonti e approfondimenti
Segnala un problema
Prepareremo un’e-mail con il link a questo articolo. Mark riceverà la segnalazione solo dopo l’invio
Controllo rapido
Hai finito la guida? Verifica ciò che hai capito con 3 domande
Domanda 01
Quale osservazione va rimossa con il purging?
Scegli una risposta per vedere la spiegazione
Glossario delle opzioni
The relationship between systematic prediction error from model mismatch and instability caused by sensitivity to the training sample.
Leggi la guida completaFamily-wise error rateThe probability of falsely rejecting at least one true null hypothesis within a predefined family of tests.
Leggi la guida completaAssignmentThe process that requires an option writer to fulfill the contract after an exercise notice is allocated; it can create or remove an underlying position.
Leggi la guida completa