

Regressione MIDAS: dati a frequenze miste e previsione della volatilità
Scopri come la regressione MIDAS combina dati finanziari giornalieri e settimanali con pesi parsimoniosi sui ritardi, come costruire una previsione di volatilità e dove i modelli a frequenze miste possono trarre in inganno.
In questa guidaMIDAS affronta la differenza tra frequenze di osservazione
Breve sintesi
MIDAS (mixed data sampling, campionamento di dati misti) collega osservazioni registrate con frequenze diverse senza imporre prima a tutte le serie un calendario unico. Un piccolo numero di parametri stimati definisce i pesi della storia osservata a frequenza più alta e può aiutare a prevedere una variabile finanziaria a frequenza più bassa. I pesi descrivono un profilo predittivo nel modello scelto; non dimostrano causalità né un vantaggio di trading.
MIDAS affronta la differenza tra frequenze di osservazione
I dati finanziari ed economici non arrivano secondo lo stesso orologio. Un obiettivo di volatilità può essere misurato ogni settimana, mentre i possibili predittori sono rendimenti giornalieri o misure realizzate intraday. Una serie macroeconomica può essere trimestrale, mentre il prezzo di un'attività viene osservato a ogni sessione di borsa. Una regressione ordinaria si aspetta una riga per osservazione con risultato e predittori, quindi prima di stimare il modello occorre decidere come trattare calendari diversi.
Un'opzione consiste nell'aggregare gli input giornalieri in una media o somma settimanale. È semplice, ma impone un peso specifico a ogni giorno e può cancellare il momento della settimana in cui si è verificato un movimento. Un'altra opzione è ripetere un valore trimestrale su righe giornaliere o interpolarlo. La ripetizione può far sembrare un dato lento una serie di nuove osservazioni; l'interpolazione può creare un percorso regolare mai osservato. Nessuna delle due operazioni genera nuova informazione.
MIDAS offre un modo diretto di collegare le frequenze. Mantiene l'obiettivo alla sua frequenza naturale più bassa e include ritardi strutturati della serie a frequenza più alta. Il nome indica mixed data sampling, non un singolo modello di volatilità. Le regressioni MIDAS vengono usate per prevedere la volatilità e in altre situazioni in cui i predittori hanno una frequenza più fine dell'esito. La domanda centrale è quanta storia recente ad alta frequenza usare e come vincolarne i pesi.
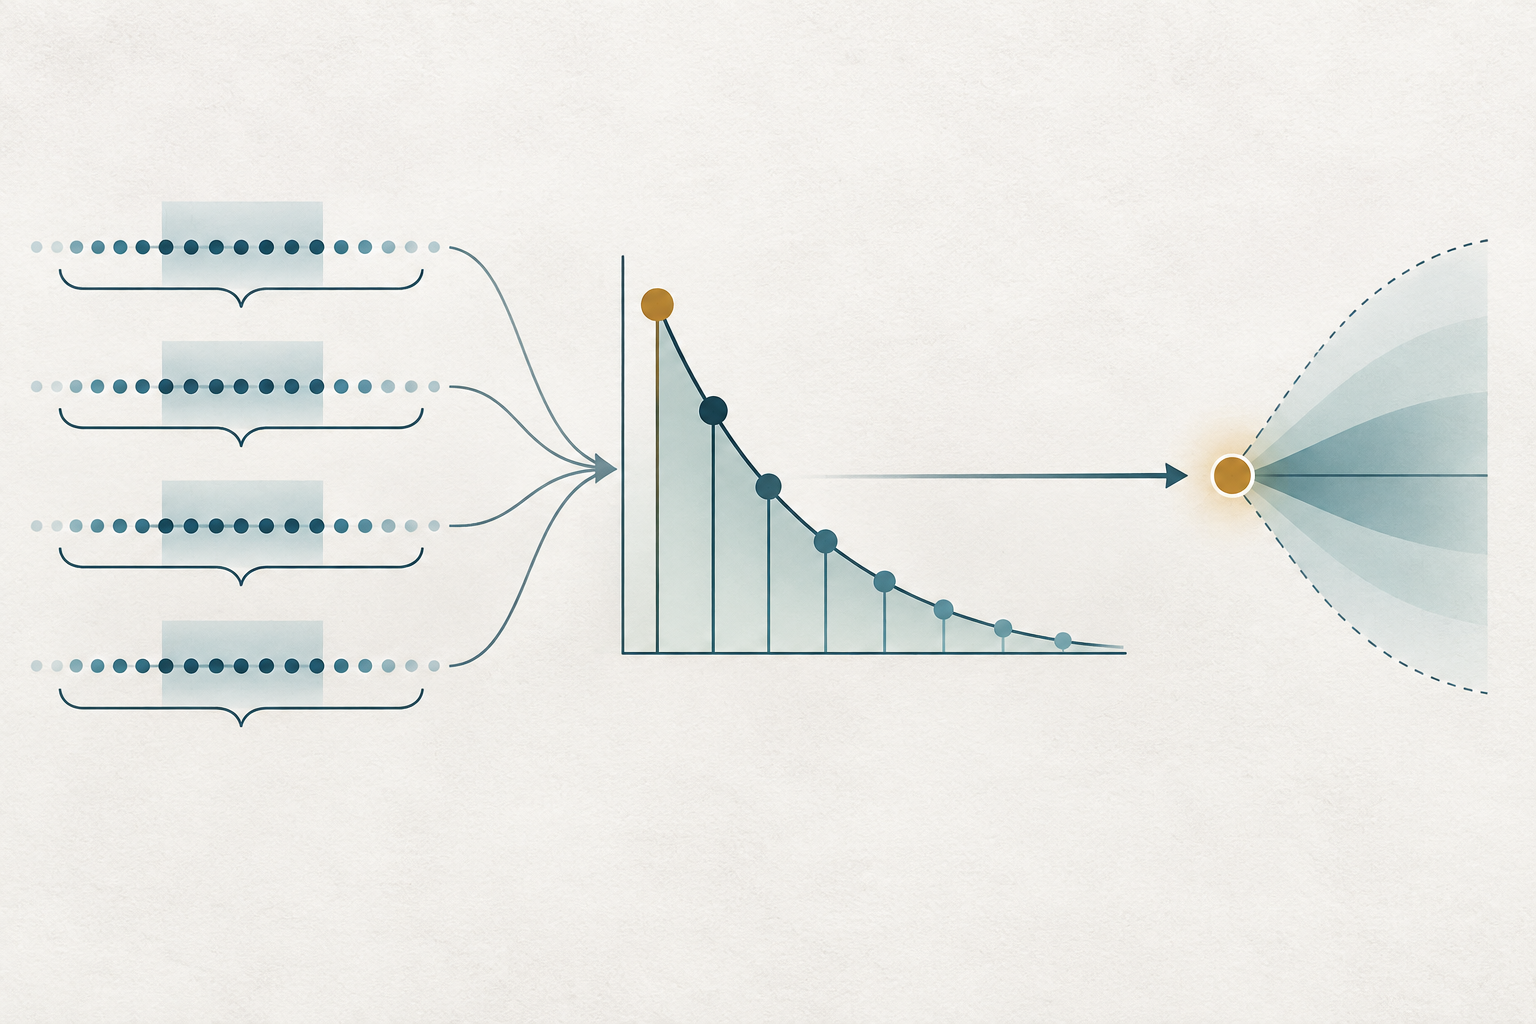
Un ritardo ponderato sintetizza molte osservazioni in un predittore compatto
Sia \(y_{t+1}\) un obiettivo a frequenza più bassa, come la varianza realizzata della settimana successiva, osservata dopo la sua conclusione. Sia \(x_{t-j}\) un predittore giornaliero osservato \(j\) sessioni di borsa prima dell'origine della previsione, alla fine della settimana \(t\). Una regressione MIDAS semplice è \(y_{t+1}=a+b\sum_{j=1}^{K}w_j(\theta)x_{t-j}+u_{t+1}\), dove \(K\) è il numero di ritardi giornalieri, \(w_j(\theta)\) è un peso governato da pochi parametri e \(u_{t+1}\) è l'errore di previsione.
I pesi sono spesso normalizzati in modo che \(\sum_{j=1}^{K}w_j(\theta)=1\). Così la somma si può leggere come storia ponderata, mentre \(b\) determina l'intensità del suo legame con l'obiettivo. La normalizzazione non implica che le osservazioni giornaliere siano indipendenti o ugualmente informative. È una parametrizzazione pratica del profilo dei ritardi.
Si può scegliere \(x\) come rendimenti giornalieri al quadrato, rendimenti assoluti, misura di varianza realizzata costruita con rendimenti intraday o un'altra variabile disponibile all'origine della previsione. \(y\) può essere una varianza settimanale futura, una pubblicazione macroeconomica mensile o un altro obiettivo a frequenza più bassa. La definizione dell'obiettivo determina il significato dei coefficienti. Un modello per un'approssimazione della varianza realizzata non è automaticamente un modello della varianza istantanea latente, della varianza implicita nelle opzioni o del rendimento di prezzo.
MIDAS è un quadro di regressione, non uno stimatore universale. La risposta può essere modellata in livelli, logaritmi o con una funzione di collegamento; la stima dipende dalla famiglia di pesi e dalle ipotesi sugli errori scelte. Una regressione lineare di un'approssimazione di varianza non negativa può produrre valori stimati negativi, a meno che si impongano vincoli o si trasformi l'obiettivo. La comodità del modello non elimina la necessità di controllare supporto e unità dell'obiettivo.
La funzione dei pesi scambia flessibilità con stabilità
Una regressione a ritardi distribuiti senza vincoli stima un coefficiente separato per ciascuno dei \(K\) input giornalieri. Se \(K\) è grande rispetto al numero di osservazioni settimanali dell'obiettivo, le stime possono essere rumorose e fortemente correlate. MIDAS definisce invece i coefficienti dei ritardi tramite una funzione a bassa dimensionalità. Un profilo illustrativo di Almon esponenziale è \(w_j(\theta)=\frac{\exp(\theta_1j+\theta_2j^2)}{\sum_{\ell=1}^{K}\exp(\theta_1\ell+\theta_2\ell^2)}\). È comune anche un profilo polinomiale Beta normalizzato.
Questi profili possono assegnare più peso alle sessioni recenti, farlo diminuire gradualmente o dare relativamente più peso a una parte centrale della finestra. I parametri descrivono la curva regolare scelta, non l'importanza incondizionata di ogni giorno. Se i dati indicano una risposta breve ma la funzione scelta impone una lunga coda regolare, i coefficienti stimati ereditano quel vincolo. Al contrario, stimare molti coefficienti giornalieri liberi può adattarsi al rumore anziché a dinamiche stabili.
I vincoli sui pesi sono ipotesi del modello. Pesi non negativi normalizzati possono rendere interpretabile una previsione di varianza come media ponderata, ma escludono effetti di ritardo positivi e negativi che si compensano. Un profilo flessibile può consentire un picco o una pendenza variabile, ma troppi parametri di forma potrebbero essere debolmente identificati. Confronta poche forme difendibili, indica quali ritardi erano disponibili e verifica se la previsione cambia materialmente al variare della famiglia dei pesi.
Non esiste un \(K\) universale. Una finestra più lunga può cogliere informazione persistente, ma aggiunge parametri o impone una forma più estesa; una finestra breve può perdere dinamiche lente. Scegli il numero di ritardi usando informazioni disponibili nel periodo di stima e convalidalo senza usare l'obiettivo futuro di valutazione. Un buon adattamento in campione da solo non dimostra che la finestra colga un segnale ripetibile.
Allinea l'origine della previsione al momento in cui ogni valore era noto
Le etichette di frequenza non bastano a definire un disegno di previsione valido. Supponiamo che l'obiettivo sia la varianza della prossima settimana di cinque sessioni e che la previsione venga emessa dopo la chiusura di venerdì. I predittori possono includere osservazioni giornaliere concluse entro venerdì, ma non una statistica di varianza realizzata calcolata sui rendimenti della settimana futura. Una statistica settimanale o mensile può essere pubblicata dopo il periodo che descrive. Un backtest deve usare il dato effettivamente disponibile allora, non un valore rivisto o pubblicato successivamente.
Prima della stima, prepara una tabella dell'origine della previsione: quando viene emessa, l'ultimo timestamp ammesso per ogni predittore, il periodo obiettivo e quando il valore obiettivo diventa osservabile. Per i rendimenti finanziari, specifica se il rendimento da chiusura a chiusura include un intervallo notturno, quale sessione definisce un giorno e come festività o barre mancanti modificano il conteggio dei ritardi giornalieri. Cinque sessioni di borsa e sette giorni di calendario sono intervalli diversi.
I calendari delle pubblicazioni creano bordi irregolari. In una certa data un predittore può avere un valore giornaliero aggiornato mentre una serie mensile non è ancora stata pubblicata. Riportare in avanti l'ultimo valore mensile disponibile può essere valido se il modello lo tratta come informazione vecchia ma nota all'origine. Non è valido riempire un dato non ancora pubblicato usando una pubblicazione successiva. Le revisioni storiche possono creare un problema più sottile di look-ahead: una banca dati attuale può contenere una serie macro rivista che un previsore in tempo reale non avrebbe potuto conoscere.
I mercati asincroni aggiungono un problema di allineamento. Una chiusura giornaliera azionaria e una chiusura giornaliera crypto possono riferirsi a intervalli UTC diversi; una stima intraday della volatilità può includere barre che terminano dopo l'ora della previsione. Conversione dei fusi orari, ora legale, chiusure dei mercati e costruzione delle barre fanno parte dell'insieme informativo. Descrivi come vengono gestite, anziché presumere che righe con la stessa data condividano la stessa ora limite delle informazioni.
Un esempio ipotetico trasforma gli input giornalieri in una previsione settimanale
Supponiamo che l'obiettivo sia la varianza realizzata della settimana successiva e che la previsione venga emessa alla chiusura di venerdì. Il modello usa cinque misure giornaliere di varianza realizzata della settimana appena conclusa. I pesi stimati, dalla sessione più recente alla più vecchia, sono \(0{,}40,0{,}25,0{,}16,0{,}11,0{,}08\), la cui somma è uno. I corrispondenti input giornalieri, in unità di rendimento al quadrato, sono \(0{,}0004,0{,}0001,0{,}0009,0{,}0004,0{,}0001\).
La storia ponderata vale \(0{,}40(0{,}0004)+0{,}25(0{,}0001)+0{,}16(0{,}0009)+0{,}11(0{,}0004)+0{,}08(0{,}0001)=0{,}000381\). Per questo ipotetico modello stimato, supponiamo che l'intercetta sia \(a=0{,}00012\) e la pendenza \(b=0{,}80\). La previsione di varianza per la settimana successiva è \(0{,}00012+0{,}80(0{,}000381)=0{,}0004248\). Se è utile un riepilogo in deviazione standard, la radice quadrata è circa \(0{,}02061\), cioè \(2{,}06\,\%\) sulla settimana obiettivo secondo la definizione scelta.
Il calcolo illustra il passaggio da predittori giornalieri a un obiettivo settimanale futuro; valori e coefficienti stimati sono inventati. Non significa che uno dei giorni elencati abbia causato la varianza della settimana successiva né che il prezzo dell'attività salirà o scenderà. Il peso assegnato alla sessione recente indica come il modello predittivo specificato combina gli input osservati, condizionatamente al campione e ai vincoli. Non è una stima di risposta causale.
L'esempio chiarisce anche una questione di unità. Varianza realizzata giornaliera e settimanale sono entrambe varianze di rendimenti, ma si riferiscono a intervalli di accumulazione diversi. Pendenza \(b\), intercetta e costruzione dell'obiettivo sono stimate per quella precisa convenzione; non si possono rinominare semplicemente gli input giornalieri come varianza settimanale. Se l'obiettivo fosse il logaritmo della varianza settimanale, la previsione sarebbe in unità logaritmiche e in generale esponenziare la media condizionale del log non equivale alla media condizionale della varianza. La ritrasformazione ai livelli richiede un obiettivo di previsione esplicito e, se opportuno, una correzione.
La stima dipende dall'obiettivo e dal vincolo sui ritardi
Con un vettore dei pesi fissato, la regressione è lineare in intercetta e pendenza. Quando i pesi dipendono da parametri non lineari sconosciuti \(\theta\), si usa spesso la minima distanza quadratica non lineare o un metodo correlato basato sulla verosimiglianza. La stima può cercare insieme parametri della forma dei pesi e coefficienti, oppure profilare i coefficienti lineari per ogni forma candidata. Valori iniziali, limiti dei parametri, criteri di convergenza e ottimi locali possono essere importanti; non nascondere mancate convergenze o soluzioni al bordo.
Se \(y\) è una misura di volatilità non negativa, una specificazione lineare ordinaria può produrre valori stimati negativi, soprattutto fuori campione. Le opzioni includono vincoli che mantengono non negativo il livello previsto, una funzione di collegamento positiva o la modellazione del logaritmo dell'obiettivo. Queste scelte cambiano estimando e interpretazione della previsione. In un modello con obiettivo logaritmico, prevedere la media condizionale del log della varianza non fornisce automaticamente la media condizionale della varianza; contano la distribuzione degli errori e la ritrasformazione.
L'incertezza campionaria riflette anche il modo in cui è stato costruito l'obiettivo. La varianza realizzata settimanale calcolata da rendimenti intraday contiene errore di misura e può essere sensibile al rumore di microstruttura, all'intervallo di campionamento, ai salti e alle osservazioni mancanti. Se le finestre obiettivo settimanali si sovrappongono, gli errori di previsione di origini vicine condividono rendimenti sottostanti. Errori standard e confronti che presumono errori indipendenti possono quindi non essere adatti. Usa un'inferenza compatibile con orizzonte e struttura di dipendenza, e descrivi la procedura di misurazione dell'obiettivo.
Anche la stabilità dei parametri è importante. Il profilo dei pesi stimato fa la media del campione di stima; se la struttura di mercato cambia, la curva potrebbe non descrivere bene alcun regime attuale. Le stime a finestra espansiva e mobile rispondono a domande diverse: la prima usa più storia ma conserva dinamiche passate; la seconda si adatta più rapidamente, ma ha meno osservazioni e più rumore di stima. Definisci in anticipo la regola di aggiornamento e confrontala con una baseline fissa in una valutazione cronologica.
MIDAS è correlato a GARCH-MIDAS, ma non è identico
MIDAS indica un modo di combinare osservazioni campionate a frequenze diverse tramite ritardi ponderati. Una regressione MIDAS può prevedere direttamente un obiettivo futuro di volatilità realizzata usando misure giornaliere o intraday passate. Non deve specificare la ricorsione della varianza condizionale a un passo associata a un modello GARCH.
GARCH-MIDAS è una famiglia distinta che combina una componente di volatilità di lungo periodo a movimento lento, spesso guidata da variabili a frequenza più bassa, con una componente di varianza condizionale di breve periodo che evolve ricorsivamente. Le due componenti hanno parametrizzazioni e ipotesi proprie. In uno studio o software etichettato GARCH-MIDAS, leggi le equazioni precise: i pesi MIDAS possono governare la componente di lungo termine, mentre una ricorsione GARCH gestisce shock di breve periodo. L'etichetta da sola non rivela obiettivo, distinzione tra volatilità latente e realizzata o modo in cui si impone la positività.
I primi studi finanziari sulla volatilità MIDAS confrontano diversi predittori, frequenze e lunghezze dei ritardi in un quadro parsimonioso. Lavori metodologici successivi sviluppano proprietà di stima e test per modelli di regressione a frequenze miste, anche in confronto all'aggregazione temporale tradizionale. Questi contributi supportano la meccanica, non l'affermazione che MIDAS superi sempre GARCH o che i predittori ad alta frequenza migliorino sempre le previsioni. I risultati dipendono da attività, campione, obiettivo, predittore, orizzonte e disegno di valutazione.
Scegli il modello in base alla domanda. Se vuoi prevedere una misura futura di volatilità realizzata dalla storia giornaliera, una regressione MIDAS diretta può essere una candidata naturale. Se vuoi modellare ricorsivamente la varianza condizionale, confronta una specificazione GARCH adatta. Se combini pubblicazioni macro trimestrali con un obiettivo finanziario giornaliero, potresti dover gestire le versioni dei dati secondo le date di pubblicazione. Modelli con nomi simili possono rispondere a domande diverse; confronta origine di previsione, definizione dell'obiettivo e insieme informativo prima delle prestazioni.
Errore di misura e selezione possono prevalere sulla curva dei pesi
I dati ad alta frequenza aggiungono dettaglio temporale ma possono aumentare il rumore di misura. Barre molto brevi contengono rimbalzi bid-ask, discrezione dei prezzi, quotazioni obsolete, negoziazioni asincrone ed errori del flusso dati. Sommare rendimenti al quadrato a intervalli sempre più brevi non garantisce una stima migliore della varianza realizzata. Scegli griglia di campionamento e regole di pulizia prima di esaminare la prestazione previsionale, e verifica alternative plausibili.
Il limite informativo è dato dal numero di esiti a frequenza più bassa, non dall'apparente numero di righe giornaliere dei predittori. Dieci anni di input giornalieri associati a obiettivi settimanali forniscono comunque solo circa 500 periodi settimanali, prima di dati mancanti e campione di valutazione riservato. Una funzione di peso regolare usa meno coefficienti di ritardi giornalieri liberi, ma la sua forma può essere debolmente identificata con campioni brevi, predittori molto persistenti o ritardi candidati ridondanti.
Molte scelte analitiche creano bias di selezione: provare misure ad alta frequenza, lunghezze dei ritardi, profili dei pesi, trasformazioni, mercati, orizzonti e funzioni di perdita diversi, poi riportare soltanto il risultato migliore. L'adattamento in campione è particolarmente vulnerabile perché gli stessi obiettivi guidano la stima dei parametri e le scelte del modello. Conserva la famiglia di modelli provata, scegli una metrica principale e usa un holdout cronologico successivo o un confronto che consideri la selezione. Se confronti molte previsioni sulle stesse date, tieni conto di dipendenza e molteplicità anziché considerare ciascun risultato una conferma indipendente.
Una curva di pesi stimata non è una spiegazione causale. Gli input ad alta frequenza possono rappresentare notizie, liquidità o attività di mercato; fattori non osservati possono influire sia sui predittori sia sulla volatilità futura. L'utilità predittiva richiede una tempistica coerente e prove fuori campione. Un'interpretazione causale richiederebbe un disegno di identificazione distinto e ipotesi ulteriori rispetto all'equazione dei ritardi MIDAS.
Una previsione non determina una decisione di trading redditizia
Una previsione di volatilità può informare budget di rischio, dimensione di copertura o intervallo di scenari, ma non determina il segno del rendimento né la direzione di una posizione. Una deviazione standard settimanale prevista del \(2{,}06\,\%\) non è un movimento promesso, una perdita massima o una quotazione di volatilità implicita nelle opzioni. Descrive una misura di dispersione scelta sotto il modello e il campione; i rendimenti realizzati possono essere molto maggiori o minori.
Per uno studio strategico, definisci prima del test ora del segnale e dell'ordine, strumento, regola di esposizione e uscita. Ristima i parametri MIDAS storici solo con informazioni che sarebbero state disponibili a ogni origine di previsione. Valuta le previsioni contro una baseline predefinita e una perdita coerente con l'obiettivo; poi simula separatamente i rendimenti includendo spread, commissioni, funding, prestito, impatto di mercato e turnover. Una previsione di volatilità statisticamente migliore può non migliorare i rendimenti al netto dei costi.
Riporta obiettivo e metodo di misurazione; definizioni e unità dei predittori; frequenze bassa e alta; origine della previsione; numero dei ritardi; funzione e vincoli dei pesi; finestra di stima e calendario di aggiornamento; gestione di dati mancanti e versioni storiche; funzione di perdita; baseline; date del test cronologico. Mostra incertezza o sensibilità se la scelta del profilo dei ritardi modifica materialmente il risultato. Per approfondire, consulta le guide a volatilità realizzata, clustering della volatilità e GARCH e confronti di accuratezza delle previsioni.
Tra le fonti primarie ci sono lo studio MIDAS sulla previsione della volatilità di Ghysels, Santa-Clara e Valkanov; la rassegna metodologica e le estensioni di Ghysels, Sinko e Valkanov; e l'analisi dei modelli di regressione a frequenze miste di Andreou, Ghysels e Kourtellos. I risultati empirici sono legati ai campioni e ai disegni studiati, e non garantiscono prestazioni nei mercati attuali o in altre classi di attività.
Domande frequenti
Q1MIDAS significa che tutti i dati vengono mediati a una sola frequenza?
No. Una regressione MIDAS mantiene l'obiettivo alla frequenza scelta e usa ritardi ponderati strutturati di un predittore a frequenza più alta. Non è necessario interpolare tutte le serie su un calendario comune di righe.
Q2Regressione MIDAS e GARCH-MIDAS sono la stessa cosa?
No. MIDAS è un quadro di ritardi ponderati a frequenze miste. GARCH-MIDAS combina una componente MIDAS di lungo periodo con una ricorsione GARCH della varianza di breve periodo. Obiettivo e componenti vanno verificati nelle equazioni specifiche.
Q3Una previsione MIDAS di volatilità più accurata è già un segnale di trading?
No. La previsione riguarda una misura di dispersione scelta. Una strategia richiede una regola separata di direzione o rischio, costi di esecuzione realistici e una valutazione cronologica dei rendimenti netti.
Fonti e approfondimenti
Segnala un problema
Prepareremo un’e-mail con il link a questo articolo. Mark riceverà la segnalazione solo dopo l’invio
Controllo rapido
Hai finito la guida? Verifica ciò che hai capito con 3 domande
Domanda 01
Qual è il compito principale di una funzione di ponderazione MIDAS?
Scegli una risposta per vedere la spiegazione
Glossario delle opzioni
A time-series model that updates conditional variance from past squared shocks and prior variance; it models volatility persistence, not return direction.
Leggi la guida completaRealized volatilityVolatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
Leggi la guida completaCausationA relationship describing how an outcome would differ under a specified intervention or counterfactual change; observed association alone does not identify it.
Leggi la guida completa