

Uji Diebold–Mariano: Cara Membandingkan Akurasi Prakiraan
Pelajari cara uji Diebold–Mariano membandingkan kerugian prakiraan berpasangan, menangani horizon yang saling tumpang tindih, dan mengapa nilai p rendah bukan bukti keterampilan trading.
Dalam panduan iniKesalahan backtest yang lebih rendah belum membuktikan prakiraan lebih baik
Ringkasan singkat
Uji Diebold–Mariano membandingkan dua prakiraan dengan melihat perbedaan kerugian keduanya pada hasil aktual yang sama. Hasilnya bergantung pada fungsi kerugian, sampel evaluasi, horizon prakiraan, dan estimasi ketidakpastian. Kesalahan sampel yang lebih rendah tidak otomatis membuktikan akurasi harapan yang lebih baik, dan akurasi prakiraan yang lebih tinggi tidak sama dengan strategi trading yang menguntungkan.
Kesalahan backtest yang lebih rendah belum membuktikan prakiraan lebih baik
Misalkan dua model memprakirakan imbal hasil, volatilitas, atau besaran ekonomi yang sama pada tanggal yang sama. Dalam sampel evaluasi, rata-rata kesalahan model A lebih kecil daripada model B. Hal itu menggambarkan sampel tersebut, tetapi tidak menunjukkan apakah A secara konsisten lebih akurat atau apakah selisih yang teramati hanya mencerminkan variasi biasa dari tanggal yang kebetulan diuji.
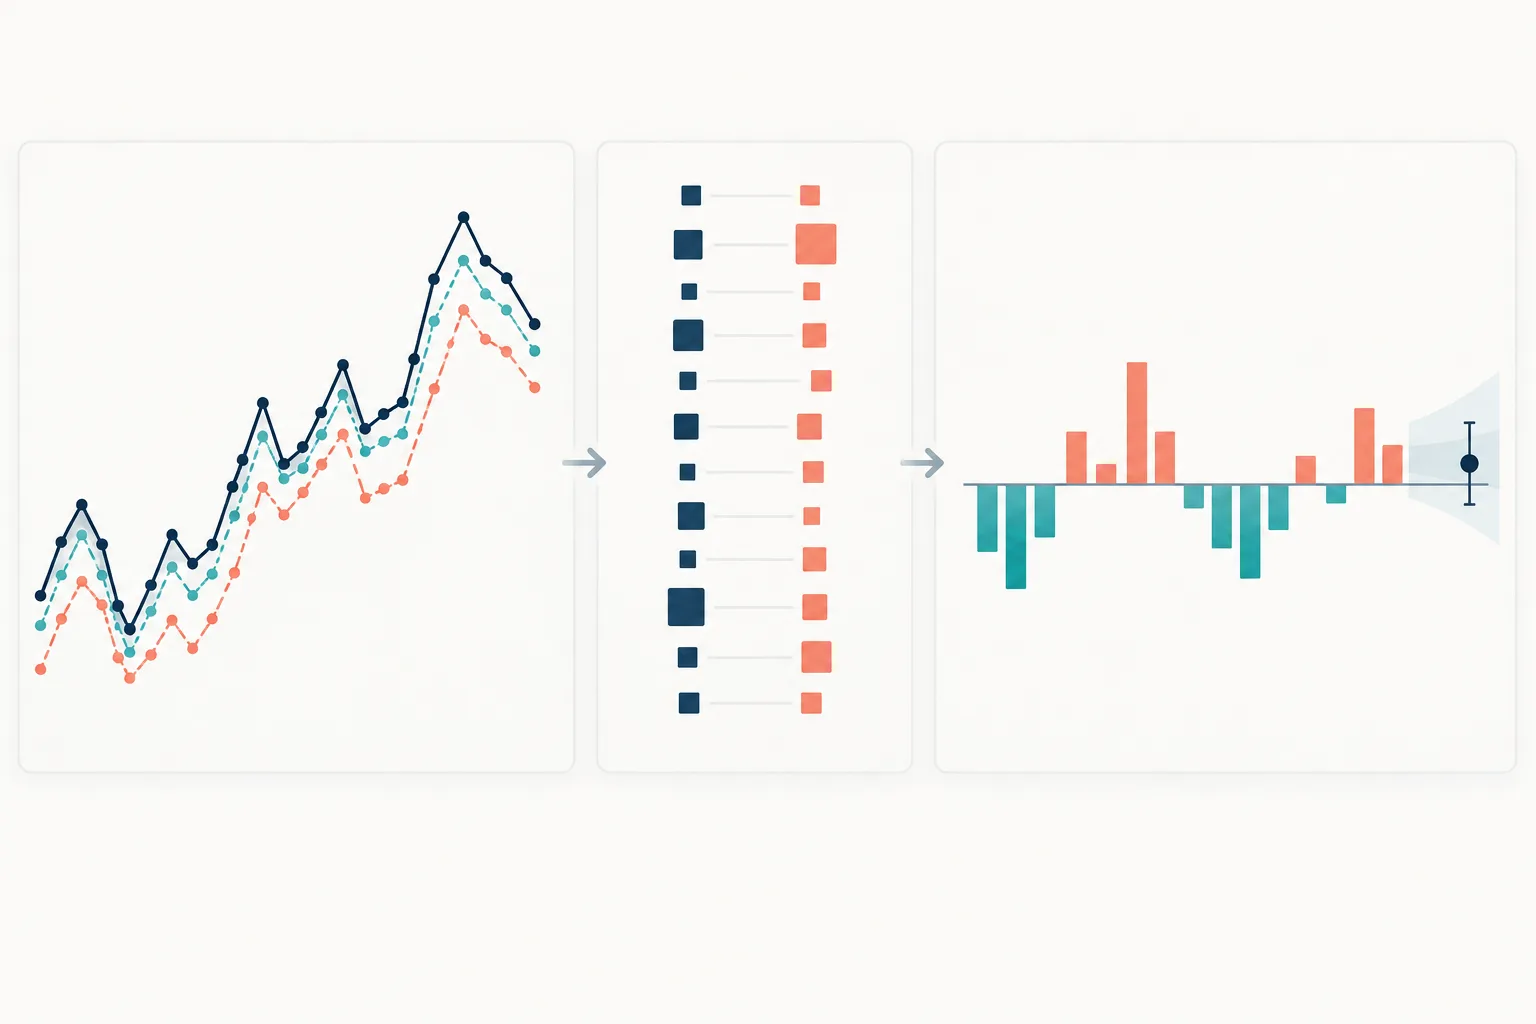
Uji Diebold–Mariano (DM) mengubah perbandingan itu menjadi deret waktu berpasangan. Pada setiap asal prakiraan, uji ini membandingkan kedua prakiraan dengan hasil aktual yang sama, memberi skor menggunakan fungsi kerugian yang ditentukan sebelumnya, lalu memeriksa urutan selisih kerugian. Pemasangan ini penting: hari pasar yang bergejolak dapat meningkatkan kerugian kedua model, sedangkan perbandingan menilai model mana yang cenderung mengalami kerugian lebih kecil pada hari-hari yang sama.
Kerangka asli tidak terbatas pada kesalahan kuadrat atau kesalahan prakiraan yang berdistribusi normal. Kerangka ini dapat membandingkan berbagai fungsi kerugian, termasuk yang asimetris, selama skornya sesuai dengan pertanyaan prakiraan. Namun, desain evaluasi harus dapat dipertanggungjawabkan dan ketidakpastian rata-rata selisih kerugian harus diestimasi. Diebold dan Mariano (1995) menyusun uji kesetaraan akurasi prediktif; Harvey, Leybourne, dan Newbold (1997)00719-4) mengkaji modifikasi sampel kecil.
Samakan dasar perbandingan sebelum menghitung statistik
Setiap baris sebaiknya mewakili satu asal prakiraan yang sebanding. Kedua model harus memprakirakan target dan horizon yang sama dengan informasi yang tersedia pada saat itu. Selaraskan hasil aktual, stempel waktu, mata uang atau satuan, versi data, serta aturan untuk observasi yang hilang sebelum menghitung kerugian. Jika satu model memprakirakan harga penutupan besok dan model lain memprakirakan rata-rata lima hari, kesalahannya menjawab pertanyaan yang berbeda.
Gunakan prakiraan yang dibuat tanpa melihat ke masa depan. Holdout kronologis atau desain pseudo-out-of-sample bergulir dapat membantu, tetapi pemisahan saja tidak cukup jika holdout yang sama berulang kali dipakai untuk menyetel fitur, ambang, atau variasi model. Simpan prakiraan yang benar-benar dibuat pada tiap asal historis, termasuk versi data dan model yang menghasilkannya. Data makro yang direvisi, filter survivorship, atau penyesuaian aksi korporasi dari informasi masa depan dapat mengubah evaluasi secara retrospektif.
Evaluasi kedua model pada kumpulan asal prakiraan yang sama. Menghapus tanggal yang sulit untuk satu model tetapi tidak untuk model lain merusak perbandingan berpasangan. Jika ada prakiraan yang hilang, tetapkan sampel bersama atau jelaskan perlakuan yang beralasan; jangan diam-diam membiarkan model menghadapi rezim pasar yang berbeda. Pilih tanggal awal dan akhir sebelum memeriksa sampel mana yang menghasilkan kesimpulan yang diinginkan.
Fungsi kerugian menentukan arti “lebih akurat”
Misalkan nilai aktual pada asal t adalah yₜ dan prakiraan model adalah ŷA,ₜ serta ŷB,ₜ. Kesalahannya adalah eA,ₜ = yₜ − ŷA,ₜ dan eB,ₜ = yₜ − ŷB,ₜ. Fungsi kerugian L mengubah setiap kesalahan menjadi skor; nilai yang lebih rendah lebih baik. Kerugian kuadrat L(e) = e² memberi penalti lebih besar pada kesalahan yang besar. Kerugian absolut L(e) = |e| tumbuh secara linear terhadap besarnya kesalahan. Prakiraan kuantil dapat memakai kerugian pinball asimetris karena biaya prediksi terlalu rendah dan terlalu tinggi berbeda.
Skor yang dipilih dapat mengubah model mana yang tampak lebih baik. Pertimbangkan dua pasang kesalahan hipotetis dengan satuan yang sama: kesalahan model A adalah 0 dan 2; kesalahan model B adalah 1 dan 1. Dengan kerugian kuadrat, rata-rata kerugiannya masing-masing 2 dan 1, sehingga B mendapat skor lebih baik. Dengan kerugian absolut, rata-rata keduanya 1. Tidak ada perhitungan yang selalu benar; masing-masing menjawab pertanyaan berbeda tentang kesalahan mana yang penting.
Untuk prakiraan imbal hasil, kesalahan kuadrat mungkin berguna bagi prakiraan rata-rata bersyarat. Prakiraan volatilitas memerlukan skor yang dirancang untuk target tersebut, sedangkan prakiraan Value-at-Risk memerlukan skor kuantil atau backtest khusus risiko. Memilih fungsi kerugian setelah melihat model mana yang menang menjadikan pengujian itu pencarian tambahan. Tetapkan skor dan arah “lebih baik” sebelum melihat perbandingan.
Prakiraan VaR menargetkan kuantil ekor, bukan prakiraan titik biasa. Panduan backtesting VaR menjelaskan cara menguji frekuensi dan waktu terjadinya pelanggaran pada prakiraan risiko yang berbeda tersebut.
Bentuk selisih kerugian berpasangan dan nyatakan hipotesis nol
Untuk fungsi kerugian yang lebih rendah berarti lebih baik, definisikan selisih pada periode t sebagai
dₜ = L(eA,ₜ) − L(eB,ₜ)
Dengan konvensi tanda ini, dₜ positif berarti kerugian model A lebih besar sehingga model B memiliki kerugian lebih rendah pada asal tersebut; nilai negatif mendukung model A. Rata-rata sampelnya adalah d̄ = (1/n) Σ dₜ. Hipotesis nol kesetaraan akurasi tanpa syarat adalah E[dₜ] = 0. Alternatif dua sisi menanyakan apakah kerugian harapan berbeda ke salah satu arah. Alternatif satu sisi yang ditetapkan sebelumnya dapat menguji apakah model tertentu memiliki kerugian harapan yang lebih rendah.
Statistik dasarnya adalah
DM = d̄ / √(Ŝd / n)
Di sini Ŝd mengestimasi varians jangka panjang dari deret selisih kerugian, bukan sekadar varians kesalahan prakiraan salah satu model. Di bawah hipotesis nol dan kondisi keteraturan yang sesuai, statistik ini secara asimtotik mengikuti distribusi normal standar. Nilai positif besar mendukung B menurut konvensi tanda di atas; nilai negatif besar mendukung A. Nilai p mengukur kesesuaian data dengan hipotesis nol dan asumsi sampling yang ditetapkan, bukan probabilitas bahwa salah satu model benar.
Pemasangan menghilangkan perbedaan skala kesalahan menyeluruh antara dua model hanya sejauh perbedaan per asal menangkapnya. Pemasangan tidak membuat deret kerugian menjadi independen, tidak otomatis menghilangkan ketidakpastian estimasi parameter, dan tidak mengoreksi pencarian atas banyak target serta spesifikasi. Hal-hal itu perlu ditangani dalam desain dan penghitungan ketidakpastian.
Contoh satu langkah membedakan selisih sampel dari bukti
Misalkan ada 100 prakiraan hipotetis satu langkah yang dipasangkan. Kerugian kuadrat rata-rata model A adalah 0.26 dan model B 0.23, dalam satuan kuadrat poin persentase. Selisih rata-ratanya adalah d̄ = 0.26 − 0.23 = 0.03, sehingga hasil sampel mendukung B. Untuk contoh sederhana ini, anggap estimasi varians jangka panjang dari dₜ adalah 0.04 dan tidak ada kovarians serial antarasalan.
Estimasi kesalahan baku selisih rata-rata adalah √(0.04 / 100) = 0.02. Statistik yang belum disesuaikan adalah 0.03 / 0.02 = 1.50. Untuk horizon h = 1 dan T = 100, faktor sampel kecil Harvey–Leybourne–Newbold adalah √[(T + 1 − 2h + h(h − 1)/T) / T] = √0.99 ≈ 0.995. Setelah dikalikan, statistik tersesuaikan sekitar 1.49; dengan distribusi acuan t₉₉ pendekatan, nilai p dua sisi sekitar 0.14.
B memiliki kesalahan kuadrat rata-rata teramati yang lebih rendah, tetapi contoh ini tidak memberi bukti kuat untuk menolak kesetaraan akurasi harapan pada ambang signifikansi konvensional. Gagal menolak tidak membuktikan bahwa akurasi kedua model sama; penolakan pun tetap bergantung pada skor, asal prakiraan, dan asumsi yang dipilih. Nilai varians dan semua kerugian di sini adalah masukan hipotetis untuk menjelaskan perhitungan, bukan hasil empiris.
Akar kuadrat dari kedua kerugian kuadrat rata-rata tersebut menghasilkan root mean squared error (RMSE) sekitar 0.510 dan 0.480 poin persentase, dengan selisih deskriptif 0.030. Namun, statistik DM menguji selisih kerugian kuadrat yang dipasangkan, bukan selisih kedua akar tersebut dengan uji t.
Horizon yang tumpang tindih membuat selisih kerugian saling bergantung
Jika prakiraan lima hari ke depan diterbitkan setiap hari, dua prakiraan berurutan berbagi empat dari lima hari target. Karena itu, kesalahan, kerugian, dan selisih kerugian dapat bergerak bersama. Menganggap 100 asal prakiraan harian sebagai 100 perbandingan independen dapat mengecilkan ketidakpastian dan membuat statistik tampak terlalu besar.
Varians jangka panjang memperhitungkan kovarians serial dalam dₜ. Estimator heteroskedastisitas-dan-autokorelasi-konsisten (HAC) yang umum berbentuk
Ŝd = γ̂₀ + 2 Σₖ₌₁ᵐ wₖ γ̂ₖ
di mana γ̂ₖ adalah autokovarians sampel d pada lag k, wₖ adalah bobot kernel, dan m adalah bandwidth yang dipilih. Newey dan West (1987) menyajikan estimator kovarians HAC semidefinit positif. Untuk kesalahan prakiraan h-langkah ideal di bawah asumsi yang relevan, overlap sering menimbulkan ketergantungan setidaknya hingga lag h − 1; kerangka DM asli membahas estimator terpotong untuk kasus tersebut. Data nyata bisa memiliki ketergantungan lebih panjang karena target persisten, estimasi bergulir, atau konstruksi strategi. Jadi, h − 1 bukan aturan bandwidth universal.
Nyatakan horizon, kernel, bandwidth, dan penyesuaian sampel kecil. Tunjukkan apakah kesimpulan berubah pada pengaturan dependensi yang masuk akal, alih-alih memilih bandwidth karena menghasilkan nilai p yang diinginkan. Jika asal evaluasi dijarangkan agar tidak tumpang tindih, jelaskan hal itu serta informasi atau ukuran sampel yang dikorbankan. Ketidakpastian yang memperhitungkan dependensi merupakan bagian dari pengujian, bukan pengaturan tampilan opsional.
Model bertingkat dan keterampilan prakiraan yang berubah memerlukan pertanyaan berbeda
Perbandingan DM biasa paling mudah ditafsirkan jika kedua prakiraan tidak saling bertingkat di bawah hipotesis nol kesetaraan akurasi. Jika model yang lebih besar mencakup model kecil sebagai benchmark, koefisien tambahan yang diestimasi dapat menambah noise prakiraan meskipun nilai sebenarnya nol. Di bawah hipotesis tersebut, selisih rata-rata kuadrat kesalahan dapat memiliki distribusi nonstandar. Untuk perbandingan MSPE sampel luar pada model bertingkat, metode seperti penyesuaian Clark–West memperhitungkan efek noise estimasi; metode itu bukan pengganti umum DM untuk semua desain model. Lihat Clark dan West (2007).
Hipotesis nol DM biasa membahas kerugian rata-rata tanpa syarat di seluruh sampel evaluasi. Hipotesis itu dapat menyamarkan perubahan dari waktu ke waktu: A mungkin lebih baik pada periode tenang, sedangkan B lebih baik saat volatilitas tinggi, sehingga rata-rata keseluruhannya serupa. Jika pertanyaannya adalah apakah akurasi relatif bergantung pada informasi yang diketahui pada tanggal prakiraan, uji kemampuan prediktif bersyarat memakai selisih kerugian bersama instrumen yang ditetapkan sebelumnya. Giacomini dan White (2006) mengembangkan kerangka tersebut. Asumsi dan desain jendela evaluasi tetap penting; menambahkan indikator sembarang setelah melihat hasil bukan jalan pintas yang sah.
Pilihan uji sebaiknya mengikuti struktur perbandingan: prakiraan independen, model bertingkat, kemampuan bersyarat yang berubah, atau satu kandidat yang dipilih dari banyak pilihan bukan kasus yang bisa dipertukarkan. Untuk kasus terakhir, panduan White Reality Check dan Hansen SPA menjelaskan koreksi tingkat keluarga setelah banyak aturan trading dicari.
Kerugian prakiraan lebih rendah tidak membuktikan strategi yang menguntungkan
Prakiraan dapat lebih akurat secara statistik tetapi tidak memperbaiki hasil trading bersih. Strategi harus memetakan prakiraan menjadi posisi, menentukan kapan bertransaksi, dan menanggung spread, komisi, slippage, dampak pasar, biaya pendanaan, biaya pinjam, serta batas risiko. Perbaikan kecil pada kesalahan kuadrat rata-rata imbal hasil mungkin tidak berguna bagi keputusan; sebaliknya, model dengan kesalahan rata-rata sedikit lebih buruk mungkin lebih baik mengenali peristiwa ekor yang penting bagi aturan tertentu.
Pisahkan evaluasi prakiraan dari evaluasi portofolio. Pertama, uji prakiraan terhadap target dan kerugian yang sesuai dengan tugas prediksi. Kemudian evaluasi aturan trading yang ditentukan lengkap pada data yang tidak digunakan untuk memilih prakiraan, dengan asumsi eksekusi dan pendanaan yang realistis. Nilai p uji prakiraan bukan imbal hasil backtest, rasio Sharpe, atau probabilitas keuntungan masa depan.
Mencoba berulang kali berbagai model, target, horizon, fungsi kerugian, dan jendela sampel menimbulkan bias seleksi meskipun setiap perhitungan DM individual benar. Catat seluruh pencarian dan gunakan metode tingkat keluarga jika pertanyaannya adalah apakah ada satu kandidat yang bertahan dari pencarian itu. Panduan block bootstrap membahas ketidakpastian yang mempertahankan dependensi untuk statistik yang telah ditentukan sebelumnya; metode itu sendiri tidak mengoreksi pencarian model yang tidak terdokumentasi.
Laporkan detail yang cukup agar peneliti lain dapat mereplikasinya
Sebutkan kedua model prakiraan, hubungan benchmark, target, horizon, jadwal asal prakiraan, tanggal evaluasi, himpunan informasi, versi data, dan aturan sampel bersama. Definisikan fungsi kerugian secara matematis dan nyatakan apakah dₜ positif mendukung A atau B. Laporkan n, rata-rata kerugian tiap model, d̄, estimator varians jangka panjang, kernel dan bandwidth HAC, koreksi sampel kecil, distribusi acuan, arah pengujian, serta nilai p.
Nyatakan juga apakah model bertingkat, bagaimana parameter diestimasi, apakah perbandingan ditetapkan sebelum atau sesudah hasil diperiksa, serta variasi lain yang telah dicoba. Jika sampel dipakai untuk memilih model, sebutkan sebagai bagian dari proses seleksi, bukan bukti out-of-sample yang tidak tersentuh. Laporan yang jelas membuat pembaca dapat melihat apa yang dibandingkan dan masalah ketidakpastian atau seleksi mana yang belum ditangani.
Pertanyaan umum
Q1Apakah uji Diebold–Mariano memerlukan kesalahan prakiraan berdistribusi normal?
Tidak. Kerangka ini dapat menangani kesalahan prakiraan yang tidak normal. Uji ini tetap memerlukan estimasi varians selisih kerugian yang sesuai dan kondisi keteraturan untuk distribusi acuannya.
Q2Dapatkah saya membandingkan dua model yang memprakirakan horizon berbeda?
Bukan sebagai perbandingan akurasi yang setara. Samakan target dan horizon terlebih dahulu; jika tidak, setiap model menjawab pertanyaan prakiraan yang berbeda.
Q3Apakah hasil DM yang signifikan cukup untuk memilih model trading?
Tidak. Hasil itu merupakan bukti tentang kerugian prakiraan harapan pada perbandingan tertentu. Anda tetap perlu mempertimbangkan pencarian model, aturan keputusan, biaya eksekusi, pendanaan, dan kinerja strategi out-of-sample. Riset utama - Diebold dan Mariano, “Comparing Predictive Accuracy” (1995) - Harvey, Leybourne, dan Newbold, “Testing the Equality of Prediction Mean Squared Errors” (1997)00719-4) - Giacomini dan White, “Tests of Conditional Predictive Ability” (2006) - Clark dan West, “Approximately Normal Tests for Equal Predictive Accuracy in Nested Models” (2007) - Newey dan West, “A Simple, Positive Semi-Definite, Heteroskedasticity and Autocorrelation Consistent Covariance Matrix” (1987)
Sumber dan bacaan lanjutan
Laporkan masalah
Kami akan menyiapkan email berisi tautan artikel ini. Mark menerima laporan setelah Anda mengirimkannya
Cek cepat
Sudah membaca panduannya? Uji diri dengan 3 pertanyaan
Pertanyaan 01
Dengan dₜ = L(eA,ₜ) − L(eB,ₜ), apa yang didukung oleh rata-rata sampel yang positif?
Pilih jawaban untuk melihat penjelasannya