

Purged交叉驗證與embargo:避免交易模型中的標籤洩漏
了解金融時序資料中如何處理互相重疊的未來回報標籤,並分辨purging、embargo、walk-forward、TimeSeriesSplit與CPCV。
本指南內容隨機K折何時會令人誤判
簡短摘要
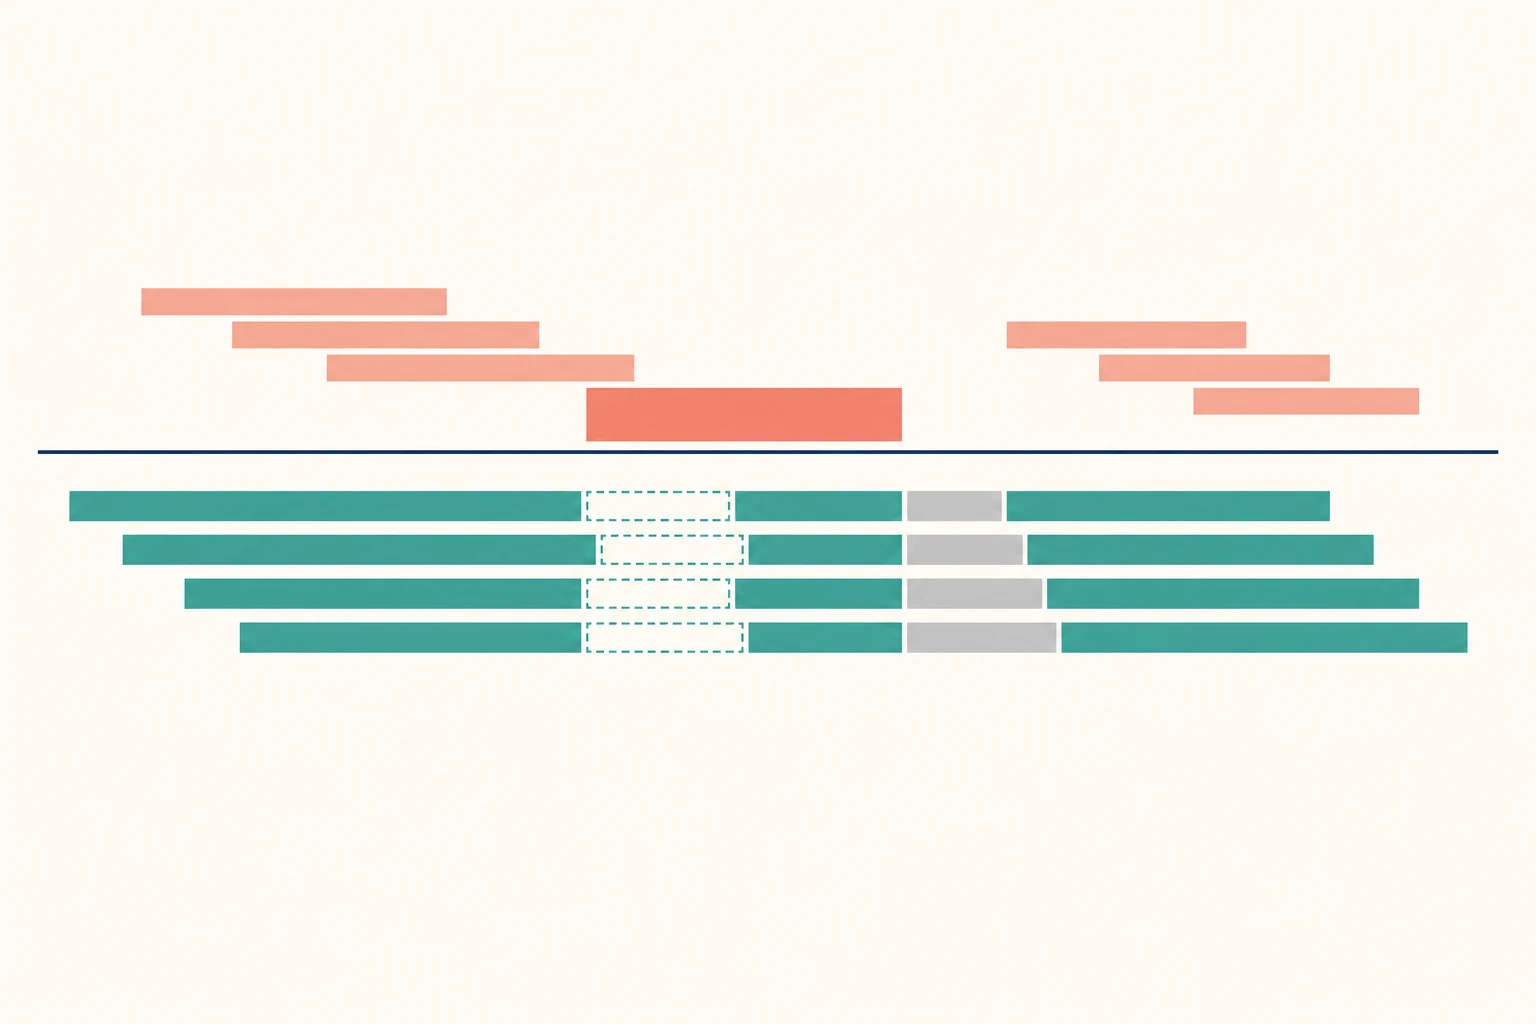
Purged交叉驗證會從訓練集中剔除結果區間與測試標籤區間重疊的樣本。Embargo則是在測試區塊之後另行設定緩衝期;在容許使用測試區塊之後的資料訓練時,暫不把緩衝期內的後續觀察值納入訓練。兩者處理的問題不同,也不會自動把任何切分方式變成按時間順序的walk-forward模擬。
隨機K折何時會令人誤判
一般K折交叉驗證會把樣本分成數組,輪流將其中一組用作測試。金融資料中的觀察值可能互相依賴,而面向未來的回報標籤亦可能涵蓋互相重疊的時段。這時隨機切分會令訓練及測試資料過於接近,評估結果可能顯得過分理想。
這不代表K折在所有情況下都無效。是否適用,要視乎評估問題、資料結構,以及有關依賴關係和標籤區間的假設。處理時序資料時,特徵只可使用預測當刻實際可取得的資訊;測試期的未來結果不可混入訓練標籤。
亦要先說明驗證想回答甚麼問題:是模擬當時只用過去資料訓練,再預測下一段時間的部署流程,還是考察模型在不同切分下是否穩定?兩個目的可能需要不同的切分方法。
定義決策時間及標籤區間
每個樣本都應記錄決策時間t、當時實際可用的資訊、特徵視窗、目標標籤的區間,以及標籤確定的終點t1。例如,在t作出每日決策、預測未來5個交易時段回報的標籤,涵蓋區間(t,t+5]。t+5之後才出現的資料,不可用來構建t時點的特徵。
兩個樣本的過去特徵視窗有共同部分,不會自動構成資料洩漏。如果兩個預測時點都已能取得這段共同歷史,而特徵只使用各時點當時可用的資料,這通常是市場依賴的一部分,與共用未來標籤不同。相反,將之後修訂的經濟數據或回溯調整的價格,當成當時已知資料,就會造成問題。
如果標籤由事件結束時間或波幅界限決定,不同樣本的區間長度可能不同。應保留每個標籤的實際開始及結束時間,不要以固定列數代替所有事件區間。
剔除與測試結果區間重疊的訓練標籤
如果訓練樣本的實際結果或標籤區間與測試樣本的結果區間相交,就應在purging時將該訓練樣本剔除。金融標籤通常包含未來回報或事件;若只比較決策日期,可能會忽略同一段價格變動同時出現在訓練及測試標籤內。
對於長度不一的事件標籤,應比較實際的開始及結束時間。一律刪除固定5列,可能會漏掉較長事件,也可能過度剔除較短事件。先檢查標籤區間有否實際重疊,再按切分設計考慮是否需要額外的embargo。
Purging本身不會令切分按時間先後排列。某些設計仍可能把測試區塊之後的觀察值保留在訓練集中。剔除重疊標籤,與模擬只用過去資料進行歷史部署評估,是兩項不同要求。《Advances in Financial Machine Learning》第7章介紹金融重疊標籤的purging方法。
用五個交易時段的標籤核對區間
假設每日都有一個決策,每個標籤涵蓋未來五個交易時段,即(t,t+5]。以下日期代表連續交易時段。若測試決策日期由第11日至第15日,第15日決策的測試標籤會延伸至第20日。
訓練候選標籤(7,12]與測試結果區間在第11日至第12日重疊。另一個候選標籤(16,21]亦與仍未結束的測試標籤區間重疊。因此,兩個訓練樣本都應被purge。判斷根據實際結果區間,而不只是決策日期相隔多少。
較後的樣本即使標籤沒有與測試標籤重疊,若落在另行設定的embargo期間內,仍可能不納入訓練。本例只示範如何核對區間,並非為所有資料規定一個通用的間隔長度。
將embargo與purging分開設定
對於會使用測試區塊之後觀察值訓練的切分方法,embargo是在測試區塊之後設置的緩衝期;期間內的後續觀察值暫不放入訓練。它有助減少事件或特徵構建方式造成的殘餘依賴,但不能取代對實際標籤區間的重疊檢查。
沒有適用於所有資料的固定比例或固定日數。應按取樣頻率、標籤期限、特徵構建方式及觀察到的依賴程度選擇緩衝期,並記錄理由。如果特徵視窗長於標籤期限,過短的embargo仍可能留下依賴。
在walk-forward切分中,如果訓練不會使用測試期之後的資料,可能毋須為後續訓練資料設置embargo。不過,仍要檢查測試之前的訓練標籤有否延伸至測試結果區間。
分清walk-forward與TimeSeriesSplit
Walk-forward或rolling-origin驗證會用過去資料訓練,再用其後時段測試。當問題是模擬歷史部署流程,即「當時只用已知資料,模型能否預測下一時段」,這種方法較切合目的。應說明訓練視窗會逐步擴大,還是維持固定長度。
scikit-learn的TimeSeriesSplit同樣會把訓練資料放在測試之前;gap參數指定測試開始前,從訓練集末端剔除多少個觀察值。官方文件將gap定義為樣本列數。對等距觀察值而言,這是固定列數的間隔,但不會自動檢查不等長事件標籤的實際區間是否重疊。
因此,單靠gap不足以取代實際標籤區間檢查。時間先後、標籤重疊及所需緩衝期應分開處理。如果列與列之間不代表固定的實際時間,也要記錄列數如何對應至時間長度。
了解Purged K-fold及CPCV回答的問題
Purged K-fold會針對每個測試區塊,剔除標籤區間與其重疊的訓練樣本。視乎切分方法,訓練集仍可能包括測試區塊之後的觀察值。這有助研究模型在不同時段組合下的穩健程度,但回答的問題不同於只用過去資料模擬歷史部署的walk-forward測試。
Combinatorial purged cross-validation(CPCV)會組合不同測試區塊,形成多條測試路徑,以觀察結果分布。《Advances in Financial Machine Learning》第12章對walk-forward及CPCV的討論介紹相關方法;第7章則討論重疊金融標籤的處理。多條測試路徑不會消除特徵前視、事後修訂數據、在全樣本進行預處理,或反覆測試模型造成的選擇偏差。
不要把CPCV路徑數量當成互相獨立的模型實驗次數。從多次試驗中挑選模型所造成的過度擬合,需要另行評估。Bailey等人探討回測過度擬合機率的研究分析了在多個候選項目中作出選擇的問題。
檢查切分後仍然存在的資料洩漏
Purging無法修正前視特徵、錯誤時間戳、倖存者偏差或事後修訂資料。如果在切分前以全樣本擬合標準化、缺失值填補或特徵選擇,測試資料就可能滲入訓練流程。根據測試結果反覆調整模型,亦會產生選擇偏差。
應在每個訓練fold內擬合預處理轉換及特徵選擇,再套用至該fold的驗證部分。選擇模型或超參數時,使用考慮時序的巢狀驗證,並保留一段從未用於選擇的最終時序holdout。手續費、買賣差價或實際成交能力的假設不切實際,同樣會扭曲結果。
交叉驗證不能保證未來表現。得分只是在特定樣本、特徵與標籤定義,以及成本假設下得出的估計。
記錄可重現的驗證設計
每次實驗都應記錄決策時間、資料可用時間、特徵視窗、標籤起止時間、訓練及測試fold邊界、被purge的樣本、embargo長度及其理由、預處理的擬合範圍,以及最終holdout。這些資料有助其他人重建相同的樣本邊界。
有關過度擬合,可參閱[金融模型的偏差與變異取捨](/zh-HK/learn/bias-variance-tradeoff-financial-model-overfitting-explained);有關重複檢驗,可參閱[多重檢驗與金融中的錯誤發現率](/zh-HK/learn/multiple-testing-false-discovery-rate-finance-explained);[考慮序列相關性的Sharpe ratio年化](/zh-HK/learn/sharpe-ratio-serial-correlation-annualization-explained)則說明收益序列評估的另一個問題。報告時要交代每個步驟用了哪些資料,而不只是列出方法名稱。
常見問題
Q1兩個樣本的過去特徵視窗重疊,是否一定代表洩漏?
不一定。如果共同歷史在兩個預測時點都已可用,視窗重疊本身不會洩漏標籤。若測試結果或未來資料進入訓練標籤、特徵或預處理,才會構成風險。
Q2Embargo是否一定要設為五日?
沒有通用長度或比例。應按取樣頻率、標籤期限、特徵構建方式及依賴程度說明緩衝期,並另行檢查實際標籤區間。
Q3CPCV得分高,是否代表未來交易表現有保證?
不是。CPCV會產生多條測試路徑,但不會消除前視、事後修訂數據、多次試驗造成的選擇偏差,或不切實際的成本及成交假設。
資料來源與延伸閱讀
回報問題
我們會準備一封包含本文連結的電郵。寄出後,Mark 才會收到你的回報
快速檢查
讀完指南後,用 3 道題檢查一下
問題 01
如果訓練標籤的結果區間與測試結果區間重疊,purging應如何處理?
選擇答案即可查看解釋