

Validation croisée purgée et embargo : éviter les fuites de labels en trading
Comprenez comment le purging et l’embargo traitent les labels prospectifs qui se chevauchent, et comment ils diffèrent du walk-forward et du CPCV.
Dans ce guidePourquoi un K-fold aléatoire peut tromper en finance
Bref résumé
La validation croisée purgée retire de l’entraînement les observations dont l’intervalle réel de label chevauche celui d’un échantillon de test. L’embargo est une marge définie séparément avant d’admettre dans l’entraînement des observations postérieures au bloc de test. Ces deux règles ne remplacent pas une simulation chronologique de l’usage futur.
Pourquoi un K-fold aléatoire peut tromper en finance
K-fold répartit les observations en blocs, chacun servant tour à tour de test. Dans une série financière, une séparation aléatoire peut placer dans l’entraînement et le test des observations dépendantes, ou des labels prospectifs dont les périodes de résultat se chevauchent. L’entraînement contient alors indirectement de l’information liée au résultat testé, ce qui peut rendre la performance estimée trop favorable.
Cela ne rend pas tout K-fold invalide. Il peut convenir à une question adaptée lorsque les observations sont suffisamment indépendantes et que les labels ne se chevauchent pas. Il faut examiner la construction des variables et des labels ainsi que l’usage futur que l’on cherche à estimer. López de Prado présente ces problèmes et le purging au chapitre 7 d’*Advances in Financial Machine Learning*.
Définir les informations disponibles et l’intervalle du label
Pour chaque échantillon, t est l’instant de décision. Notez les informations réellement disponibles à cet instant, la fenêtre passée utilisée par les variables et le moment où la cible est résolue. Un label de rendement sur cinq séances couvre ici l’intervalle (t, t+5] ; t1 désigne sa fin effective.
Deux prévisions peuvent partager les mêmes données passées sans créer automatiquement de fuite si ces données étaient déjà connues à chaque décision. En revanche, une variable qui intègre des valeurs futures, qui est recalculée rétrospectivement ou mal horodatée crée une fuite. La construction des variables doit respecter l’information accessible au moment de chaque prédiction.
Retirer de l’entraînement les intervalles de labels qui se chevauchent
Le purging retire un échantillon d’entraînement lorsque son intervalle réel de résultat chevauche celui d’un échantillon de test. Vérifiez les horodatages de début et de fin. Pour des événements de durée variable, utilisez leurs bornes réelles, pas un nombre fixe de lignes choisi par commodité.
Le purging ne rend pas une séparation chronologique à lui seul. Un purged K-fold peut encore entraîner sur des données postérieures au bloc de test. Cela peut éclairer une question de robustesse, mais n’est pas l’équivalent d’un test qui n’entraîne que sur le passé avant de prédire le futur. La direction temporelle dépend d’une règle de séparation distincte.
Définir l’embargo comme une marge indépendante
L’embargo est une période précisée après le bloc de test, avant que des observations ultérieures puissent entrer dans l’entraînement dans les séparations qui utilisent des données post-test. Il peut réduire une dépendance résiduelle due à la construction des événements ou des variables. Il ne remplace pas le contrôle des intervalles réels et n’a ni durée ni pourcentage universels.
Justifiez sa longueur selon la fréquence d’échantillonnage, l’horizon du label, les fenêtres de variables et la dépendance observée. Fixez et documentez la règle avant de comparer les résultats. Dans un découpage strictement orienté vers le futur, aucune observation post-test n’est disponible pour ce cas d’usage de l’embargo.
Exemple quotidien avec un horizon de cinq séances
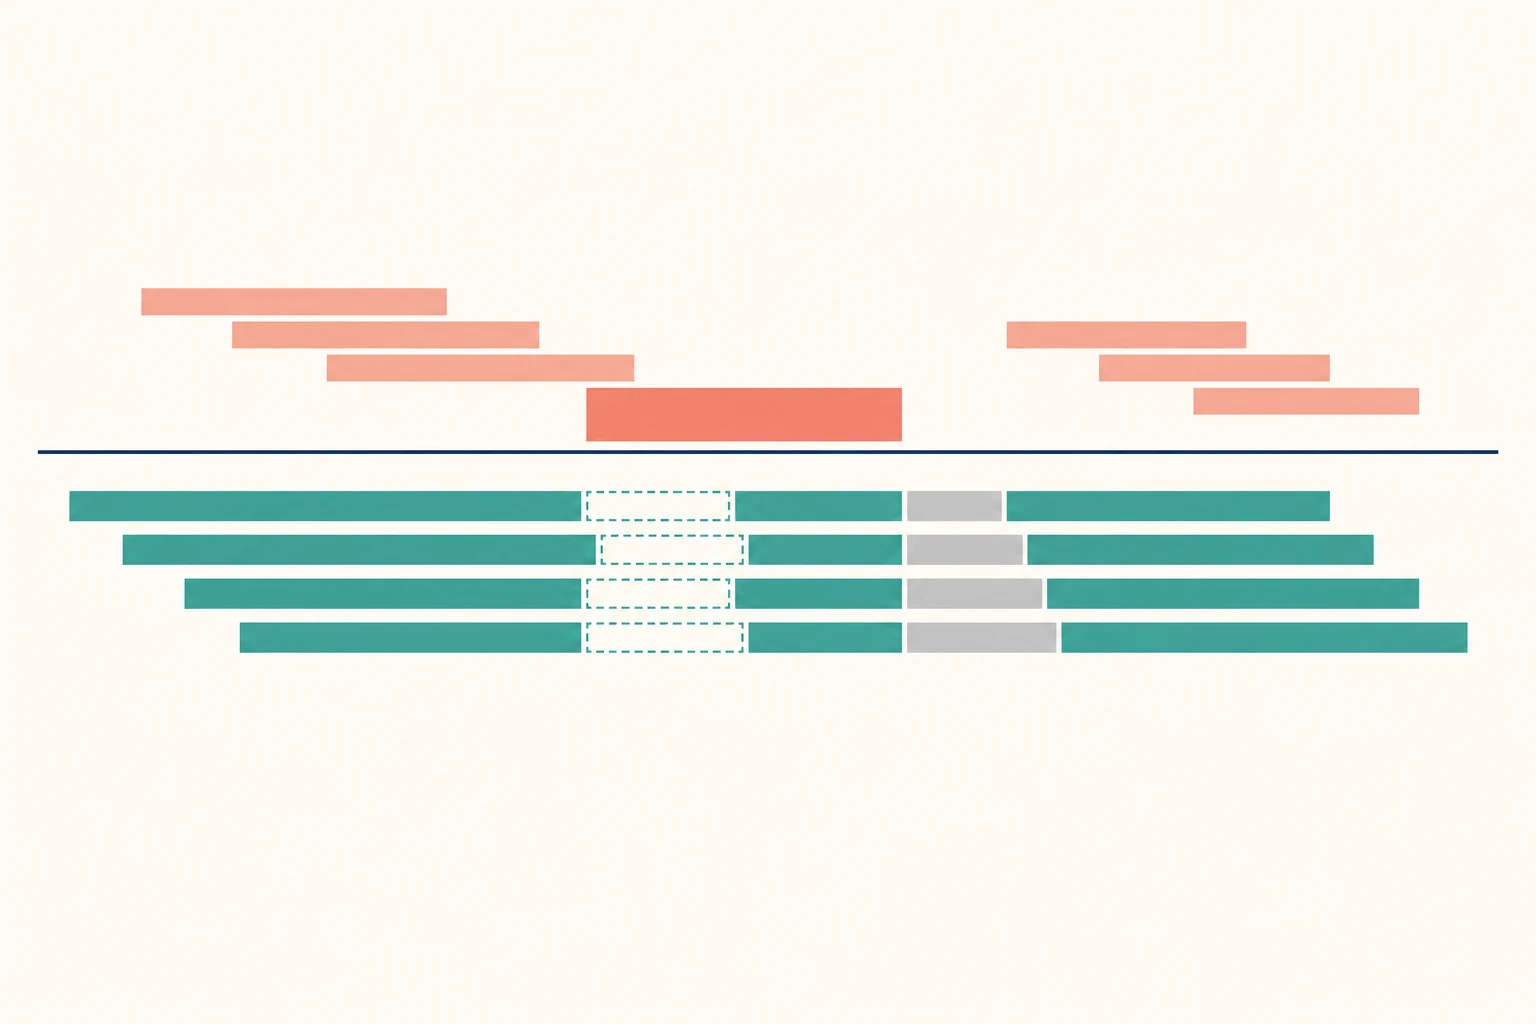
Supposons des décisions quotidiennes et un label de rendement sur les cinq séances suivantes, soit (t, t+5]. Un bloc test portant sur les dates de décision 11 à 15 a des labels qui vont jusqu’au jour 20. Les jours désignent ici des séances et tous les intervalles suivent la même convention.
Le label d’entraînement (7,12] chevauche le test puisqu’il partage des jours avec le label de la décision du jour 11. Le label (16,21] le chevauche également : le label test du jour 15 va jusqu’au jour 20. Ces deux échantillons d’entraînement sont purgés. Un label ultérieur sans chevauchement peut malgré tout être exclu par une zone d’embargo définie séparément. Cet exemple ne fixe pas une durée universelle.
Distinguer K-fold, walk-forward, gap, purged K-fold et CPCV
Le K-fold aléatoire peut mélanger des périodes différentes. La validation walk-forward ou rolling-origin entraîne sur le passé et teste sur un bloc ultérieur, ce qui représente souvent plus directement une simulation historique de déploiement. La documentation officielle de TimeSeriesSplit de scikit-learn décrit ces découpages chronologiques et demande des observations également espacées pour comparer des durées de test équivalentes.
TimeSeriesSplit(gap=...) écarte un nombre fixe de lignes avant le test. gap ne détecte pas les intervalles d’événement variables : ce nombre de lignes n’a un sens temporel cohérent que si les observations sont espacées de façon appropriée, généralement régulièrement. Le purged K-fold et la validation croisée combinatoire purgée (CPCV) créent plusieurs combinaisons ou chemins de test, mais peuvent utiliser pour l’entraînement des données postérieures au bloc testé. Leur question diffère donc d’une simulation walk-forward historique.
Le chapitre 12 de López de Prado consacré au backtesting complète la comparaison du walk-forward et de la CPCV.
Les autres sources de fuite restent à traiter
Le purging ne corrige ni les variables avec lookahead ou horodatages erronés, ni le biais de survivance, ni les données révisées a posteriori. Normaliser, imputer ou sélectionner les variables sur l’ensemble des données avant le découpage peut aussi transmettre des informations test à l’entraînement. Ajustez chaque transformation et sélection à l’intérieur du fold d’entraînement.
Multiplier les essais augmente le risque de retenir un gagnant dû au hasard. Bailey et ses coauteurs étudient les essais répétés dans leur article sur la probabilité de surajustement des backtests. Utilisez une validation imbriquée qui respecte le temps pour la sélection, puis gardez une période chronologique finale intacte. Modélisez aussi les coûts et les exécutions de façon réaliste. Aucune validation croisée ne garantit les résultats futurs.
Rapporter les résultats et leur incertitude
Indiquez la longueur de l’échantillon, la fréquence, les horizons de labels, la disponibilité des variables, la règle de découpage, les observations purgées et la justification de l’embargo. Précisez si l’entraînement a inclus des observations postérieures au test et quelle question vous évaluez. Un seul score agrégé peut masquer les écarts entre périodes ou chemins de test.
Comparez les modèles avec les mêmes bornes temporelles, labels, hypothèses de coûts et règles de sélection. Tenez compte de l’incertitude et du nombre de variantes testées : de faibles écarts sur une courte période sont peu concluants. Pour aller plus loin : compromis biais-variance et surajustement, tests multiples et taux de fausses découvertes et ratio de Sharpe avec autocorrélation sérielle.
Arrêter le protocole de validation avant le backtest
Pour chaque échantillon, consignez l’instant t, les données disponibles, la fenêtre de variables et les bornes réelles du label jusqu’à t1. Choisissez un découpage lié à la question d’usage, purgez les labels d’entraînement qui croisent ceux du test, puis spécifiez séparément l’embargo lorsque le split inclut des données post-test.
Vérifiez le prétraitement à l’intérieur de chaque fold, consignez les essais de modèles et les coûts, et réservez un holdout chronologique final intact. Ces précautions rendent l’analyse plus vérifiable, sans transformer les données passées en garantie de performance future. Ce guide explique des mécanismes de validation et ne recommande ni investissement ni stratégie.
Questions fréquentes
Q1Le K-fold aléatoire est-il toujours incorrect pour les séries financières ?
Non. Il peut convenir à une question où les observations sont suffisamment indépendantes et les labels sans chevauchement. En présence de dépendance temporelle ou de labels prospectifs, la séparation doit respecter cette structure.
Q2L’embargo rend-il le purging inutile ?
Non. Le purging vérifie les chevauchements réels des intervalles de labels. L’embargo ajoute une marge à certains splits avec entraînement post-test. Chaque règle demande une justification documentée.
Q3La CPCV remplace-t-elle le walk-forward ?
Pas automatiquement. La CPCV produit plusieurs combinaisons et chemins de test, mais peut entraîner sur des données postérieures à un bloc de test. Une simulation historique chronologique reste une question distincte.
Sources et lectures complémentaires
Signaler un problème
Nous préparons un e-mail avec le lien de cet article. Mark ne reçoit le signalement qu’après son envoi
Vérification rapide
Guide terminé ? Vérifiez vos acquis avec 3 questions
Question 01
Quel échantillon faut-il retirer par purging ?
Choisissez une réponse pour voir l'explication
Glossaire des options
The relationship between systematic prediction error from model mismatch and instability caused by sensitivity to the training sample.
Lire le guide approfondiFamily-wise error rateThe probability of falsely rejecting at least one true null hypothesis within a predefined family of tests.
Lire le guide approfondiassignation d’optionProcessus qui attribue au vendeur l’obligation d’exécuter le contrat après un avis d’exercice et peut créer une livraison ou un achat d’actions.
Lire le guide approfondi