Validación de modelos de series temporales12 min de lectura
Validación cruzada purgada y embargo: evitar fugas de etiquetas en modelos de trading
Aprende cómo el purging y el embargo tratan etiquetas forward solapadas en series financieras y en qué se diferencian del walk-forward y CPCV.
En esta guíaPor qué K-fold aleatorio puede inducir a error con datos financieros
Resumen breve
La validación cruzada purgada elimina del entrenamiento las observaciones cuyos intervalos reales de etiqueta se solapan con los de una muestra de prueba. El embargo es un margen definido por separado antes de permitir que observaciones posteriores al bloque de prueba entren en el conjunto de entrenamiento. Ninguna de estas reglas equivale por sí sola a una simulación cronológica del uso futuro.
Por qué K-fold aleatorio puede inducir a error con datos financieros
K-fold divide las observaciones en bloques y usa cada uno, por turnos, para probar el modelo. En series financieras, una división aleatoria puede repartir entre entrenamiento y prueba observaciones dependientes o etiquetas forward con periodos de resultado solapados. Así, el entrenamiento puede contener información vinculada al intervalo de resultado de la prueba, y la métrica parecer mejor de lo que sería en datos verdaderamente nuevos.
Esto no significa que todo uso de K-fold sea siempre inválido. Puede servir para una pregunta adecuada cuando las observaciones son suficientemente independientes y las etiquetas no se solapan. Hay que examinar cómo se construyeron las variables y las etiquetas, y qué situación de uso se quiere estimar. López de Prado explica estos problemas y el purging en el capítulo 7 de *Advances in Financial Machine Learning*.
Definir qué se sabía y cuándo se resuelve cada etiqueta
Para cada muestra, sea t el momento de decisión. Registra la información que estaba realmente disponible entonces, la ventana histórica usada para construir las variables y el intervalo del objetivo. Una etiqueta de rentabilidad a cinco sesiones se define aquí en el intervalo (t, t+5]; t1 es el momento en que se resuelve el resultado.
Que dos muestras compartan datos históricos de variables no constituye por sí solo una fuga: ambas predicciones podían conocer esos datos en sus respectivos momentos de decisión. Sí hay fuga si una variable usa datos futuros, se calcula retrospectivamente con información que entonces no existía o lleva una marca temporal incorrecta. La construcción de variables debe respetar el conjunto de información disponible en cada predicción.
Purgar del entrenamiento las etiquetas que se solapan
El purging elimina una muestra de entrenamiento si su intervalo real de resultado se solapa con el intervalo de resultado de una muestra de prueba. Comprueba los tiempos reales de inicio y fin de cada etiqueta. Si los eventos tienen duraciones distintas, usa sus marcas temporales reales, no un número fijo de filas elegido por comodidad.
Purgar no convierte automáticamente una partición en cronológica. Un purged K-fold todavía puede entrenar con observaciones posteriores al bloque de prueba. Eso puede ser útil para ciertas preguntas de robustez, pero estima algo distinto de entrenar solo con el pasado y probar después. La dirección temporal debe estar definida por separado en el diseño de la partición.
Definir el embargo como un margen independiente
El embargo es un margen especificado después de un bloque de prueba, antes de permitir que observaciones posteriores entren en el conjunto de entrenamiento en particiones que incluyen datos posteriores al test. Puede reducir dependencias residuales debidas a la construcción de eventos o variables. No sustituye la comprobación de intervalos reales y no existe un porcentaje o duración universal.
Justifica su longitud según la frecuencia de muestreo, el horizonte de la etiqueta, las ventanas de variables y la dependencia observada. Define y documenta la regla antes de comparar resultados. Si el entrenamiento solo usa datos anteriores al test, no hay observaciones posteriores para las que aplicar este caso del embargo.
Ejemplo diario con un horizonte de cinco sesiones
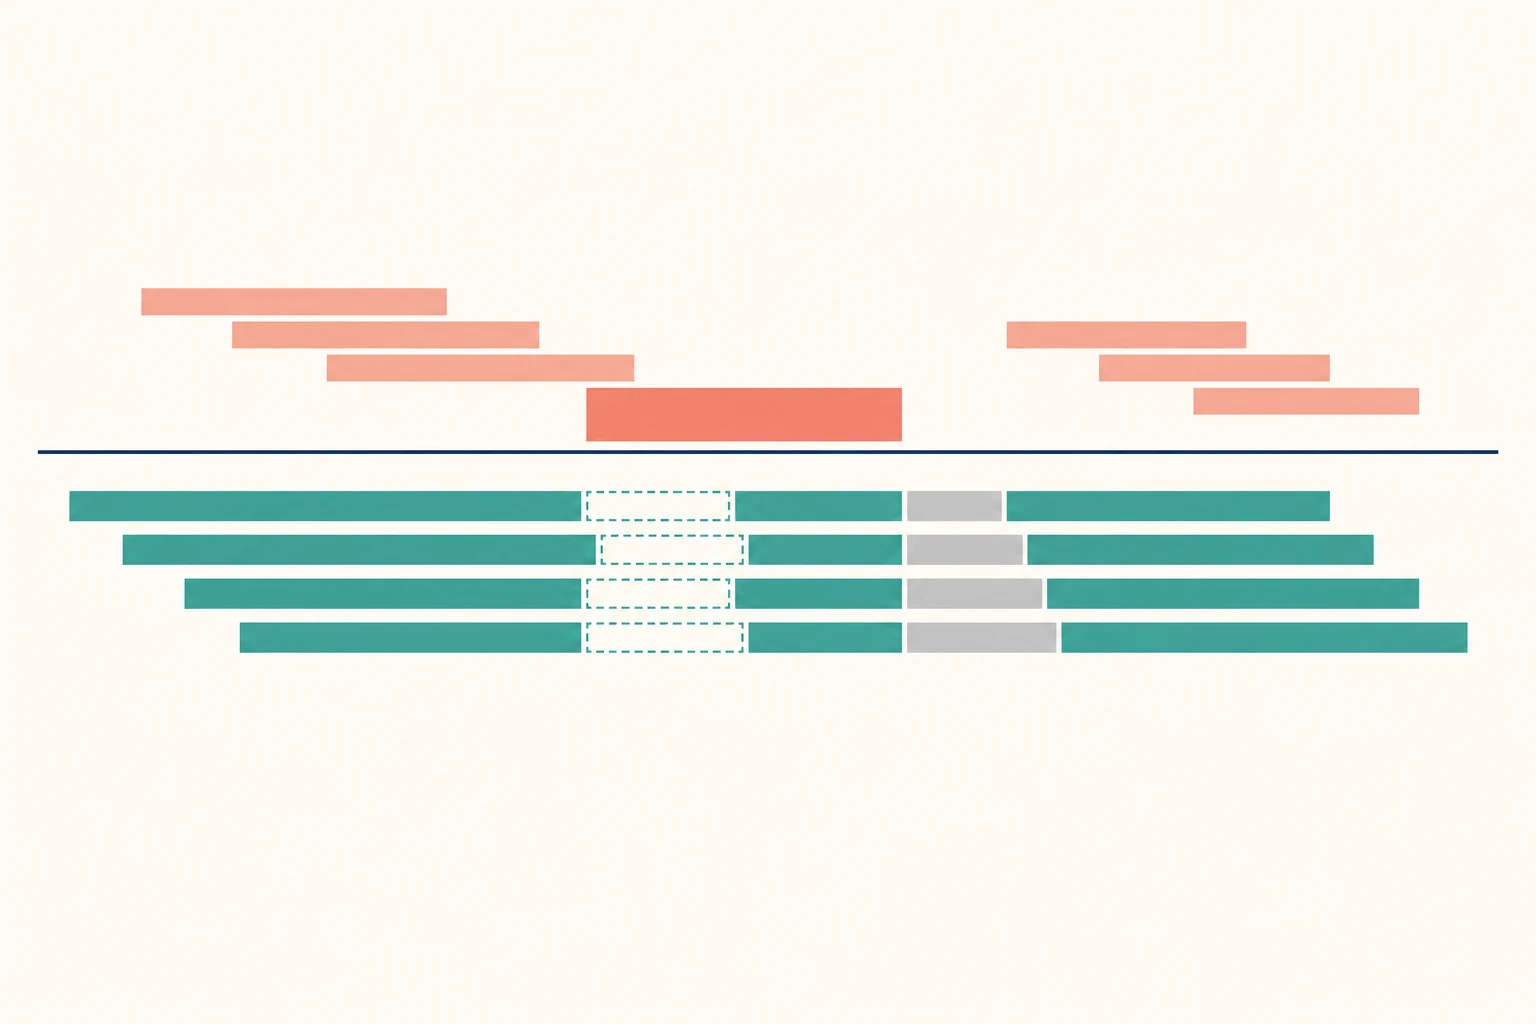
Supongamos decisiones diarias y etiquetas de rentabilidad para las cinco sesiones siguientes, en (t, t+5]. Un bloque de prueba con fechas de decisión del día 11 al 15 tiene etiquetas que llegan hasta el día 20. El ejemplo usa días de sesión y la misma convención de intervalos en todas las muestras.
La etiqueta de entrenamiento (7,12] se solapa con el test porque comparte días con la etiqueta de la decisión del día 11. También se solapa (16,21], ya que la etiqueta de prueba del día 15 llega al día 20. Se purgan ambas muestras de entrenamiento. Incluso una etiqueta posterior sin solapamiento puede quedar excluida por una zona de embargo definida por separado. El ejemplo no establece una brecha universal.
El purging elimina intervalos de etiqueta solapados; el embargo añade un margen independiente y justificado.
Distinguir K-fold, walk-forward, gap, purged K-fold y CPCV
Random K-fold puede mezclar observaciones de distintos periodos. La validación walk-forward o rolling-origin entrena con datos anteriores y prueba con un bloque posterior, por lo que suele reflejar de forma más directa una secuencia histórica de despliegue. La documentación oficial de TimeSeriesSplit de scikit-learn describe particiones cronológicas y señala que se necesitan observaciones espaciadas por igual para que los plazos de prueba sean comparables.
TimeSeriesSplit(gap=...) deja fuera un número fijo de filas antes del bloque de prueba. gap no es un motor que detecte intervalos variables de eventos: contar filas solo representa una duración temporal interpretable si el muestreo tiene espaciado adecuado, normalmente regular. Purged K-fold y la validación cruzada combinatoria purgada (CPCV) crean varias combinaciones o trayectorias de prueba y pueden incluir entrenamiento posterior al bloque probado. Por tanto, no responden automáticamente a la misma pregunta que una simulación walk-forward histórica.
Un purging correcto no corrige variables con lookahead o marcas temporales erróneas, sesgo de supervivencia ni datos revisados después. La normalización, imputación o selección de variables realizada globalmente antes de separar los folds también puede filtrar información de prueba al entrenamiento. Ajusta cada transformación y selección dentro del fold de entrenamiento correspondiente.
Probar muchas variantes aumenta además la posibilidad de seleccionar por azar un ganador del backtest. El trabajo de Bailey y sus coautores sobre la probabilidad de sobreajuste del backtest estudia el riesgo de múltiples pruebas. Usa validación anidada y consciente del tiempo para seleccionar modelos, y reserva un tramo cronológico final que no se toque. Modela costes y ejecuciones realistas. Ningún método de validación cruzada garantiza resultados futuros.
Informar los resultados y su incertidumbre
Indica la longitud de la muestra, frecuencia, horizontes de etiqueta, disponibilidad de variables, regla de partición, observaciones purgadas y justificación del embargo. Explica si se admitieron filas posteriores al test y qué pregunta se pretendía responder. Una sola métrica agregada puede ocultar diferencias entre periodos o trayectorias de prueba.
Registra para cada muestra el momento de decisión t, los datos disponibles, la ventana de variables y los límites reales de la etiqueta hasta t1. Elige una partición acorde con la pregunta de uso; después, purga las etiquetas de entrenamiento que crucen intervalos de prueba y define por separado el embargo cuando corresponda.
Comprueba que el preprocesamiento se ajuste dentro de cada fold, documenta las pruebas de modelos y los costes, y conserva un holdout cronológico final intacto. Esto hace el análisis más auditable, pero no convierte los datos pasados en garantía del futuro. Esta guía describe mecanismos de validación, no recomienda inversiones ni estrategias.
Preguntas frecuentes
Q1¿K-fold aleatorio siempre es incorrecto para series financieras?
No. Puede responder a una pregunta adecuada si las observaciones son suficientemente independientes y las etiquetas no se solapan. Cuando hay dependencia temporal o etiquetas forward, el diseño debe respetar esa estructura.
Q2¿El embargo hace innecesario el purging?
No. El purging comprueba solapamientos reales de intervalos de etiqueta. El embargo añade un margen para ciertas particiones con entrenamiento posterior. Cada regla necesita una justificación documentada.
Q3¿CPCV sustituye a las pruebas walk-forward?
No necesariamente. CPCV genera distintas combinaciones y trayectorias de prueba, pero puede entrenar con datos posteriores a un bloque de prueba. Simular el uso histórico con entrenamiento solo pasado sigue siendo una pregunta distinta.