

اختبار ديبولد–ماريانو: كيف تقارن دقة التوقعات
تعرّف على مقارنة خسائر التوقعات المزدوجة باختبار ديبولد–ماريانو، ومعالجة الآفاق المتداخلة، وحدود تفسير النتيجة بوصفها دليلاً على مهارة التداول.
في هذا الدليلانخفاض خطأ الاختبار التاريخي لا يثبت وحده أن التوقع أفضل
ملخص موجز
يقارن اختبار ديبولد–ماريانو خسارتي توقعين عبر النتائج الفعلية نفسها. وتعتمد النتيجة على دالة الخسارة، وعينة التقييم، وأفق التوقع، وتقدير عدم اليقين. انخفاض الخطأ في العينة لا يثبت تلقائيًا ارتفاع الدقة المتوقعة، كما أن تحسن دقة التوقع لا يثبت ربحية استراتيجية تداول.
انخفاض خطأ الاختبار التاريخي لا يثبت وحده أن التوقع أفضل
لنفترض أن نموذجين يتوقعان العائد أو التقلب أو متغيرًا اقتصاديًا واحدًا في التواريخ نفسها. قد يسجل النموذج A متوسط خطأ أقل من النموذج B في عينة التقييم. يصف ذلك ما حدث في العينة، لكنه لا يبين إن كان الفرق مستقرًا بما يكفي للتكرار، أم نتج عن التواريخ التي صادف اختبارها.
يحوّل اختبار ديبولد–ماريانو (DM) هذه المقارنة إلى سلسلة زمنية مزدوجة. عند كل نقطة إصدار، يقارن التوقعين بالنتيجة المحققة نفسها، ويقيّمهما بدالة خسارة محددة مسبقًا، ثم يفحص تسلسل فروق الخسارة. والمقارنة المزدوجة مهمة: قد يرفع يوم متقلب خسارتي النموذجين معًا، بينما يختبر التحليل ما إذا كان أحدهما يخسر أقل على تلك الأيام نفسها.
لا يقتصر الإطار الأصلي على الخطأ التربيعي أو على أخطاء التوقع ذات التوزيع الطبيعي. يمكنه مقارنة دوال خسارة متنوعة، ومنها غير المتماثلة، إذا كانت مناسبة لسؤال التوقع. لكنه يتطلب تصميم تقييم يمكن الدفاع عنه وتقديرًا لعدم اليقين في متوسط فرق الخسارة. يقدّم Diebold وMariano (1995) اختبار تساوي دقة التوقع، ويدرس Harvey وLeybourne وNewbold (1997)00719-4) تعديلًا للعينات الصغيرة.
وحّد ظروف المقارنة قبل حساب الإحصائية
ينبغي أن يمثل كل صف نقطة توقع قابلة للمقارنة. يجب أن يتنبأ النموذجان بالهدف نفسه والأفق نفسه باستخدام المعلومات التي كانت متاحة عند نقطة الإصدار. وحّد النتائج الفعلية والطوابع الزمنية والعملة أو وحدة القياس وإصدار البيانات وقواعد معالجة القيم المفقودة. فإذا توقع أحد النموذجين إغلاق الغد وتوقع الآخر متوسط خمسة أيام، فالأخطاء تجيب عن سؤالين مختلفين.
استخدم توقعات لم تطّلع على المستقبل. يمكن لفترة اختبار مرتبة زمنيًا أو لتصميم متدرج خارج العينة أن يساعدا، لكن مجرد التقسيم لا يكفي إذا استُخدمت نتائج فترة الاختبار مرارًا لضبط السمات أو العتبات أو نسخ النماذج. احتفظ بالتوقع الذي صدر عند كل نقطة تاريخية، وبإصدار البيانات والنموذج الذي أنتجه. وإلا فقد تغيّر البيانات الاقتصادية المنقحة أو مرشحات تحيز البقاء أو تعديلات الشركات المستقبلية نتيجة التقييم بأثر رجعي.
قيّم النموذجين على مجموعة نقاط الإصدار نفسها. فحذف التواريخ الصعبة من نموذج واحد يكسر المقارنة المزدوجة. عند غياب بعض التوقعات، استخدم عينة مشتركة أو اشرح معالجة مبررة للتوقعات المفقودة؛ ولا تدع النموذجين يواجهان فترتين سوقيتين مختلفتين من دون تصريح. اختر تاريخي البداية والنهاية قبل فحص العينة التي تعطي النتيجة المفضلة.
دالة الخسارة هي التي تحدد معنى «الأكثر دقة»
لتكن القيمة المحققة عند النقطة t هي yₜ، وتوقعا النموذجين A وB هما ŷA,ₜ وŷB,ₜ. عندئذ يكون الخطآن eA,ₜ = yₜ − ŷA,ₜ وeB,ₜ = yₜ − ŷB,ₜ. تحوّل دالة الخسارة L كل خطأ إلى درجة يكون الأقل فيها أفضل. تعاقب الخسارة التربيعية L(e) = e² الأخطاء الكبيرة بدرجة أكبر، بينما تنمو الخسارة المطلقة L(e) = |e| خطيًا مع حجم الخطأ. وقد يستخدم توقع الكمية خسارة الدبوس غير المتماثلة لأن كلفة المبالغة في التوقع تختلف عن كلفة التقليل منه.
قد يغيّر اختيار الدرجة النموذج الذي يبدو أفضل. افترض زوجين افتراضيين من الأخطاء بالوحدة نفسها: أخطاء A هي 0 و2، وأخطاء B هي 1 و1. متوسط الخسارة التربيعية هو 2 لـA و1 لـB، لذا تسجل B نتيجة أفضل. أما متوسط الخسارة المطلقة فهو 1 لكليهما. ليس أحد الحسابين صحيحًا دائمًا؛ فكل منهما يجيب عن سؤال مختلف حول الأخطاء المهمة.
قد يفيد الخطأ التربيعي لتوقع المتوسط الشرطي للعوائد، بينما يحتاج توقع التقلب إلى درجة تناسب هدفه، ويحتاج توقع القيمة المعرضة للخطر (VaR) إلى درجة كمية أو اختبار خلفي ملائم للمخاطر. اختيار الخسارة بعد معرفة النموذج الفائز يجعل الاختبار جزءًا من عملية بحث أخرى. حدّد الدرجة واتجاه «الأفضل» قبل الاطلاع على المقارنة.
يستهدف توقع VaR كمية ذيلية لا توقعًا نقطيًا عاديًا. يشرح دليل الاختبار الخلفي لـVaR كيف تقيّم اختبارات تكرار التجاوزات وتوقيتها توقعات المخاطر هذه على نحو منفصل.
كوّن فروق الخسارة المزدوجة واذكر الفرضية الصفرية
إذا كانت الخسارة الأقل أفضل، فعرّف فرق الفترة t كما يلي:
dₜ = L(eA,ₜ) − L(eB,ₜ)
وفق اصطلاح الإشارة هذا، تعني قيمة dₜ الموجبة أن خسارة B أقل في تلك النقطة؛ والسالبة ترجّح A. ومتوسط العينة هو d̄ = (1/n) Σ dₜ. فرضية تساوي الدقة غير المشروطة هي E[dₜ] = 0. ويسأل البديل ثنائي الطرف إن اختلفت الخسارتان المتوقعـتان في أي اتجاه. ويمكن لبديل أحادي الطرف محدد مسبقًا أن يسأل إن كان نموذج مسمى يحقق خسارة متوقعة أقل.
إحصائية الاختبار الأساسية هي:
DM = d̄ / √(Ŝd / n)
حيث تقدّر Ŝd التباين طويل الأجل لسلسلة فروق الخسارة، لا تباين أخطاء كل نموذج على حدة. في ظل الفرضية الصفرية وشروط الانتظام المناسبة، تقترب الإحصائية تقاربيًا من التوزيع الطبيعي المعياري. القيم الموجبة الكبيرة ترجّح B وفق اصطلاح الإشارة أعلاه، والسالبة الكبيرة ترجّح A. تقيس قيمة p مدى توافق البيانات مع الفرضية المحددة وافتراضات أخذ العينات، لا احتمال أن يكون أحد النموذجين صحيحًا.
تزيل المقارنة المزدوجة بعض الفروق غير ذات الصلة في مستويات أخطاء النموذجين بقدر ما تلتقطه فروقهما في كل نقطة. لكنها لا تجعل سلسلة الخسارة مستقلة، ولا تزيل تلقائيًا عدم يقين تقدير المعلمات، ولا تصحح البحث في أهداف ومواصفات عديدة. يجب أن يعالج تصميم التقييم وتقدير عدم اليقين هذه الاختيارات.
يميّز مثال من خطوة واحدة بين فرق العينة وقوة الدليل
افترض وجود 100 توقع افتراضي مزدوج لأفق خطوة واحدة. متوسط الخسارة التربيعية للنموذج A هو 0.26 وللنموذج B هو 0.23، بوحدات مربعة من النقاط المئوية. لذلك يكون d̄ = 0.26 − 0.23 = 0.03 لمصلحة B في العينة. ولتبسيط المثال، افترض أن التباين طويل الأجل المقدّر لـdₜ يساوي 0.04 ولا يوجد تغاير تسلسلي بين نقاط الإصدار.
الخطأ المعياري لمتوسط الفرق هو √(0.04 / 100) = 0.02. والإحصائية غير المعدلة هي 0.03 / 0.02 = 1.50. عند أفق h = 1 وعدد T = 100، يكون معامل تصحيح العينة الصغيرة لهارفي–ليبورن–نيوبولد هو √[(T + 1 − 2h + h(h − 1)/T) / T] = √0.99 ≈ 0.995. ينتج عن الضرب إحصاء معدل يقارب 1.49؛ وباستخدام توزيع t₉₉ التقريبي تكون قيمة p ثنائية الطرف نحو 0.14.
سجلت B متوسط خطأ تربيعيًا مرصودًا أقل، لكن المثال لا يقدم دليلًا قويًا ضد تساوي الدقة المتوقعة عند مستويات الدلالة المعتادة. وعدم رفض الفرضية لا يثبت تساوي دقة النموذجين؛ كما أن رفضها يظل مشروطًا بالدرجة والنقاط والافتراضات المختارة. قيم التباين والخسائر هنا افتراضات تعليمية، وليست نتائج تجريبية.
والجذر التربيعي لمتوسط الخطأ التربيعي (RMSE) المقابل يقارب 0.510 و0.480 نقطة مئوية، بفارق وصفي قدره 0.030 نقطة. لكن إحصائية DM تختبر فروق الخسارة التربيعية المزدوجة، ولا تختبر الفرق بين قيمتي RMSE.
تجعل الآفاق المتداخلة فروق الخسارة مترابطة
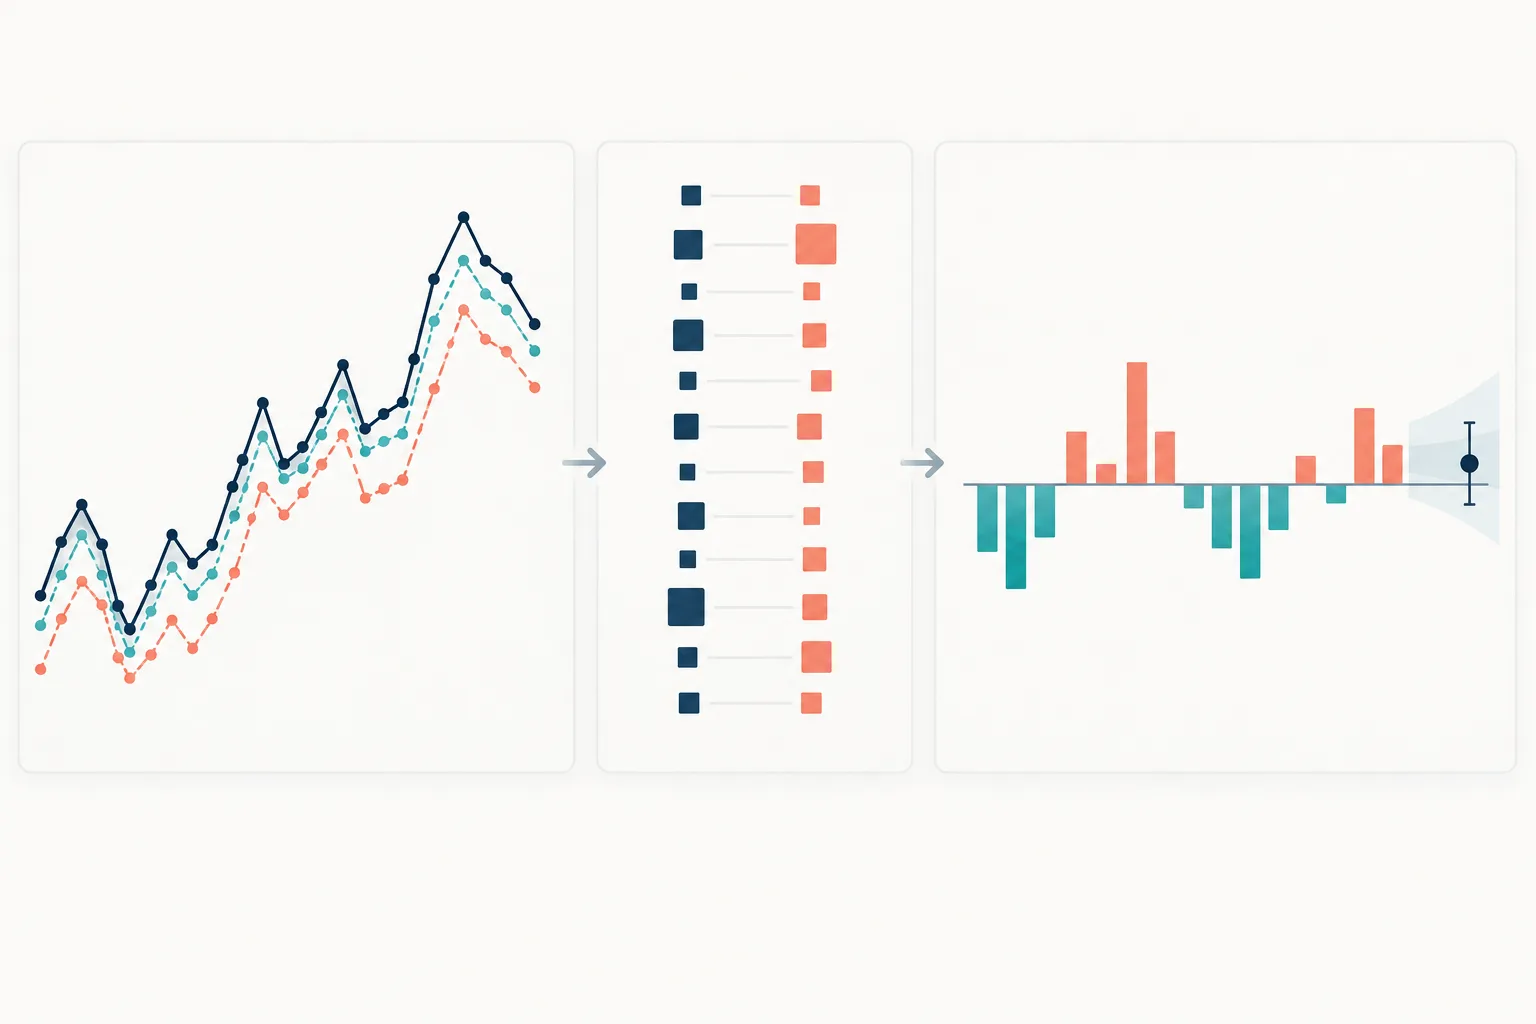
إذا صدرت توقعات يومية لما بعد خمسة أيام، فإن التوقعين المتجاورين يشتركان في أربعة من أيام الهدف الخمسة. لذلك قد تتحرك أخطاؤهما وخسائرهما وفروق الخسارة معًا. والتعامل مع 100 نقطة توقع يومية على أنها 100 مقارنة مستقلة قد يقلل تقدير عدم اليقين ويجعل الإحصائية تبدو أكبر مما ينبغي.
يعالج التباين طويل الأجل التغاير التسلسلي في dₜ. ولهذا يكون تقدير متين شائع للتباين غير المتجانس والارتباط الذاتي (HAC) على الصورة:
Ŝd = γ̂₀ + 2 Σₖ₌₁ᵐ wₖ γ̂ₖ
حيث γ̂ₖ هو التغاير الذاتي للعينة عند الإبطاء k، وwₖ وزن النواة، وm عرض النطاق المختار. يقدّم Newey وWest (1987) مقدّر HAC موجبًا شبه محدد. في أخطاء توقع h خطوات المثالية، وتحت الافتراضات ذات الصلة، قد ينشأ الاعتماد على الأقل حتى الإبطاء h − 1 بسبب التداخل؛ ويناقش إطار DM الأصلي تقديرًا مبتورًا لهذه الحالة. وقد تنشأ في البيانات الفعلية تبعية أطول بسبب استمرار الهدف أو التقدير المتحرك أو بناء الاستراتيجية، لذلك لا يمثل h − 1 قاعدة عامة لاختيار عرض النطاق.
اذكر الأفق والنواة وعرض النطاق وأي تصحيح للعينة الصغيرة. اعرض ما إذا كانت النتائج تتغير تحت إعدادات معقولة للاعتماد بدلًا من اختيار عرض نطاق ينتج قيمة p مرغوبة. إذا تباعدت نقاط الإصدار بما يكفي لتجنب التداخل، فاذكر ذلك واشرح ما فقدته من معلومات أو حجم العينة. تقدير عدم اليقين مع مراعاة الاعتماد جزء من الاختبار، وليس خيارًا لعرض النتائج.
تتطلب النماذج المتداخلة وتغير المهارة بمرور الوقت أسئلة مختلفة
يكون تفسير مقارنة DM المعتادة أبسط عندما لا يكون أحد التوقعين متداخلًا مع الآخر في ظل فرضية تساوي الدقة. فإذا احتوى نموذج أكبر نموذجًا مرجعيًا أصغر، يمكن للمعاملات الإضافية المقدّرة أن تضيف ضوضاء توقع حتى عندما تكون قيمها الحقيقية صفرًا. وقد يكون لتباين متوسط مربعات أخطاء التوقع توزيع غير معياري تحت هذه الفرضية. لمقارنات متوسط مربعات أخطاء التنبؤ خارج العينة بين النماذج المتداخلة، تعالج طريقة مثل تصحيح Clark–West أثر ضوضاء التقدير؛ وهي ليست بديلًا عامًا لاختبار DM في كل تصميم. راجع Clark وWest (2007).
تتعلق فرضية DM المعتادة بمتوسط الخسارة غير المشروطة على كامل عينة التقييم. وقد تخفي تغيرًا زمنيًا: يمكن لـA أن يتفوق في الفترات الهادئة، بينما يتفوق B في فترات التقلب، مع تقارب المتوسطين الإجماليين. وإذا كان السؤال هو ما إذا كانت الدقة النسبية تعتمد على معلومات معروفة عند تاريخ التوقع، فتستخدم اختبارات القدرة التنبؤية المشروطة فروق الخسارة مع أدوات محددة مسبقًا. يطور Giacomini وWhite (2006) هذا الإطار. وتظل افتراضاته وتصميم نافذة التقييم مهمين؛ لذا فإن إضافة مؤشرات اعتباطية بعد فحص النتائج ليست اختصارًا صالحًا.
ينبغي أن يتبع اختيار الاختبار بنية المقارنة: التوقعات المستقلة، أو النماذج المتداخلة، أو المهارة المشروطة المتغيرة، أو مجموعة اختيرت من مرشحين كثيرين ليست حالات قابلة للاستبدال. وللحالة الأخيرة، يشرح دليل White Reality Check وHansen SPA التصحيح على مستوى المجموعة بعد البحث في قواعد تداول عديدة.
انخفاض خسارة التوقع لا يثبت ربحية الاستراتيجية
قد يكون التوقع أدق إحصائيًا من دون أن يحسن نتائج التداول الصافية. إذ يجب تحويله إلى مركز، وتحديد توقيت التداول، وتحمل فروق الأسعار والعمولات والانزلاق وأثر السوق والتمويل والاقتراض وحدود المخاطر. وقد لا يؤثر تحسن طفيف في متوسط خطأ العائد التربيعي في أي قرار مفيد، بينما قد يرصد نموذج ذو خطأ متوسط أعلى قليلًا حدثًا ذيليًا مهمًا لقاعدة معينة على نحو أفضل.
افصل تقييم التوقع عن تقييم المحفظة بوصفهما مرحلتين. اختبر أولًا التوقع على هدف وخسارة يطابقان المهمة المعلنة. ثم قيّم قاعدة تداول محددة بالكامل على بيانات لم تُستخدم لاختيار التوقع، مع افتراضات تنفيذ وتمويل واقعية. فقيمة p لاختبار التوقع ليست عائد اختبار تاريخي أو نسبة شارب أو احتمال ربح مستقبلي.
إن تكرار تجربة نماذج وأهداف وآفاق ودوال خسارة ونوافذ عينات مختلفة ينشئ تحيز اختيار حتى إذا كان كل حساب فردي لاختبار DM صحيحًا. سجّل عملية البحث كاملة واستخدم طريقة تصحح للمجموعة إذا كان السؤال البحثي هو ما إذا كان أي مرشح قد صمد. يشرح دليل إعادة المعاينة بالكتل تقدير عدم اليقين مع الحفاظ على الاعتماد لإحصائية محددة مسبقًا؛ لكنه لا يصحح وحده بحثًا غير موثق في نماذج متعددة.
أبلغ تفاصيل كافية ليتمكن باحث آخر من إعادة التحليل
اذكر اسمي النموذجين وعلاقتهما بالنموذج المرجعي والهدف والأفق وجدول نقاط التوقع وتواريخ التقييم ومجموعة المعلومات وإصدار البيانات وقاعدة العينة المشتركة. عرّف دالة الخسارة رياضيًا، واذكر إن كانت dₜ الموجبة ترجّح A أم B. أبلغ n ومتوسط خسارة كل نموذج وd̄ ومقدّر التباين طويل الأجل ونواة HAC وعرض نطاقها وتصحيح العينة الصغيرة والتوزيع المرجعي واتجاه الاختبار وقيمة p.
اذكر أيضًا إن كان النموذجان متداخلين، وكيف قُدّرت المعلمات، وهل اختيرت المقارنة قبل الاطلاع على النتائج أم بعده، وما النماذج الأخرى التي جُرّبت. إذا استُخدمت العينة لاختيار النموذج، فصنّف الاختبار ضمن ذلك الاختيار بدل وصفه بأنه دليل مستقل خارج العينة. يساعد التقرير الدقيق القراء على معرفة ما تقارنه الإحصائية بالضبط، وما مشكلات عدم اليقين أو الاختيار التي لا يعالجها الاختبار.
أسئلة شائعة
Q1هل يتطلب اختبار ديبولد–ماريانو أن تكون أخطاء التوقع موزعة طبيعيًا؟
لا. يمكن للإطار التعامل مع أخطاء غير طبيعية التوزيع. لكنه يظل بحاجة إلى تقدير ملائم لتباين فروق الخسارة وشروط انتظام تدعم التوزيع المرجعي.
Q2هل يمكنني مقارنة نموذجين يتوقعان أفقين مختلفين؟
لا بوصفها مقارنة متكافئة لدقة التوقع. وحّد الهدف والأفق أولًا؛ وإلا فكل نموذج يجيب عن سؤال توقع مختلف.
Q3هل تكفي نتيجة DM دالة إحصائيًا لاختيار نموذج تداول؟
لا. فهي دليل على اختلاف خسارة التوقع المتوقعة في مقارنة محددة. وتظل بحاجة إلى مراعاة البحث عن النماذج وقواعد القرار وتكاليف التنفيذ والتمويل وأداء الاستراتيجية خارج العينة. الأبحاث الأساسية - Diebold وMariano، “Comparing Predictive Accuracy” (1995) - Harvey وLeybourne وNewbold، “Testing the Equality of Prediction Mean Squared Errors” (1997)00719-4) - Giacomini وWhite، “Tests of Conditional Predictive Ability” (2006) - Clark وWest، “Approximately Normal Tests for Equal Predictive Accuracy in Nested Models” (2007) - Newey وWest، “A Simple, Positive Semi-Definite, Heteroskedasticity and Autocorrelation Consistent Covariance Matrix” (1987)
المصادر والقراءة الإضافية
الإبلاغ عن مشكلة
سنُعدّ رسالة تتضمن رابط هذا المقال. لن يصل البلاغ إلى Mark إلا بعد إرسالها
تحقق سريع
بعد قراءة الدليل، اختبر نفسك في 3 أسئلة
السؤال 01
إذا عُرّف dₜ = L(eA,ₜ) − L(eB,ₜ)، فما الذي ترجّحه قيمة متوسطة موجبة؟
اختر إجابة لرؤية الشرح