

Purged cross-validation en embargo: label-lekkage in tradingmodellen voorkomen
Lees hoe purging en embargo overlappende forward-labels in financiële tijdreeksen aanpakken en verschillen van walk-forward-validatie en CPCV.
In deze gidsWaarom willekeurige K-folds bij financiële data misleidend kunnen zijn
Korte samenvatting
Purged cross-validation verwijdert trainingsobservaties waarvan het werkelijke labelinterval overlapt met dat van een testobservatie. Een embargo is een afzonderlijk vastgelegde buffer voordat latere observaties in splits met post-test-trainingsdata mogen worden gebruikt. Geen van beide is op zichzelf een chronologische simulatie van toekomstig gebruik.
Waarom willekeurige K-folds bij financiële data misleidend kunnen zijn
K-fold verdeelt observaties over folds en gebruikt elke fold om beurten voor testen. Bij financiële tijdreeksen kunnen willekeurige folds afhankelijke waarnemingen of overlappende forward-labels over training en test verdelen. De training bevat dan informatie die samenhangt met testuitkomsten, waardoor prestaties te gunstig kunnen lijken.
Daarom is K-fold niet in elk geval ongeldig. Bij voldoende onafhankelijke observaties en niet-overlappende labels kan het voor een passende vraag bruikbaar zijn. Onderzoek hoe features en labels zijn gemaakt en welke toekomstige situatie de validatie moet schatten. López de Prado bespreekt deze kwesties en purging in hoofdstuk 7 van *Advances in Financial Machine Learning*.
Leg per observatie informatie en labelperiode vast
Neem voor elk sample t als beslismoment. Leg vast welke informatie toen beschikbaar was, welk verleden featurevenster is gebruikt en wanneer de uitkomst wordt bepaald. Een label voor rendement over vijf sessies bestrijkt hier (t, t+5]; t1 is het werkelijke eindtijdstip van het label.
Gedeelde historische featuredata is op zichzelf geen lekkage als die data bij beide beslissingen al bekend was. Lekkage ontstaat wel wanneer een feature toekomstige waarden bevat, achteraf met later beschikbare data is berekend of verkeerd is getimestamped. Features moeten uitsluitend informatie gebruiken die op het voorspeltijdstip beschikbaar was.
Verwijder overlappende labelintervallen uit de training
Purging verwijdert een trainingssample wanneer het werkelijke uitkomstinterval overlapt met dat van een testsample. Controleer de echte begin- en eindtijdstippen van elk label. Bij gebeurtenissen met variabele looptijden gebruik je de werkelijke tijdstempels, niet een handig vast aantal rijen.
Purging maakt een split niet vanzelf chronologisch. Een purged K-fold kan nog steeds observaties na het testblok gebruiken voor training. Dat kan een robuustheidsvraag beantwoorden, maar verschilt van een historische simulatie die alleen op het verleden traint en daarna de toekomst test. De tijdsrichting moet apart worden bepaald.
Behandel het embargo als een aparte buffer
Een embargo is een vastgelegde periode na een testblok voordat latere observaties in splits met post-test-trainingsdata mogen worden opgenomen. Het kan resterende afhankelijkheid door de constructie van events of features verminderen. Het vervangt geen controle van werkelijke labelintervallen en kent geen universeel percentage of vaste duur.
Onderbouw de lengte op basis van samplefrequentie, labelhorizon, featurevensters en waargenomen afhankelijkheid. Leg de regel vast voordat resultaten worden vergeleken. Bij een strikt voorwaartse split zijn er geen observaties na het testblok waarvoor deze embargo-toepassing geldt.
Dagelijks voorbeeld met een horizon van vijf sessies
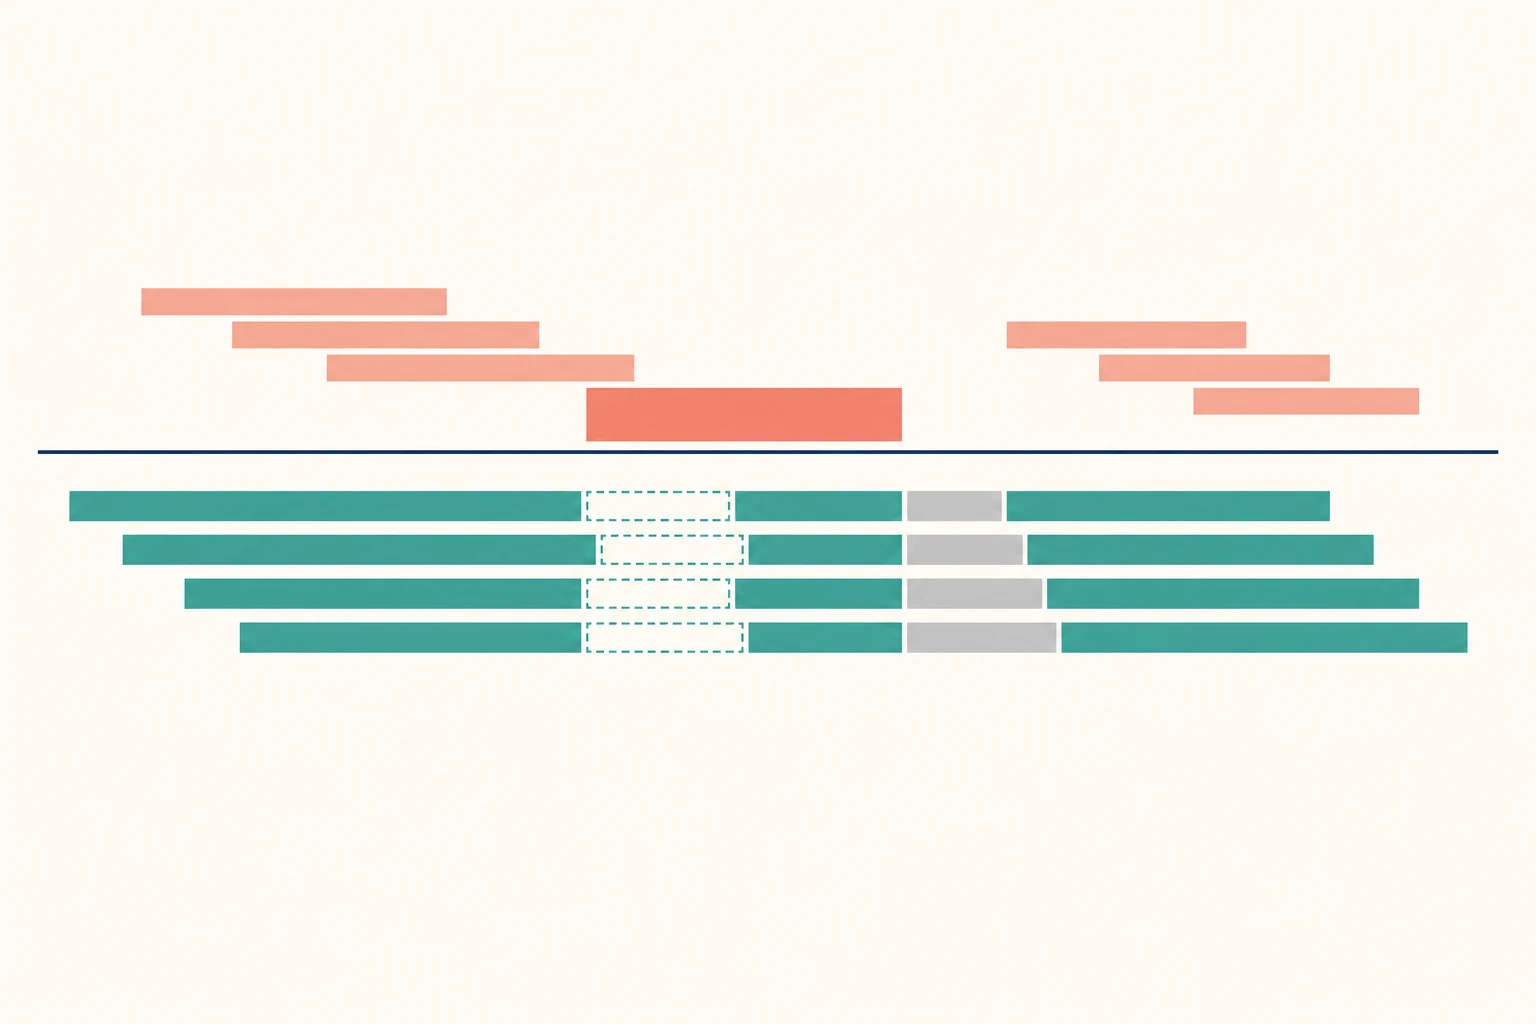
Stel dat beslissingen dagelijks vallen en elk label rendement over de volgende vijf sessies meet: (t, t+5]. Testbeslissingen op dag 11 tot en met 15 hebben labels die doorlopen tot en met dag 20. De dagen zijn sessiedagen en gebruiken overal dezelfde intervalconventie.
Trainingslabel (7,12] overlapt de testlabels, onder meer dat van beslissing dag 11. Ook (16,21] overlapt: het testlabel van dag 15 loopt tot dag 20. Beide trainingssamples worden gepurged. Een later label zonder intervaloverlap kan toch worden uitgesloten door een afzonderlijk gekozen embargozone. Dit voorbeeld bepaalt geen universele tussenruimte.
Onderscheid K-fold, walk-forward, gap, purged K-fold en CPCV
Willekeurige K-folds kunnen perioden mengen. Walk-forward- of rolling-origin-validatie traint op eerdere data en test op een later blok, wat een historische uitrol meestal directer nabootst. De officiële scikit-learn-documentatie voor TimeSeriesSplit beschrijft chronologische splits; voor vergelijkbare testduren moeten observaties gelijkmatig gespreid zijn.
TimeSeriesSplit(gap=...) slaat een vast aantal rijen over voor de test. gap detecteert geen variabele eventintervallen; een rijtelling heeft alleen een begrijpelijke tijdsduur bij geschikte, doorgaans regelmatige, steekproefafstand. Purged K-fold en Combinatorial Purged Cross-Validation (CPCV) maken meerdere testcombinaties of testpaden, maar kunnen trainingsdata na een testblok gebruiken. Dat is niet automatisch dezelfde vraag als een historische walk-forward-simulatie.
Het hoofdstuk 12 over backtesting van López de Prado gaat verder in op walk-forward en CPCV.
Andere bronnen van lekkage blijven mogelijk
Purging verhelpt geen lookahead of verkeerd getimestampte features, survivorship bias of achteraf herziene data. Ook globale normalisatie, imputatie of featureselectie vóór het splitsen kan testinformatie in de training laten lekken. Pas transformaties en selectie binnen elke trainingsfold toe.
Veel modelvarianten proberen vergroot bovendien de kans dat een backtestwinnaar toevallig goed scoort. Bailey en coauteurs behandelen herhaald testen in hun studie over de kans op backtest-overfitting. Gebruik geneste tijdsgebonden validatie voor selectie en reserveer een onaangeroerd chronologisch eindholdout. Neem realistische kosten en fills mee. Cross-validation garandeert geen toekomstige prestaties.
Rapporteer resultaten en onzekerheid
Vermeld samplelengte, frequentie, labelhorizons, featurebeschikbaarheid, splitregel, verwijderde observaties en de onderbouwing van het embargo. Maak duidelijk of latere trainingsrijen zijn gebruikt en welke vraag de methode beantwoordt. Eén totaalscore kan verschillen tussen perioden of testpaden verbergen.
Vergelijk modellen met dezelfde tijdsgrenzen, labels, kostenveronderstellingen en selectieregels. Neem onzekerheid en het aantal geteste varianten mee; kleine verschillen op korte reeksen zijn zwak bewijs. Lees ook bias-variantie en overfitting, multiple testing en false-discovery rate en Sharpe-ratio bij seriële autocorrelatie.
Leg de validatie vast voordat je backtest
Noteer per sample beslismoment t, beschikbare data, featurevenster en werkelijke labelgrenzen tot t1. Kies een split die bij de beoogde gebruiksvraag past. Purge daarna trainingslabels die testintervallen kruisen en bepaal een embargo apart als latere trainingsdata worden gebruikt.
Controleer dat preprocessing binnen elke fold wordt aangepast, documenteer modelevaluaties en kosten, en bewaar een onaangeroerde chronologische holdout. Dit maakt de analyse controleerbaarder, maar maakt verleden geen garantie voor de toekomst. Deze gids beschrijft validatiemechanica en is geen beleggings- of handelsadvies.
Veelgestelde vragen
Q1Is willekeurige K-fold altijd verkeerd voor financiële tijdreeksen?
Nee. Het kan passen bij een vraag met voldoende onafhankelijke observaties en niet-overlappende labels. Bij tijdsafhankelijkheid of forward-labels moet de splitsing de tijdstructuur respecteren.
Q2Maakt een embargo purging overbodig?
Nee. Purging controleert daadwerkelijke overlap van labelintervallen. Een embargo voegt voor bepaalde splits met latere trainingsdata een buffer toe. Beide regels moeten worden onderbouwd.
Q3Vervangt CPCV walk-forward-tests?
Niet vanzelf. CPCV vormt meerdere testcombinaties en paden, maar kan trainen op data na een testblok. Een chronologische historische inzet simuleren blijft een aparte vraag.
Bronnen en verder lezen
Probleem melden
We bereiden een e-mail met de link naar dit artikel voor. Mark ontvangt je melding pas nadat je die verstuurt
Snelle check
De gids gelezen? Test jezelf met 3 vragen
Vraag 01
Welke trainingsobservatie moet door purging worden verwijderd?
Kies een antwoord om de uitleg te zien
Optiewoordenlijst
The relationship between systematic prediction error from model mismatch and instability caused by sensitivity to the training sample.
Lees de uitgebreide gidsFamily-wise error rateThe probability of falsely rejecting at least one true null hypothesis within a predefined family of tests.
Lees de uitgebreide gidsAssignmentThe process that requires an option writer to fulfill the contract after an exercise notice is allocated; it can create or remove an underlying position.
Lees de uitgebreide gids