

Purged Cross-Validation und Embargo: Label-Leakage in Trading-Modellen vermeiden
Erfahren Sie, wie Purging und Embargo überlappende Forward-Labels in Finanzzeitreihen behandeln und wie sie sich von Walk-Forward-Validierung und CPCV unterscheiden.
In diesem LeitfadenWarum zufällige K-Folds bei Finanzdaten irreführen können
Kurze Zusammenfassung
Purged Cross-Validation entfernt Trainingsbeobachtungen, deren tatsächliche Label-Zeiträume die Label-Zeiträume eines Testblocks überschneiden. Ein Embargo ist ein separat festgelegter Puffer vor späteren Trainingsbeobachtungen, wenn ein Split auch Daten nach dem Testblock zum Trainieren verwendet. Beides beantwortet eine andere Frage als eine chronologische Simulation des späteren Einsatzes.
Warum zufällige K-Folds bei Finanzdaten irreführen können
K-Fold teilt Beobachtungen in Folds auf und verwendet abwechselnd einen Fold zum Testen. Bei Finanzzeitreihen können zufällige Folds jedoch abhängige Beobachtungen und sich überschneidende Forward-Labels auf Trainings- und Testseite verteilen. Das Modell erhält dann indirekt Informationen über Ergebnisse, die mit dem Testzeitraum überlappen, und die gemessene Güte kann zu optimistisch wirken.
Das macht K-Fold nicht für jeden Datensatz grundsätzlich falsch. Wenn Beobachtungen hinreichend unabhängig sind und keine zeitlich überlappenden Ziele erzeugen, kann es für eine passende Fragestellung sinnvoll sein. Entscheidend ist, wie Merkmale und Labels entstehen und welche zukünftige Nutzung die Validierung abbilden soll. López de Prado behandelt diese Probleme und Purging in Kapitel 7 von *Advances in Financial Machine Learning*.
Für jede Beobachtung den Informations- und Labelzeitraum festlegen
Für jede Stichprobe sei t der Entscheidungszeitpunkt. Dokumentieren Sie, welche Informationen zu diesem Zeitpunkt tatsächlich verfügbar waren, welches vergangene Fenster die Merkmale verwenden und wann das Ziel aufgelöst wird. Ein Label für die Rendite der nächsten fünf Handelssitzungen umfasst hier (t, t+5]; t1 bezeichnet seinen tatsächlichen Auflösungszeitpunkt.
Gemeinsam genutzte vergangene Merkmalsdaten sind allein noch kein Leakage: Zwei Vorhersagen dürfen dieselben historischen Preise verwenden, wenn diese Preise bei beiden Entscheidungen bekannt waren. Leakage entsteht etwa, wenn ein Merkmal nachträglich berechnet wird, künftige Werte enthält oder falsch zeitgestempelt ist. Merkmalsbildung muss strikt auf den Informationsstand zum jeweiligen Vorhersagezeitpunkt begrenzt bleiben.
Überlappende Labelintervalle aus dem Training entfernen
Purging entfernt eine Trainingsstichprobe, wenn ihr tatsächliches Ergebnisintervall das Ergebnisintervall einer Teststichprobe überschneidet. Prüfen Sie dafür Beginn und Ende des jeweiligen Ereignis-Labels. Bei variablen Ereignisdauern sind die tatsächlichen Zeitstempel maßgeblich, nicht eine bequeme feste Zahl von Zeilen.
Purging macht einen Split nicht automatisch chronologisch. Ein purged K-Fold kann weiterhin Beobachtungen nach dem Testblock zum Trainieren heranziehen. Das kann für bestimmte Robustheitsfragen nützlich sein, schätzt aber eine andere Situation als „nur Vergangenheit trainiert, danach Zukunft getestet“. Die Zeitrichtung muss separat aus dem Split-Design hervorgehen.
Ein Embargo als eigenen Puffer begründen
Ein Embargo ist ein separat definierter Zeitraum nach einem Testblock, bevor spätere Beobachtungen in einem Split mit nachfolgendem Training als Trainingsdaten zugelassen werden. Es kann verbleibende Abhängigkeit aus Ereignis- oder Merkmalskonstruktion reduzieren. Es ersetzt keine Prüfung der tatsächlichen Labelintervalle und ist weder ein universeller Prozentsatz noch eine allgemeingültige Dauer.
Begründen Sie die Länge anhand der Abtastfrequenz, des Labelhorizonts, der Merkmalsfenster und der beobachteten Abhängigkeit. Legen Sie die Regel vor dem Ergebnisvergleich fest und dokumentieren Sie sie. Wenn es keine späteren Trainingsbeobachtungen gibt, wie in einem strikt vorwärts gerichteten Split, ist genau dieser Anwendungsfall des Embargos nicht gegeben.
Ein Tagesbeispiel mit fünf Sitzungstagen
Angenommen, Entscheidungen fallen täglich und jedes Label misst die Rendite über (t, t+5]. Ein Testblock mit Entscheidungsdaten 11 bis 15 enthält damit Labelzeiträume bis einschließlich Tag 20. Die Grenzen sind hier als Sitzungstage und nach derselben Intervallkonvention definiert.
Ein Trainingslabel (7,12] überschneidet den Testzeitraum, weil es mit dem Testlabel für Entscheidungstag 11 gemeinsame Tage hat. Auch (16,21] überschneidet ihn: Das Testlabel für Tag 15 reicht bis Tag 20. Beide Trainingsstichproben werden purged. Ein späteres Label ohne Intervallüberschneidung kann dennoch außerhalb einer separat gewählten Embargo-Zone liegen. Aus diesem Beispiel folgt keine universelle Lückenlänge.
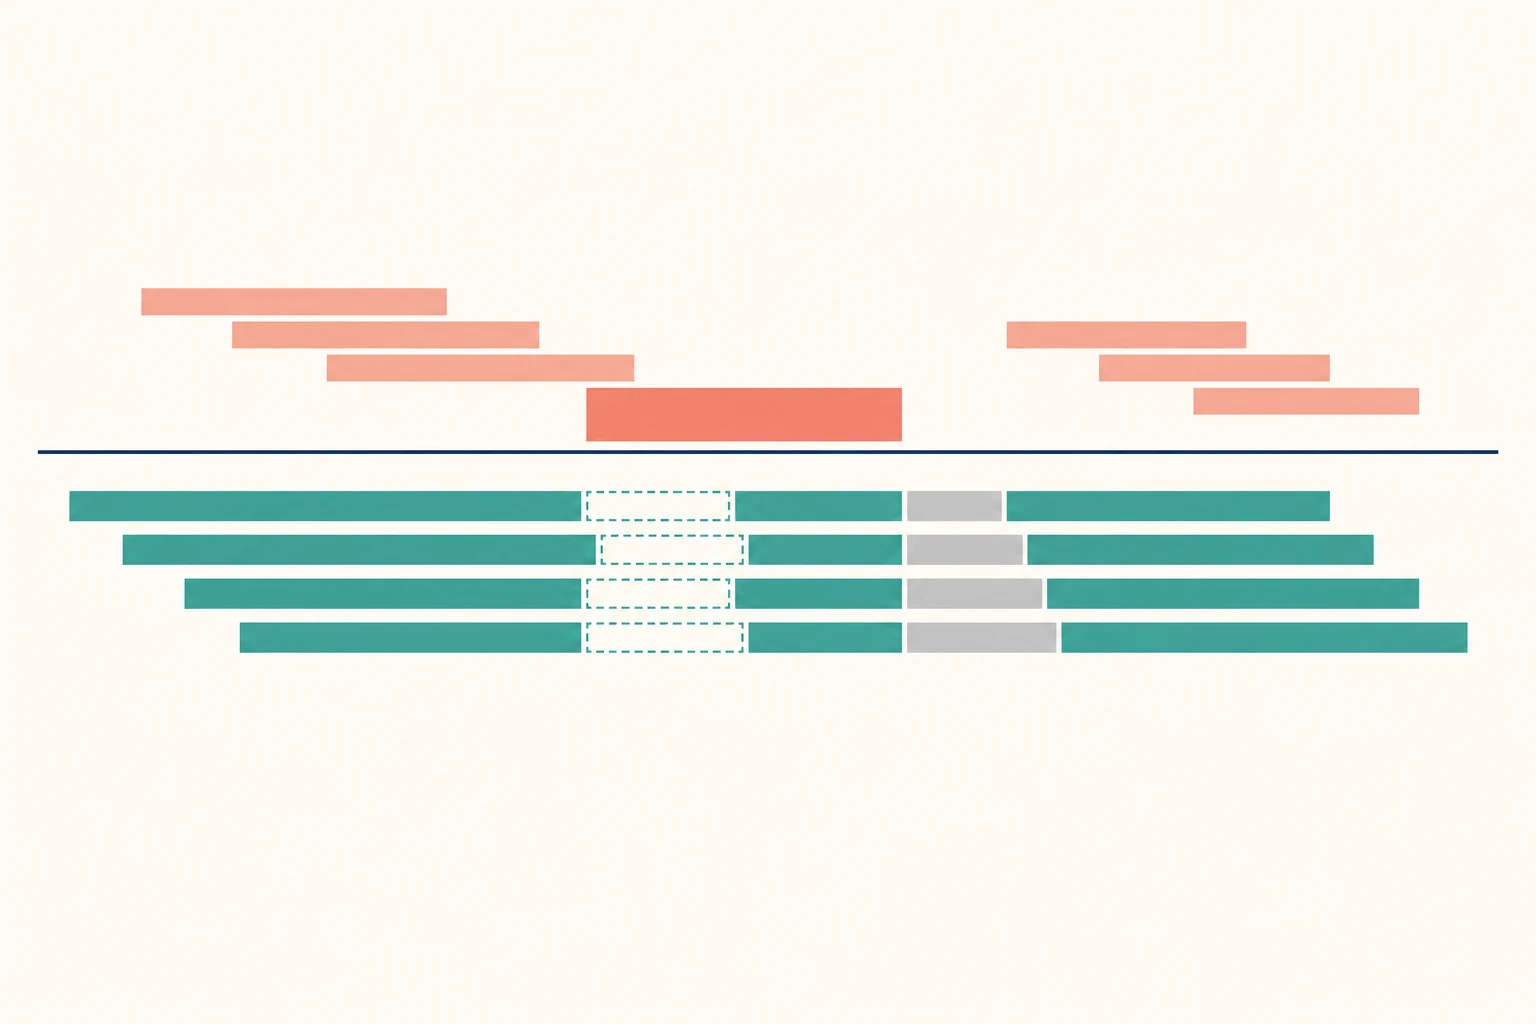
Random K-Fold, Walk-Forward, gap, Purged K-Fold und CPCV unterscheiden
Random K-Fold kann Beobachtungen aus verschiedenen Zeitabschnitten mischen. Walk-Forward- oder Rolling-Origin-Validierung trainiert dagegen auf früheren Daten und testet auf einem späteren Block; sie bildet einen historischen Einsatzablauf meist direkter ab. Die offizielle scikit-learn-Dokumentation zu TimeSeriesSplit beschreibt chronologische Splits und verlangt gleichmäßig verteilte Beobachtungen, wenn Testfolds vergleichbare Zeitdauern haben sollen.
TimeSeriesSplit(gap=...) lässt eine feste Anzahl von Beobachtungszeilen vor dem Test aus. gap ist kein Purger für variable Ereignisintervalle; eine Zeilenanzahl entspricht nur bei geeigneter, typischerweise gleichmäßiger Abtastung einer nachvollziehbaren Zeitlücke. Purged K-Fold und Combinatorial Purged Cross-Validation (CPCV) bilden mehrere Testkombinationen beziehungsweise Testpfade, können aber auch nach einem Testblock liegende Trainingsdaten enthalten. Sie beantworten deshalb nicht automatisch dieselbe Frage wie eine historische Walk-Forward-Simulation.
López de Prados Kapitel 12 zu Backtesting behandelt Walk-Forward-Verfahren und CPCV ergänzend.
Weitere Leckagequellen bleiben bestehen
Korrektes Purging verhindert weder Lookahead in falsch zeitgestempelten Merkmalen noch Survivorship Bias oder nachträglich revidierte Daten. Auch globale Standardisierung, Merkmalsauswahl oder Imputation vor der Aufteilung kann Testinformationen ins Training übertragen. Passen Sie Vorverarbeitung und Auswahl innerhalb jedes Trainingsfolds an.
Viele ausprobierte Modelle erhöhen zudem das Risiko, zufällig einen Backtest-Sieger zu finden. López de Prado behandelt für die Auswahl zeitbewusste Verfahren; Bailey und Mitautoren erläutern in ihrer Arbeit zur Probability of Backtest Overfitting die Gefahr mehrfacher Strategieversuche. Nutzen Sie verschachtelte zeitbewusste Validierung für die Auswahl und halten Sie einen unangetasteten chronologischen Schlusszeitraum zurück. Realistische Kosten und Fills müssen ebenfalls modelliert werden. Kein CV-Verfahren garantiert künftige Performance.
Ergebnisse und Unsicherheit nachvollziehbar berichten
Berichten Sie Stichprobenlänge, Zeitfrequenz, Labelhorizonte, Feature-Verfügbarkeit, Split-Regel, entfernte Beobachtungen und Embargo-Begründung. Zeigen Sie, ob spätere Trainingszeilen erlaubt waren und welche Frage das Verfahren beantworten soll. Eine einzige aggregierte Kennzahl kann starke Unterschiede zwischen Zeiträumen oder Testpfaden verdecken.
Vergleichen Sie Modelle mit denselben Zeitgrenzen, Labels, Kostenannahmen und Auswahlregeln. Berücksichtigen Sie die Unsicherheit der Kennzahl und die Zahl der getesteten Varianten; kleine Unterschiede sind bei kurzen Datenreihen oft wenig belastbar. Weiterführend: Bias-Varianz-Abwägung und Overfitting, Multiple Testing und False-Discovery-Rate sowie Sharpe Ratio bei serieller Korrelation.
Eine Validierung vor dem Backtest festlegen
Erfassen Sie pro Stichprobe Entscheidungszeit t, verfügbare Daten, Feature-Fenster und tatsächliche Labelgrenzen bis t1. Wählen Sie dann eine Aufteilung, die zur Einsatzfrage passt, und entfernen Sie mit Purging jedes Trainingslabel, das ein Testlabelintervall schneidet. Legen Sie ein Embargo nur für den passenden Split-Fall separat fest.
Prüfen Sie anschließend die Vorverarbeitung innerhalb der Folds, dokumentieren Sie Modellversuche und Gebührenannahmen und reservieren Sie einen unangetasteten chronologischen Holdout. Diese Schritte machen den Backtest nachvollziehbarer; sie machen vergangene Daten nicht zu einer Garantie für zukünftige Ergebnisse. Dieser Leitfaden erklärt Validierungsmechanik, nicht die Auswahl einer Anlage oder Handelsstrategie.
Häufige Fragen
Q1Ist zufälliges K-Fold für Finanzzeitreihen immer falsch?
Nein. Es kann für eine Fragestellung mit hinreichend unabhängigen Beobachtungen und nicht überlappenden Labels passen. Bei abhängigen Zeitreihen oder Forward-Labels muss die Split-Regel jedoch die zeitliche Struktur berücksichtigen.
Q2Macht ein Embargo Purging überflüssig?
Nein. Purging prüft tatsächliche Überschneidungen der Labelintervalle. Ein Embargo ist ein zusätzlicher Puffer für bestimmte Splits mit späteren Trainingsbeobachtungen. Beide Regeln brauchen eine dokumentierte Begründung.
Q3Ist CPCV ein Ersatz für Walk-Forward-Tests?
Nicht automatisch. CPCV erzeugt mehrere Testkombinationen und Pfade, kann aber Trainingsdaten nach einem Testblock einsetzen. Für die Simulation eines historischen Einsatzes ist eine chronologische, nur aus der Vergangenheit trainierende Prüfung weiterhin eine eigene Fragestellung.
Quellen und weiterführende Lektüre
Problem melden
Wir bereiten eine E-Mail mit dem Link zu diesem Artikel vor. Mark erhält den Hinweis erst nach dem Senden
Schnelltest
Fertig gelesen? Prüfe dich mit 3 Fragen
Frage 01
Welche Trainingsbeobachtung sollte beim Purging entfernt werden?
Wähle eine Antwort, um die Erklärung zu sehen
Optionsglossar
The relationship between systematic prediction error from model mismatch and instability caused by sensitivity to the training sample.
Detaillierten Leitfaden lesenFamily-wise error rateThe probability of falsely rejecting at least one true null hypothesis within a predefined family of tests.
Detaillierten Leitfaden lesenModel riskThe risk that model structure, data, parameters, numerics, or misuse causes valuation, sensitivity, or hedging results to differ materially from reality.
Detaillierten Leitfaden lesen